

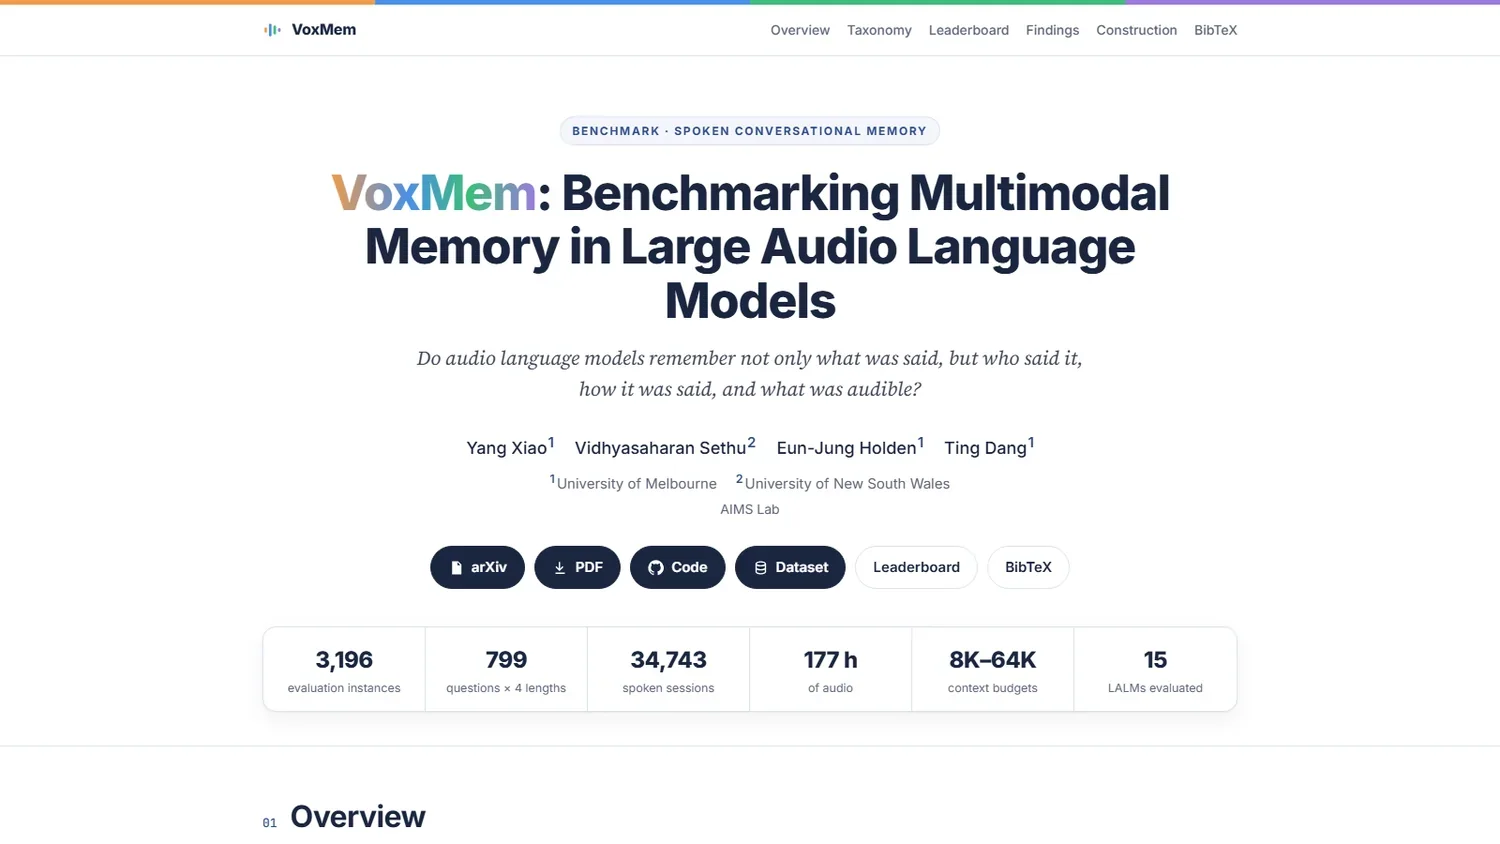
VoxMem是墨尔本大学与新南威尔士大学团队于2026年9月开源的音频大模型记忆评测基准,主要用于检验大型音频语言模型能否跨会话记住语音里说过什么、谁说的、怎么说的,以及当时能听到什么。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 音频大模型记忆评测基准 |
| 推出团队 | 墨尔本大学与新南威尔士大学 |
| 发布时间 | 2026年9月26日 |
| 评测规模 | 3,196 个实例 / 34,743 段会话 |
| 历史长度 | 8K 至 64K token 四档 |
| 分类框架 | 4 类声学证据 × 4 种记忆操作 |
| 开源许可 | 代码 MIT,数据 CC BY-NC |
| 评测对象 | 15 个大型音频语言模型 |
| 资源获取 | GitHub 代码与 Hugging Face 数据 |
VoxMem 的核心能力
语音助手在多会话场景里最难的并不是听懂一句话,而是隔一段时间之后仍能识别说话人、当时的语气是什么样。VoxMem 把这类能力拆成可测量的维度。理解这类评测的设计思路,可以先了解 大语言模型 的记忆与上下文机制。
多会话语音记忆评测
在多会话、跨时长的语音历史设置下,基准检验大型音频语言模型能否记住并回溯此前的对话内容。与单段长独白不同,历史由若干个相隔一段时间的会话拼成,更接近真人机语音交互的形态。
四类声学证据覆盖
基准同时考察语音语义、说话人身份、副语言线索与环境声四类信息。后三类只存在于音频信号里,一旦转写成文字就会丢失,正是当前语音助手容易忽略的部分。要理解被评测一方的处理方式,可以参考 Qwen-Audio 这类音频语言模型的做法。
四种记忆操作分类
记忆操作被拆为信息抽取、多会话推理、时序演变追踪与证据不足时拒答四类。两者交叉后形成 15 个有效评测单元格,「语义 × 信息抽取」因退化为纯文本检索而被有意排除。
受控历史长度
同一道题在 8K、16K、32K、64K 四种历史长度下证据完全不变,只增加无关的填充会话。这样准确率的变化只能归因于历史变长,而不是题目难度混杂带来的干扰。
开放评测体系
代码与数据全部开源,提供标准化的运行脚本、评分脚本与榜单,既支持接入 API 模型,也支持在本地模型上复现。团队同时保留带线索与去除线索的配对版本用于质检。
VoxMem 与同类基准的对比
下表从评测模态、证据类型与历史长度等维度,对比两个常被放在一起评估的记忆类基准。
| 对比维度 | VoxMem | LongMemEval |
|---|---|---|
| 评测模态 | 音频原生,用户轮次为语音 | 纯文本 |
| 评测对象 | 大型音频语言模型 | 语言模型记忆系统与长上下文模型 |
| 历史长度 | 8K 至 64K 音频 token,同一题四档证据不变 | 以单档长历史为主 |
| 证据类型 | 语义、说话人、副语言、环境声四类 | 仅词汇语义 |
| 记忆操作 | 抽取、跨会话推理、时序追踪与拒答,共 15 个单元格 | 抽取、多会话推理、时序、知识更新与拒答 |
| 干扰设计 | 话题相近的干扰会话叠加长度嵌套控制 | 动态构建的聊天历史 |
| 核心发现 | 32K 下无模型整体准确率超过 40% | 模型在知识更新与长历史检索上明显落后 |
| 开源情况 | 代码 MIT,数据 CC BY-NC | 公开基准 |
上表 VoxMem 一列取自其论文与项目说明,LongMemEval 一列取自其公开基准资料。两者的差别首先在模态:VoxMem 把说话人、语气与环境声当作必须记住的证据,LongMemEval 考察的仍是文字层面的记忆。其次是变量控制,VoxMem 让同一道题在四个历史长度下保持证据不变,能单独剥离长度的影响。选型时可以先明确要解决的问题是「记住说了什么」还是「记住谁说的、怎么说的」,这决定了该用哪一类基准。
如果想了解这类基准所评测的音频模型长什么样,可以参考 StepAudio 3(阶跃星辰推出的语音大模型系列,与 VoxMem 的评测对象同属大型音频语言模型,区别在于前者是待测模型、后者是评测基准)。
VoxMem 的应用场景与适用人群
把语音记忆拆成可测维度之后,常见用途包括:
- 语音助手与智能音箱选型:用统一口径测试候选模型能否跨会话记住用户偏好、家庭成员的声音与之前的承诺,避免上线后再出现说过就忘的情况。
- 车载与可穿戴语音交互评测:车内环境声嘈杂、用户语气多变,基准的环境声与副语言维度可以检验模型在真实噪声场景下的记忆可靠性。
- 多说话人客服与会议系统质检:客服中心与会议纪要把「哪句话是谁说的」绑定正确很关键,基准的说话人维度可用于诊断张冠李戴类问题。
- 陪伴机器人情绪记忆验证:老人上周说的事与语气里的疲惫,只有副语言线索能承载,基准的时序追踪维度可用于检验产品能否察觉状态变化。
适用人群:评估语音交互产品的算法团队与产品团队、做音频大模型研究的实验室,以及需要为智能音箱与车载语音选型的工程人员。基准本身不提供可直接上线的模型,实际部署前仍需要结合自家场景做补充评测。
VoxMem 的使用方法
从克隆仓库到得到评分结果,可按以下步骤操作:
- 克隆仓库:执行
git clone https://github.com/swagshaw/voxmem并进入项目目录。 - 安装依赖:运行
pip install -r requirements.txt,如需音频自动解码为数组可另装datasets。 - 配置密钥:评测 API 模型时安装对应 SDK 并设置密钥,例如安装
openai后设置OPENAI_API_KEY。 - 冒烟测试:先用
run_voxmembench.py指定小规模配置与拒答模型跑一轮,再用score_voxmembench.py评分,确认拒答层在拒答题上得分正确。 - 正式评测:选择目标配置与模型运行,例如以
32k完整集配合 API 模型;本地模型需要指定自定义适配函数与权重目录。 - 裁判评分:用评分脚本指定裁判模型,裁判只读取问题、标准答案与回答,判定开放式答案的等价性并输出指标文件。官方项目地址见 VoxMem 官方仓库。
建议先在小规模子集上验证环境与评分链路,确认拒答层与裁判模型的行为符合预期,再运行完整测试集;不同模型的音频预处理方式存在差异,接入本地模型时应先核对采样率与声道处理是否一致。
VoxMem 的价格与开源情况
VoxMem 的评测代码以 MIT 许可开源,数据部分采用 CC BY-NC 许可,代码与数据都可以在 GitHub 与 Hugging Face 上获取。使用数据做商业用途前需要先确认 CC BY-NC 的非商业条款是否适用于自身场景,代码部分则相对宽松。
基准本身不收取费用,成本主要来自评测过程:运行完整测试集需要调用模型算力或 API,规模较大的模型还会带来可观的显存与时间开销。正式评测前建议先用小规模子集估算单轮成本。
VoxMem 的常见问题
VoxMem 评测的是什么?
评测大型音频语言模型在多会话语音历史中的记忆能力,覆盖语义、说话人身份、副语言线索与环境声四类声学证据,以及信息抽取、跨会话推理、时序追踪与拒答四类操作。
VoxMem 的代码和数据可以商用吗?
评测代码采用 MIT 许可,数据部分采用 CC BY-NC 许可。代码使用相对宽松,数据用于商业场景前需要先确认非商业条款是否适用。
VoxMem 的评测结论是什么?
在 32K 上下文长度下,参与评测的 15 个模型整体准确率都没有超过 40%,模型对语义的记忆明显强于对说话人、语气与环境声的记忆,说明单靠延长音频上下文难以实现持久语音交互。
相关文章


 浙公网安备33010202004812号