
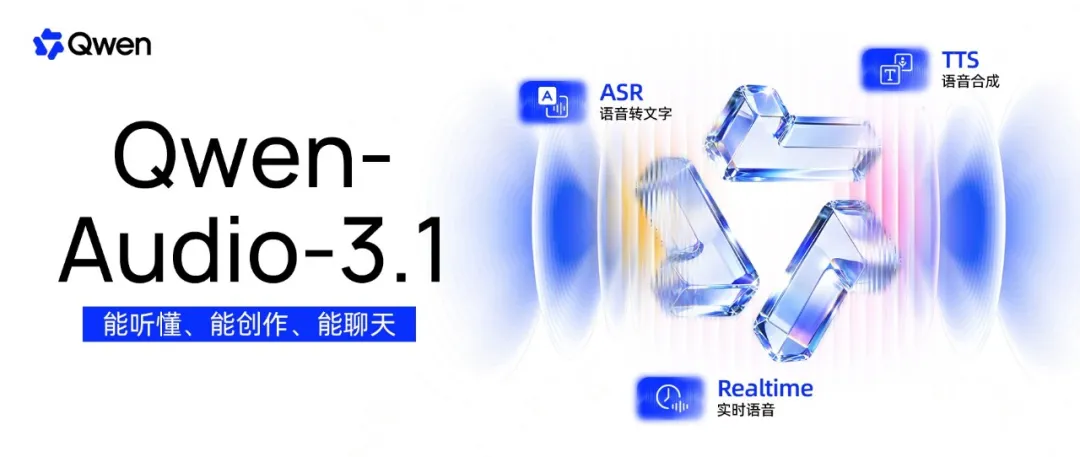
Qwen-Audio-3.1是阿里通义于2026年9月推出的语音大模型系列,主要用于语音识别、语音合成、实时语音交互与音频创作,支持30种语言与16种中文方言识别以及全双工实时对话,适用于会议与访谈转写、跨语言沟通、有声内容制作与智能硬件语音交互场景。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 识别、合成、交互与创作的语音模型系列 |
| 出品方 | 阿里通义 |
| 发布时间 | 2026年9月23日 |
| 模型组成 | ASR、ASR-Next、TTS 等五款 |
| 语言与方言 | 30种语言、16种中文方言 |
| 音频输出 | 48kHz,支持细粒度时间戳控制 |
| 价格调整 | 全线下调,ASR 最高降95% |
| 可用平台 | 千问AI 平台,ASR-Next 即将上线 |
| 开放情况 | 以 API 调用为主,未开放模型权重 |
Qwen-Audio-3.1 的核心能力
该系列由五款模型分工承担识别、理解、合成、创作与交互,构成一套覆盖完整链路的语音能力栈。与上一代相比,变化集中在两处:识别侧把多语种、方言与上下文润色合并进单一模型,创作侧把语音合成扩展为通用音频生成。对以 AI 智能体 为入口的产品而言,识别与合成是否同栈,直接影响对话链路的延迟。
多语种与中文方言识别
Qwen-Audio-3.1-ASR 一套模型支持 30 种语言与 16 种中文方言,官方给出的首字响应约 160 毫秒。在 KeSpeech 与 WSYue 共 11 个子集的开源方言评测中,其平均字错误率(CER)为 4.55%,在 6 个子集上取得最优;在自建的中文方言测试集上平均 CER 为 10.38%,11 个方言子集均取得最优,其中温州话等较难方言的提升更为明显。
分角色转写与原生润色
模型以端到端方式联合输出说话人标签、时间戳与文本,既能处理轮流发言,也能保留短插话与重叠语音。新增的转写润色由模型原生完成,可自动去除语气词与重复表达、执行自我纠正并重组语义,同时支持行业词、专业实体与分级热词识别。
音频理解扩展到泛音频
同批发布的 Qwen-Audio-3.1-ASR-Next 面向音频理解,可识别情绪、环境声与机械声,完成声音描述、事件定位、音频问答与推理。面对同时包含对话、背景音乐与环境声的音频,模型除输出对话文本外,还能说明其中包含哪些声音、事件发生在何时。在多人语音的分角色识别评测中,四个测试集八项指标里,ASR-Flash-Next 与 ASR-Flash 分获五项与三项最优。
跨语言音色合成与音频创作
Qwen-Audio-3.1-TTS 支持多语种与方言合成,并在同一音色跨语言合成时保持自然迁移,可通过指令控制情绪、语速与表达方式。音频创作模型 Qwen-Audio-3.1-TTS-Next 则围绕文本、时间戳与参考音频等输入,统一生成人声、音效与环境音,支持多人音色复刻与多轮对话生成,并输出最高 48kHz 音频与细粒度时间戳控制。
全双工实时交互与工具调用
Qwen-Audio-3.1-Realtime 支持全双工交互,可在说话的同时持续听取,并允许用户随时插话与打断;对话中切换语言时,模型会保留此前的上下文、语气与节奏。模型基于多教师蒸馏架构在保持低延迟的前提下提升理解与表达,并可在实时对话中调用工具,连接 API、知识库与业务系统完成查询或任务执行。
Qwen-Audio-3.1 与同类语音大模型的对比
| 对比维度 | Qwen-Audio-3.1 | StepAudio 3 | Voxtral Transcribe 2 |
|---|---|---|---|
| 开发方 | 阿里通义 | 阶跃星辰 | Mistral AI |
| 产品形态 | 识别、合成、交互与创作的五款模型 | 五款语音模型系列 | 语音转写模型家族 |
| 语言与方言 | 30 种语言、16 种中文方言 | 中英方言与中英混说 | 13 种语言 |
| 参数规模 | 官方未公开 | Realtime 约 196B 总参、11B 激活 | Realtime 4B |
| 开源程度 | 未开放模型权重 | 暂未开源 | Realtime 权重 Apache 2.0 开源 |
| 关键成绩 | 方言开源集平均 CER 4.55%,方言翻译语义句准率 82.10% | ASR 非流式 WER 1.7% | FLEURS 约 4% WER |
| 音频创作 | TTS-Next 一次生成人声、音效与环境音 | 覆盖语音与音乐创作 | 不涉及 |
| 实时交互 | 全双工,可插话打断并调用工具 | 支持实时交互 | 侧重批量转写与字幕 |
| 价格模式 | 全线下调,ASR 最高降 95% | TTS 每万字符 2.5 元起 | 批量版 0.003 美元/分钟 |
上表中 Qwen-Audio-3.1 一列取自阿里通义官方发布材料,StepAudio 3 一列取自阶跃星辰官方发布材料,Voxtral Transcribe 2 一列取自 Mistral AI 官方文档。三条路线的分工差异较直接:Qwen-Audio-3.1 以五款模型覆盖从识别到音频创作的完整链路,并把方言能力作为识别侧重点;StepAudio 3 同样以系列化方式覆盖识别、合成与实时交互;Voxtral Transcribe 2 以开源实时版权重与按分钟计费切入批量转写与字幕场景。参数规模上,前两者均未完整公开推理侧体量,Voxtral Transcribe 2 的实时版为 4B。
需要对比上一代实时交互能力的用户,可参考 Qwen-Audio-3.0-Realtime(阿里通义上一代实时语音交互模型,可作为版本迭代前后的对照基线)。
Qwen-Audio-3.1 的应用场景与适用人群
该系列面向需要把语音能力接入实际业务的团队,常见场景包括:
- 会议与访谈转写:联合输出说话人标签、时间戳与文本,并自动去除语气词与重复表达。
- 跨语言沟通与同传:一套模型覆盖 30 种语言,方言翻译平均语义句准率 82.10%。
- 有声内容制作:TTS-Next 一次生成人声、音效与环境音,支持多人音色复刻与 48kHz 输出。
- 实时语音交互产品:全双工对话支持插话打断,并在通话中调用业务系统完成办理。
- 智能硬件语音入口:官方已公布与 AI 眼镜等硬件的结合案例,用户可脱离手机发起任务。
适用人群:需要批量处理会议与访谈音视频的企业团队、制作播客与有声书的音频创作者、开发实时语音交互产品的工程团队,以及为智能硬件配置语音入口的硬件厂商。涉及专业术语的场景,建议先整理热词表再接入。
Qwen-Audio-3.1 的使用方法
五款模型的接入路径相近,可按以下步骤开始:
- 查阅官方说明:在 Qwen-Audio-3.1 官方模型页 确认各模型的额度、并发限制与计费单位,再挑选需要接入的模型。
- 开通与取用密钥:在千问 AI 平台完成开通流程,获取调用密钥后按模型名区分接口。
- 接入识别链路:先以离线音频验证转写质量,再切换到低延迟流式接口,观察首字响应与断句效果。
- 接入合成与创作链路:合成场景确认音色与情绪控制参数,需要完整音频时改用 TTS-Next,并通过时间戳参数安排对白起止与声音事件顺序。
- 灰度与验收:实时交互先以只读任务验证打断响应与工具调用,再放开写操作,并跟踪识别准确率、端到端延迟与单次调用成本三项指标。
工程实践上,建议把识别、理解与合成分阶段压测,避免把链路问题误判为模型能力问题;价格调整后相同预算可覆盖的调用量明显上升,接入时应把计价单位折算为每千小时音频成本后再做容量规划。
Qwen-Audio-3.1 的价格与开源情况
Qwen-Audio 全线语音模型在本次发布中同步下调,其中 TTS 降幅约 70%、Realtime 约 85%、ASR 达 95%。五款模型的 API 均已上架千问 AI 平台,按实际调用形态分别计费:实时交互按音频输入计费,识别与合成按音频时长或字符量计费。对以长音频为主的转写业务来说,ASR 的降幅直接决定单小时音频的处理成本。
该系列未开放模型权重,仅通过千问 AI 平台以 API 方式提供,自托管部署不在可选范围内。其中 ASR-Next 的 API 官方标注为即将上线,接入计划需预留切换窗口;TTS-Next 输出为最高 48kHz 的完整音频,与常规语音合成的定价口径并不相同,需单独归集。
Qwen-Audio-3.1 的常见问题
Qwen-Audio-3.1 包含哪几款模型?
共五款:语音识别 ASR 与音频理解 ASR-Next,语音合成 TTS 与音频创作 TTS-Next,以及实时语音交互 Realtime。
Qwen-Audio-3.1 支持哪些语言和方言?
一套模型支持 30 种语言与 16 种中文方言,首字响应约 160 毫秒;方言翻译在自建测试集上的平均语义句准率为 82.10%。
Qwen-Audio-3.1 怎么收费?
全线语音模型价格在此次发布中同步下调,TTS 降幅约 70%、Realtime 约 85%、ASR 达 95%,API 均上架千问 AI 平台,按各自的计价单位分别结算。
相关文章


 浙公网安备33010202004812号