
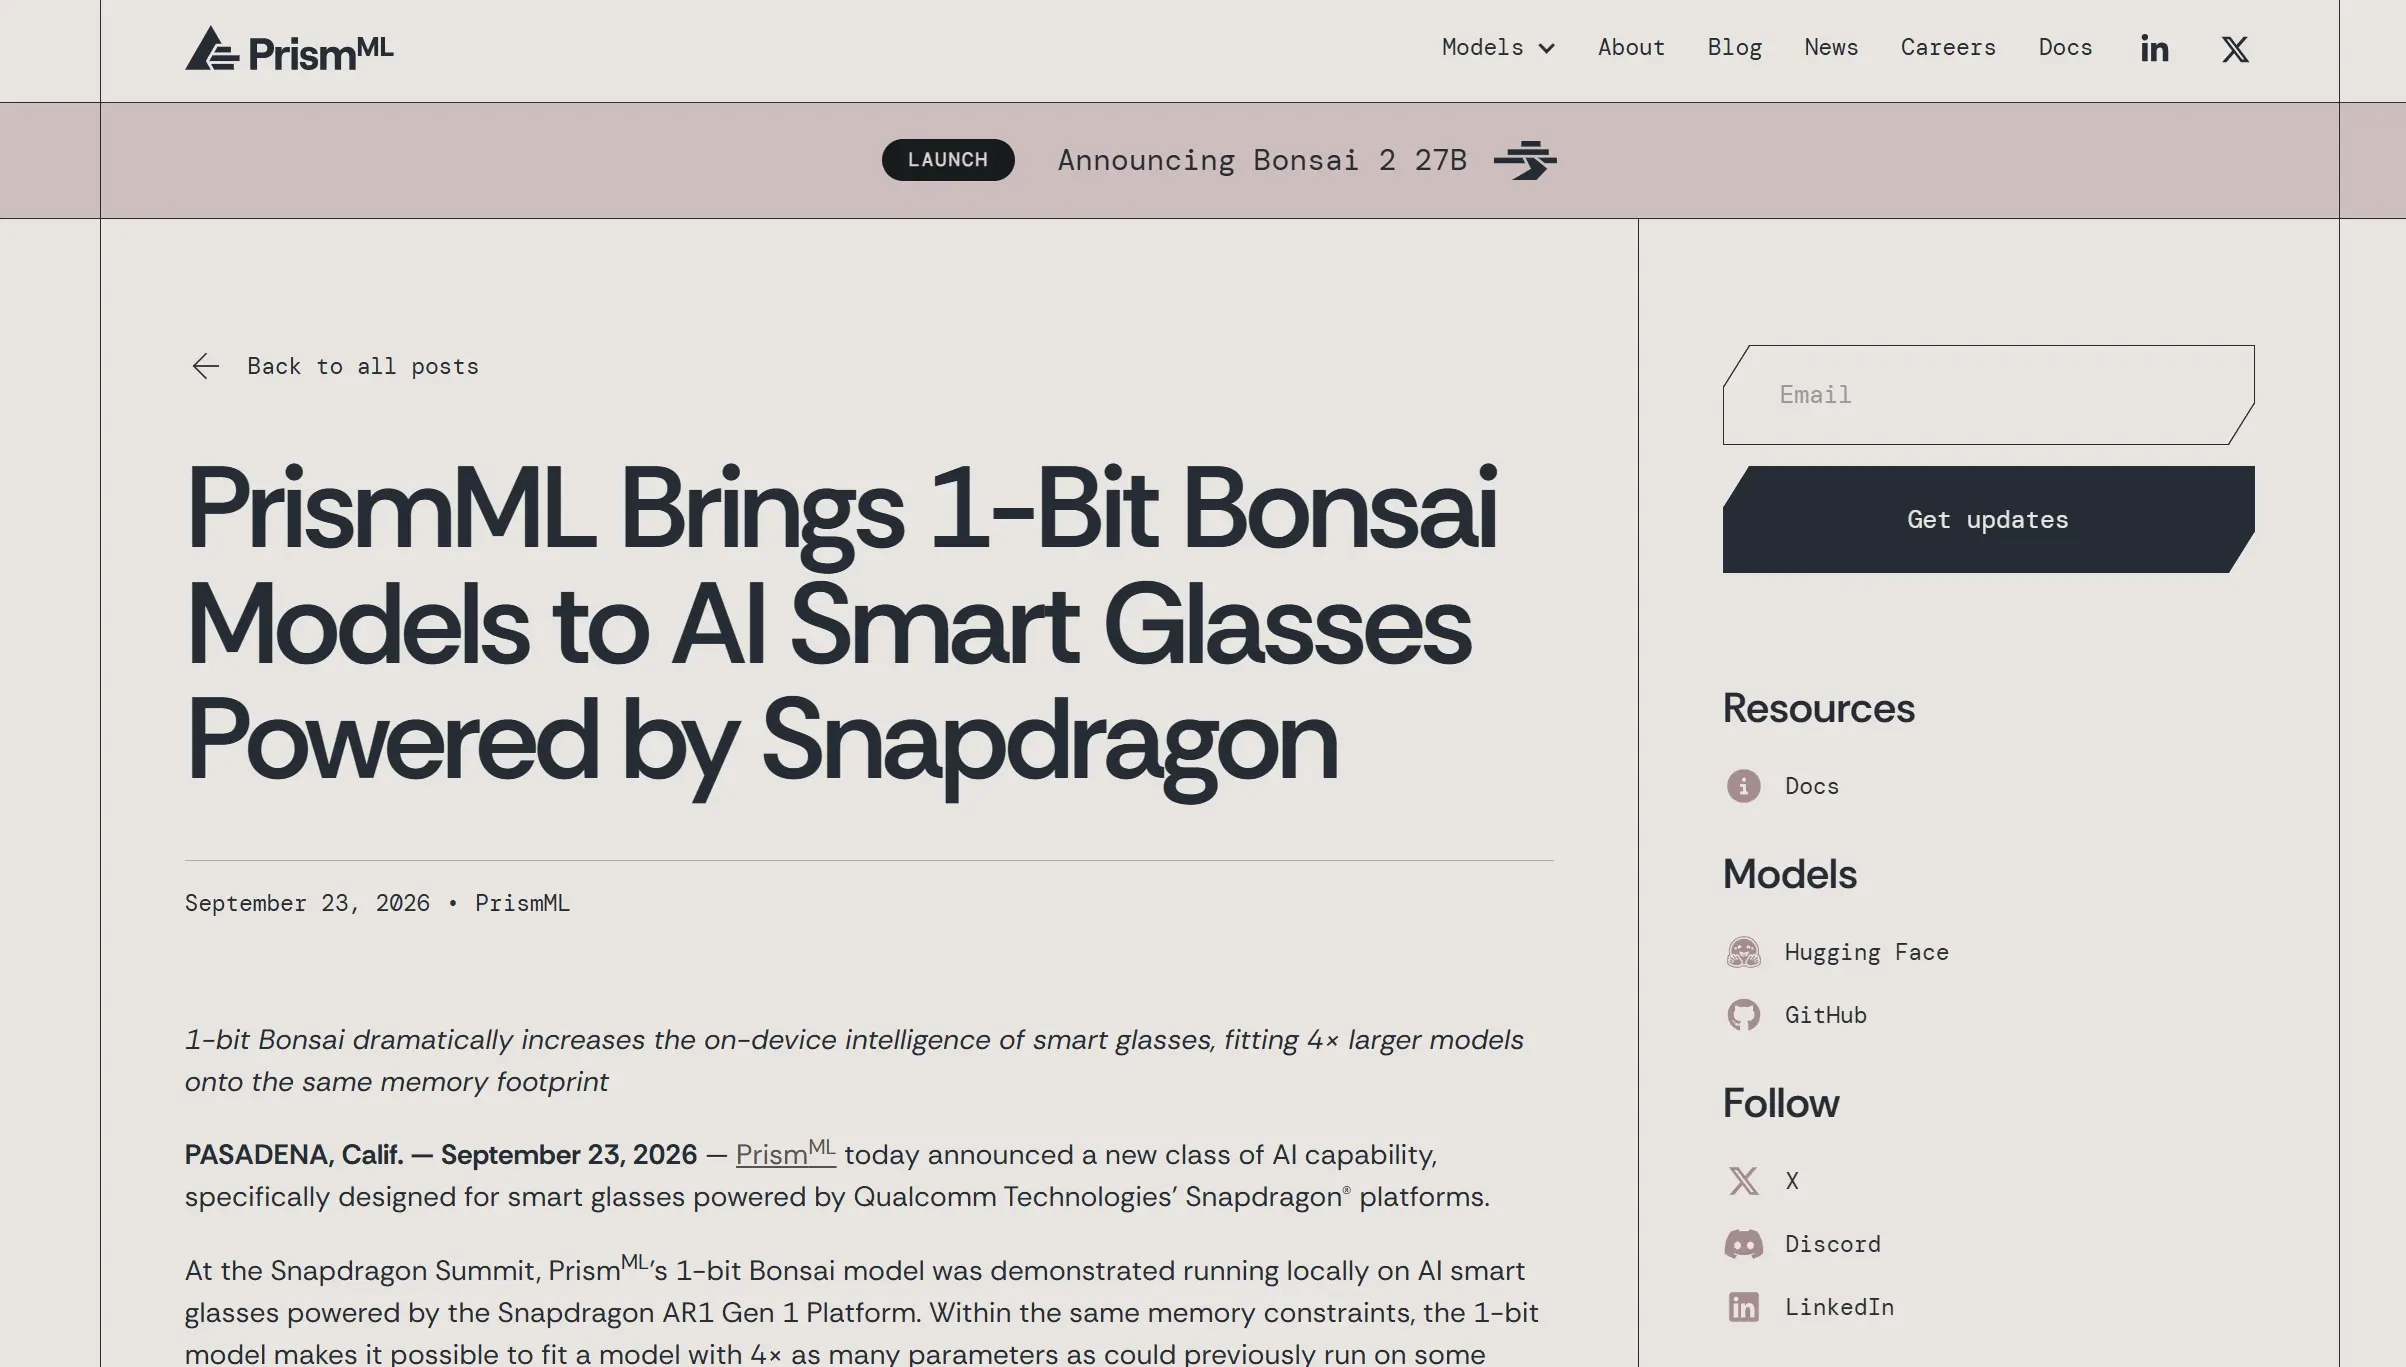
1-bit Bonsai是一款由PrismML于2026年9月推出的端侧视觉语言模型,主要用于智能眼镜等设备的本地视觉理解与实时问答,支持 1-bit 权重量化与视觉、语言双模态输入,适用于可穿戴设备、移动终端与离线多模态场景。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 面向智能眼镜的端侧视觉语言模型 |
| 出品方 | PrismML |
| 发布时间 | 2026年9月23日 |
| 模型规模 | 2B(1.7B 语言 + 0.3B 视觉编码器) |
| 量化精度 | 1-bit(语言部分权重) |
| 权重内存 | 0.43GB(4-bit 版为 1.66GB) |
| 运行平台 | 骁龙 AR1 Gen 1(Hexagon NPU) |
| 上下文长度 | 1,024 tokens |
| 开源许可 | Apache-2.0(Bonsai 1.7B) |
1-bit Bonsai 的核心能力
1-bit Bonsai 的定位是让视觉语言模型在极小的内存与功耗预算内运行。PrismML 表示,智能眼镜可获取的视觉上下文极为丰富,而设备本身在内存、功耗与散热上受到严格限制,因此模型需要围绕这些约束重新设计。该模型基于今年早前发布的 Bonsai 1.7B 构建,由 1.7B 语言模型与 0.3B 视觉编码器组成。
1-bit 量化与内存压缩
模型把语言部分的权重压缩至 1-bit。官方在骁龙 AR1 Gen 1 平台上的测试显示,1.7B 语言模型的权重内存占用为 0.43GB,对应的 4-bit 版本为 1.66GB,相当于减少 3.83 倍。在同等内存条件下,可容纳的参数量约为原来的 4 倍,这使原本受限于内存规格、无法运行的模型规模得以在眼镜形态的设备上部署。
端侧视觉理解与实时问答
作为视觉语言模型,1-bit Bonsai 可理解佩戴者所见内容、对画面上下文进行推理并作出响应,推理过程在设备本地完成,画面与对话内容无需上传云端。这一能力面向的典型交互包括识别眼前物体、理解所处场景,以及结合当前画面回答问题。
与骁龙平台的协同优化
PrismML 与高通合作,针对 Hexagon NPU 优化了模型权重与架构。官方给出的测试环境为4GB 内存、峰值 AI 算力 6 TOPS、每周期 2,304 次乘加运算的骁龙 AR1 Gen 1 平台,上下文长度设定为 1,024 tokens。在该环境下,模型生成速度为每秒 15.36 tokens,对应的 4-bit 版本为每秒 7.44 tokens,提升约 2.06 倍。高通 XR 业务高级副总裁兼总经理 Ziad Asghar 表示,双方的合作使本地运行的多模态 AI 体验在轻量、低功耗的可穿戴设备上更具可行性。
官方基准对照与产品系列
PrismML 给出的对照评测覆盖 BFCL v3、HumanEval+、MMLU Redux、IFEval、IFBench、MuSR、GSM8K 与 GPQA Diamond 八项基准,测试以 Bonsai 1.7B 的 1-bit 版本与同规模的 4-bit 量化版本为对象,两种配置取得了相当的评测结果。在端侧低比特量化这条技术路线上,HY-1.8B-2Bit 采用 2-bit 量化压缩权重,BitCPM-CANN 则把显存占用降低约 6 倍,三者分别探索了不同的压缩比例与硬件适配路径。
1-bit Bonsai 与同类端侧量化模型的对比
1-bit Bonsai 的对照基准来自 PrismML 官方发布材料中给出的 Qwen 3 1.7B 4-bit 量化版本。两者的参数规模接近,都面向端侧部署,差别在于权重压缩比例以及由此带来的内存占用与生成速度差异。下表数值取自官方测试口径,测试平台与条件一致。
| 对比维度 | 1-bit Bonsai | Qwen 3 1.7B(4-bit 量化) |
|---|---|---|
| 开发方 | PrismML | 阿里通义 |
| 模型规模 | 2B(1.7B 语言 + 0.3B 视觉编码器) | 1.7B 稠密语言模型 |
| 权重量化精度 | 1-bit | 4-bit |
| 权重内存占用 | 0.43GB | 1.66GB |
| 生成速度 | 每秒 15.36 tokens | 每秒 7.44 tokens |
| 测试平台 | 骁龙 AR1 Gen 1,4GB 内存 | 骁龙 AR1 Gen 1,4GB 内存 |
| 测试上下文 | 1,024 tokens | 1,024 tokens |
| 输入模态 | 视觉与语言 | 语言 |
上表数值取自 PrismML 官方新闻稿及其测试脚注,两组数据均由高通在骁龙 AR1 Gen 1 平台上测得,条件为 4GB 内存与 1,024 tokens 上下文。官方说明,1-bit 与 4-bit 两种配置在上述八项基准上取得了相当的评测结果,实际表现会随模型配置、评测方法与负载条件变化。需要对照端侧多模态方案的读者,可以查看 MiniCPM-V 4.6(OpenBMB 推出的端侧视觉理解模型,支持图像、视频与多图理解,可在 iOS、Android 与 HarmonyOS 上本地运行)。
1-bit Bonsai 的应用场景与适用人群
低比特量化把视觉语言模型的部署门槛压到可穿戴设备的量级,典型用途包括以下三类。
- 智能眼镜的本地视觉助手:在语音交互之外理解佩戴者所见画面,完成识图、物体辨认与场景问答,画面内容无需上传云端。
- 可穿戴与移动终端的离线推理:在内存与功耗受限的设备上运行视觉语言模型,断网环境下仍可响应,适合对响应时延与数据留存有要求的场景。
- 端侧低比特部署验证:为需要在 NPU 上压缩模型体积的产品团队提供 1-bit 量化与模型硬件协同设计的参考路径,面壁智能的 MiniCPM5-1B 等端侧轻量模型也采用了类似的端侧优化思路。
适用人群:智能眼镜与可穿戴设备的产品团队,需要在端侧部署多模态能力的应用开发者,以及关注低比特量化与模型硬件协同设计的研究人员。如果目标设备的内存预算充足、对识别精度要求高于部署成本,同系列的 4B 与 8B 规格以及云端多模态模型通常更合适。
1-bit Bonsai 的使用方法
模型权重已公开下载,使用流程围绕「获取权重—选择框架—按硬件编译—实测验证」展开。
- 获取权重:从 Bonsai 1.7B 官方权重仓库 下载 1-bit 权重,该仓库同时提供 GGUF 与未打包两种格式。
- 选择推理框架:使用支持 1-bit 权重的
llama.cpp或 MLX 运行,桌面端可先在开发机上完成效果验证。 - 按目标硬件编译:使用设备厂商提供的量化推理 SDK,把模型编译到目标 NPU,例如高通平台可选用 QNN SDK。
- 实测验证:在目标设备上测量权重内存占用与生成速度,并与同规格 4-bit 版本对照,确认满足时延与功耗要求。
1-bit Bonsai 的价格与开源情况
1-bit Bonsai 的权重不单独收费,成本主要来自部署硬件。PrismML 已在 Hugging Face 的 prism-ml 组织下公开 Bonsai 系列权重,其中 Bonsai 1.7B 的 1-bit 版本以 GGUF 与 MLX 格式发布,未打包权重采用 Apache-2.0 许可,可用于商业部署。
该系列除 1.7B 外还提供 4B、8B 与 27B 规格,并另有三元量化的 Ternary Bonsai 版本,分别面向不同的内存预算与算力条件。模型权重与推理框架独立分发,部署成本取决于目标硬件的内存规格与算力,厂商侧的实际部署还需要考虑量化编译与算子适配工作量。
1-bit Bonsai 的常见问题
1-bit Bonsai 支持哪些设备?
官方演示运行在搭载骁龙 AR1 Gen 1 平台的 AI 智能眼镜上。模型经过针对高通 Hexagon NPU 的权重与架构优化,测试平台配置为 4GB 内存。
1-bit 量化会带来明显的精度损失吗?
PrismML 的对照评测显示,1-bit 与 4-bit 两种配置在 BFCL v3、HumanEval+、MMLU Redux、IFEval、IFBench、MuSR、GSM8K 与 GPQA Diamond 八项基准上取得了相当的评测结果,实际表现会随模型配置、评测方法与负载条件变化。
1-bit Bonsai 可以商用吗?
PrismML 已在 Hugging Face 的 prism-ml 组织下公开该系列权重,Bonsai 1.7B 的未打包权重标注为 Apache-2.0 许可,可用于商业部署。具体授权范围建议以模型仓库标注为准。
相关文章


 浙公网安备33010202004812号