
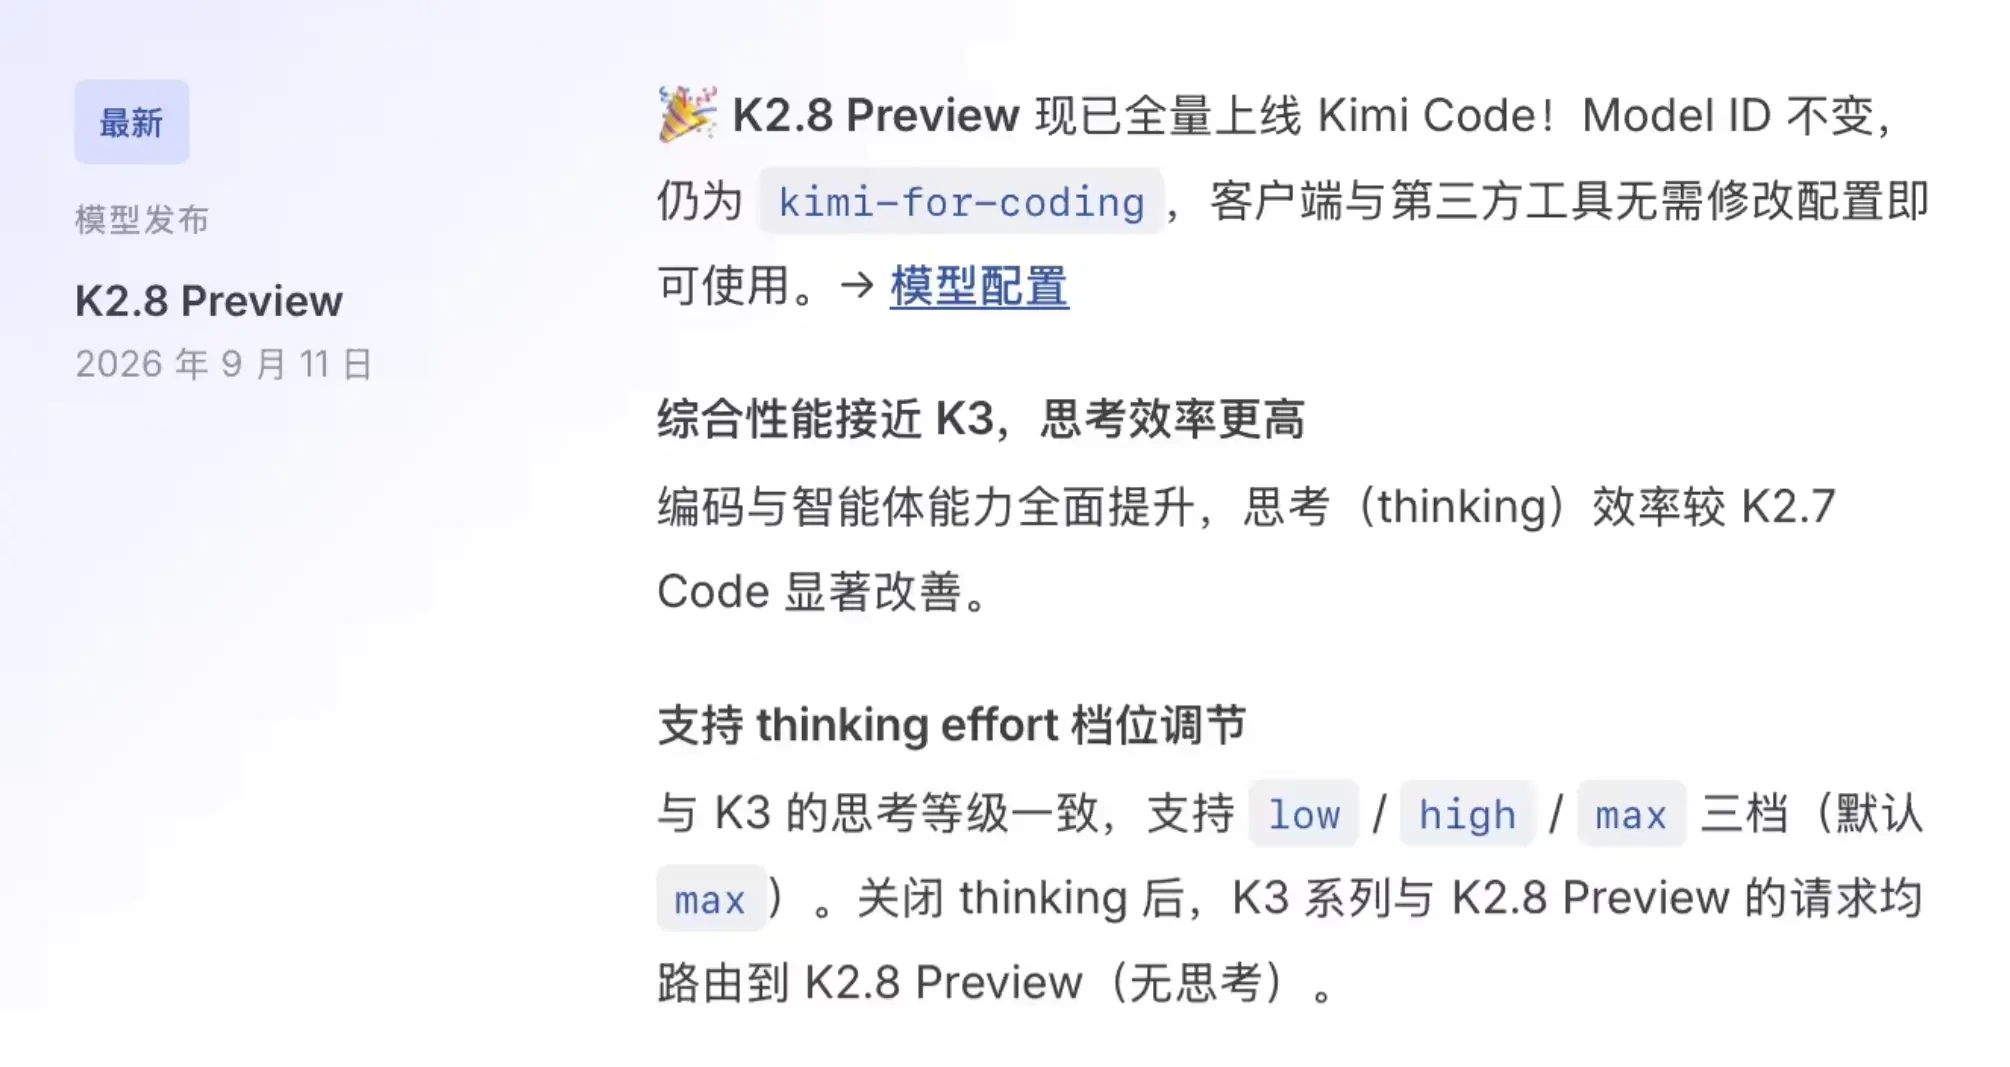
Kimi K2.8 Preview是一款由月之暗面(Moonshot AI)于2026年9月在 Kimi Code 与 Kimi Work 全量上线的新一代主力编程模型,主要用于代码补全、常规开发任务与多步骤智能体工作流,支持最高 1M Token 上下文以及图片、视频两类多模态输入,适用于个人开发者、小型研发团队与需要长上下文的工程协作场景。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 接棒旗舰 K3、面向日常开发的主力模型 |
| 出品方 | 月之暗面(Moonshot AI) |
| 发布时间 | 2026 年 9 月 11 日 |
| 上线平台 | Kimi Code、Kimi Work |
| 上下文窗口 | 1048576 Token(全部会员档位开放) |
| 思考档位 | low / high / max 三档,默认 max |
| 多模态输入 | 图片、视频 |
| 调用限制 | 全部会员可用;高速版未同步升级 |
| 模型标识 | kimi-for-coding(保持不变,无需改配置) |
Kimi K2.8 Preview 的核心能力
面向日常开发的性能定位
官方把 Kimi K2.8 Preview 的综合性能描述为接近旗舰 K3,编码与智能体能力较上一代 K2.7 Code 全面提升,同时强调思考效率有明显改善。需要说明的是,这次预览更新没有公布任何 benchmark 数据,「接近 K3」目前仍是官方口径,尚无第三方量化验证。它的定位并不在极限跑分,而是更适合代码补全与常规开发任务的那一档,行为比 K3 更可控、调用门槛更低。
全会员档位开放的 1M 超长上下文
上下文窗口开到 1048576 Token,并且向全部会员档位开放。对比来看,K3 的百万上下文此前需要 Allegretto 及以上(199 元/月)档位才能解锁,本次相当于把 1M 权限往下放了几级。对预算敏感的用户来说,过去为了百万上下文要多跳一两档会员,现在这个理由不再成立,一个中等规模的项目可以一次性读入,不必再手工合并文件、盯着上下文别爆。
三档思考强度与整条产品线的无思考底座
思考强度分 low、high、max 三档,与 K3 的思考等级保持一致,但出厂默认值不同——K3 默认 high,K2.8 Preview 默认落在 max。另一个容易忽略的路由细节是:关闭 thinking 之后,K3 系列与 K2.8 Preview 的请求都会转到 K2.8 Preview 的无思考版本上执行,也就是说这一版承担的是整条产品线的无思考底座。
图片与视频输入的多模态辅助
模型接受图片与视频两类输入,可以直接把报错截图丢进去定位问题,也可以录一段操作视频说明复现路径,或依据设计稿生成前端页面结构。对高频调试的前端与移动端开发来说,省掉了把界面问题翻译成文字描述的环节,沟通成本比纯文本提问低得多。
零配置的无感升级方式
本次切换是一条静默更新:Model ID 仍为 kimi-for-coding,客户端与第三方工具的配置一个字都不用改,打开就是新模型。需要留意一个例外——高速版 kimi-for-coding-highspeed 没有出现在这次更新里,它原本要求 Allegretto 及以上档位、上下文 256K,正在使用高速版的用户不要默认它也一起换了。
与 K3 的分工与协同
Kimi 把两个模型做了明确分工:K2.8 Preview 接管日常请求与无思考流量,K3 保留给需要极限能力的场景。这一分工也让 Agent 侧的成本结构发生变化——多步骤 AI 智能体 工作流往往需要反复调用模型,用单位成本更低的模型承接,长链路任务才有跑得起来的经济性。官方在 K3 技术博客里提过 K3 对历史 thinking 内容较敏感,如果 Agent 框架没有完整回传此前的思考记录,生成质量可能不稳定,这也让行为更可控的主力模型有了现实位置。
Kimi K2.8 Preview 与同类主力模型的对比
下表把 Kimi K2.8 Preview 与 Claude Sonnet 5、GLM-5.3-Flash、Qwen3.8-Max-Preview 在上下文、多模态、思考档位与获取方式上并列,便于判断各自的适用边界。
| 对比维度 | Kimi K2.8 Preview | Claude Sonnet 5 | GLM-5.3-Flash | Qwen3.8-Max-Preview |
|---|---|---|---|---|
| 开发方 | 月之暗面 | Anthropic | 智谱 | 阿里巴巴通义千问团队 |
| 产品定位 | 低成本主力编程模型 | 智能体执行与软件开发模型 | 原生多模态开源大模型 | 旗舰智能体基座模型预览版 |
| 参数规模 | 官方未公布 | 官方未公布 | 320B 总参数、18B 激活 | 2.4T |
| 上下文窗口 | 1M Token,全会员开放 | 约 100 万 Token | 原生 1M Token | 官方未公布 |
| 多模态输入 | 图片、视频 | 文本、图像 | 原生多模态 | 官方未公布 |
| 思考档位 | low / high / max 三档 | 自适应思考 | 官方未公布 | 官方未公布 |
| 价格与获取 | 随会员档位,不按 Token 计费 | 输入 2 美元、输出 10 美元每百万 Token | 官方口径为 GLM-5.3 的十分之一 | Token Plan 个人版 39 元/月起 |
| 开放程度 | 官方未公布 | 闭源商业模型 | 已开源,接入 BigModel | 正式版计划开源 |
四者路线差异明显:Claude Sonnet 5 走闭源 API 与智能体执行路线,按 Token 计费;GLM-5.3-Flash 把原生多模态与原生百万上下文做成了开源版本;Qwen3.8-Max-Preview 以 2.4T 规模押注复杂任务;Kimi K2.8 Preview 的选择是低门槛的主力定位——不单独按 Token 计费,把百万上下文与多模态放进会员权益里,用调用成本换开发者的使用频率。
如果需要的是极限能力而非日常主力,可以了解 Kimi K3(月之暗面开源的智能体与超长上下文旗舰模型,K2.8 Preview 的许多能力边界正是以它为对照基准)。
Kimi K2.8 Preview 的应用场景与适用人群
K2.8 Preview 的能力边界集中在「长上下文 + 高频调用 + 明确边界」的开发任务上,以下四类场景最能发挥它的特点。
- 大型代码库理解与重构:1M 上下文可以一次性读入整个仓库,做跨文件依赖分析、批量重构与架构级修改建议。
- 日常补全与调试:行为比 K3 更可控、响应更快,适合高频次的代码补全、修失败用例与小功能迭代。
- 多模态开发辅助:直接贴报错截图或录屏说明复现路径,也可以参考设计稿生成前端页面代码。
- 智能体流程闭环:围绕跑测试、修失败用例、提交 PR 的多步骤任务编排,用单位成本更低的主力模型承接长链路调用。
适用人群:预算有限但需要长上下文的个人开发者、常年使用 Kimi Code 的小型研发团队,以及把 Kimi 接入 Claude Code、Codex 等第三方工具的工程师。
Kimi K2.8 Preview 的使用方法
- 确认模型版本:打开 Kimi Code 客户端或网页端,模型列表里的 kimi-for-coding 已经指向 K2.8 Preview,档位与权限说明见 Kimi Code 官网。
- 先拿长任务验证:把整个项目目录或一份长文档一次性交给模型,观察它在跨文件理解上的实际表现。
- 按任务调思考强度:日常补全这类边界明确的活手动调到 low 会明显更快,复杂重构再回到 max。
- 按需切回 K3:档位够就能在模型列表里切换,本次升级不是强制替换,两个模型可以并行使用。
Kimi K2.8 Preview 的价格与开源情况
Kimi K2.8 Preview 不单独按 Token 计费,费用包含在 Kimi Code 会员权益内,档位为 Adagio 免费、Andante 49 元/月、Moderato 99 元/月、Allegretto 199 元/月、Allegro 699 元/月。本次属于模型侧升级而非新增付费项,档位不变、权益上调;此前为解锁百万上下文而升级到 199 元档的理由,在 K2.8 Preview 上不再成立。
Kimi K2.8 Preview 的开源状态官方尚未公布,本次预览更新也未给出权重与许可说明。K 系列此前保有开源传统,旗舰 K3 已开放权重,因此这一版后续是否跟进需要以官方公告为准;就当前可核实的信息看,它只能通过 Kimi Code 与 Kimi Work 这两个平台使用,暂无自部署路径。
Kimi K2.8 Preview 的常见问题
Kimi K2.8 Preview 和 Kimi K3 有什么区别?
K3 是旗舰模型,追求极限能力上限,调用门槛更高;K2.8 Preview 定位日常主力,官方称综合性能接近 K3,行为更可控、单位成本更低,全部会员档位都能用上 1M 上下文,二者在 Kimi 的产品线里分工并行。
升级到 Kimi K2.8 Preview 需要额外付费吗?
不需要。这是模型侧的静默升级,Model ID 保持 kimi-for-coding 不变,会员档位与价格不变,客户端与第三方工具都无需修改配置,打开即用。
接第三方工具需要改配置吗?
不需要。官方说明 Model ID 未变,接 Claude Code、Codex、OpenCode 这类工具的用户零改动;但高速版 kimi-for-coding-highspeed 未同步升级,使用高速版的用户需要单独确认。
相关文章


 浙公网安备33010202004812号