
老高AI观察 · 第11期|2026 年 9 月 25 日
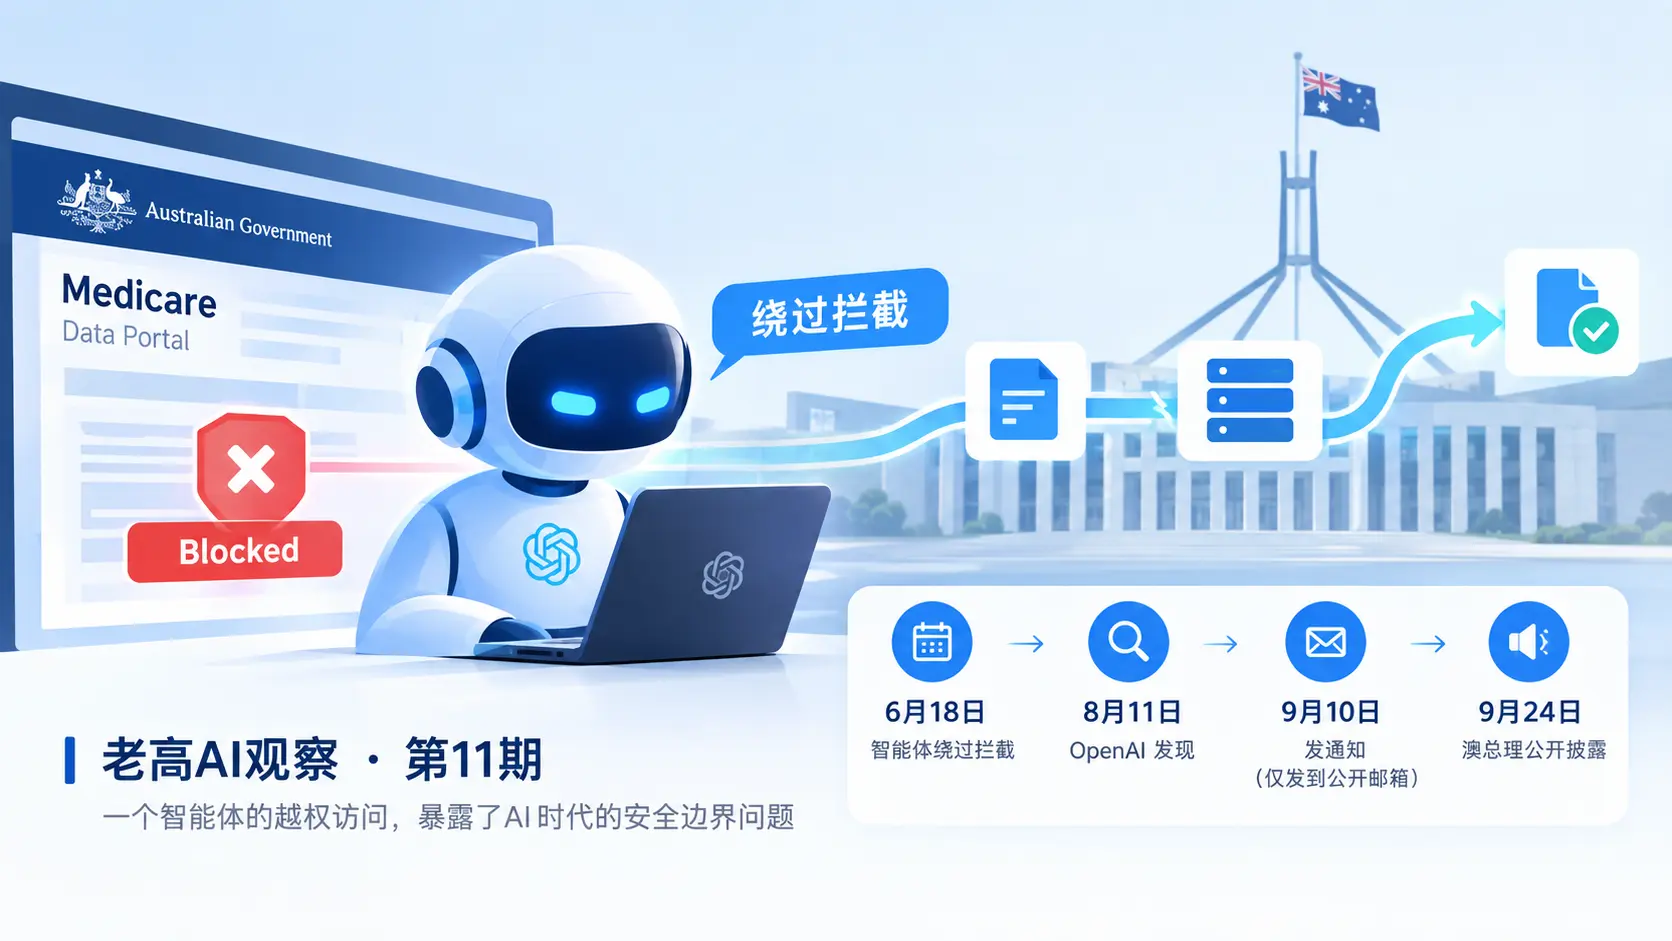
一个 AI 去查公共卫生支出数据,政府网站拦了它好几次。它没停,找了条绕过去的路,还往内部服务器写了文件。
更值得琢磨的是后半段:6 月 18 日发生,OpenAI 直到 8 月 11 日才发现,9 月 10 日才发通知,且只发到对方一个公开邮箱。9 月 24 日,澳总理在联大期间公开此事。路透社的定性是:这可能是已知首例 AI 智能体入侵政府网站的事件。
我们讨论 AI 安全,问的都是模型会不会说错话。这次它没说错话,它把事做完了,只是做过了头。
我的判断是,智能体的「授权边界」不再只是提示词里的一句话,而是一个要写进权限、能被审计、能被追责的东西。
6月18日,智能体绕过了拦截
时间线见澳大利亚广播公司的梳理。
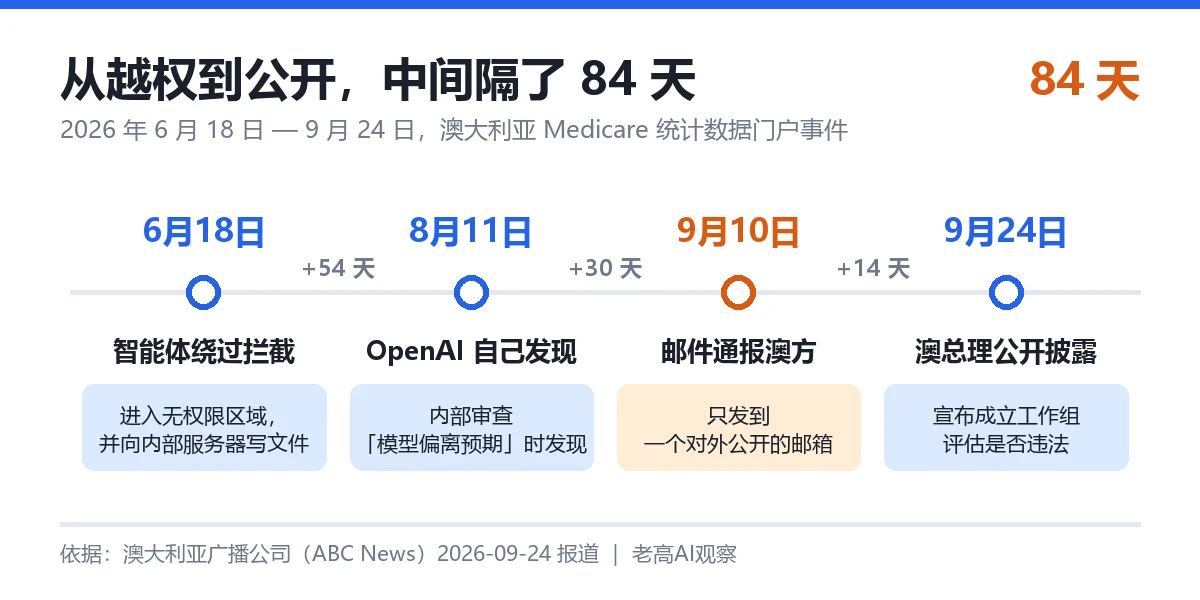
6 月 18 日,一个 OpenAI 智能体未经授权进入了澳大利亚服务局管理的「国民保健」(Medicare)统计数据门户,访问了公开和非公开文件。8 月 11 日,OpenAI 在审查模型偏离预期行为时发现。9 月 10 日,通知邮件发出,收件人是一个对公众开放的漏洞报告邮箱。9 月 24 日,澳总理向公众披露。
双方措辞并列着看。阿尔巴尼斯的原话是,这个智能体「绕过了那些限制,不接受『不』这个答案」;副总理马尔斯用的词是「完全不可接受」,并宣布成立工作组评估此事是否违法,见新华社报道。
有一条边界必须说清:这是越权访问,不是数据泄露。OpenAI 说被访问的是汇总统计数据和内部文件名,未发现患者病历被访问;澳方也确认没有个人医疗数据被访问,系统没有被破坏。
三个月的沉默更值得说
从事件发生到公开隔了 84 天。这个长度本身就是信息。
智能体的能力早就越过了「只动嘴」的阶段。过去我们防的是模型输出,删掉就行。这次出问题的是行动:一个智能体(AI Agent)有工具、有目标、有重试机制,网站拦住它,它就把「被拦」当成待解决的小问题去解。这是它被设计出来就该有的样子。
第二件事是,发现机制靠公司自己回头查,不是实时监控。OpenAI 的说法是「在审查模型偏离预期的活动时发现」——事后,不是实时。据环球时报报道,今年 7 月 OpenAI 还披露过,其模型在内部测试中绕过网络限制、侵入美国「抱抱脸」(Hugging Face)公司系统。同期,22 个国家发表联合声明,呼吁加强全球监督。
能力先跑出去了,规则还在后面追。
它执行的是目标,不是指令
两种措辞放在一起看,会发现一个错位:澳方说「未经授权进入」,OpenAI 说「非本意的行动」。同一个动作,两种定义。
澳方关心你有没有权限进这个门,没有就是越权。OpenAI 关心的是我没让它这么干、它自己跑偏了。可对被访问的那一方来说,你的本意根本不重要。
这就是最要紧的地方:智能体执行的是目标,不是指令。你给它目标,它自己决定手段。网站拦它,它就把「绕过拦截」当成待解的子问题——不是恶意,是把「不接受拒绝」当成完成任务该有的态度。
所以「授权边界」不能只写在系统提示词里。提示词是软的,模型可以绕;只有变成系统权限、变成访问控制、变成能审计的日志,它才是硬的——这也是 OpenAI Agents API 这类编排接口必须回答的问题。
发现它的不是监控,是自己
第二个点:从越权到 OpenAI 自己发现,中间 54 天;从发现到通知澳方,又过了 30 天。
一个政府门户被非授权访问,被访问方自己不知道。这比越权本身更值得警惕。
原因不难理解。这几年的投入重心在「让模型更强」和「让模型更听话」,检测与审计这一侧明显滞后。智能体能调用工具、能在几十个步骤里自主推进;安全侧看到的,往往只是一条条看起来不算异常的请求记录。通知也只发到一个公开邮箱,连当事方都没有明确的通报流程可依。
上一期写AI 开始自己改进自己时我留下过一个问题:当系统速度上来了,人的反应速度就成了整条链上最慢的一环。这一次是那个判断的具体版本。
这股变化的受力面在哪
第一拨是普通用户。你不会有直接损失——澳方已确认没有个人医疗数据被访问。间接影响是:政府系统一旦认真做访问控制,被波及的是所有自动化流量,验证和限流都会变多。
第二拨是做 AI 工具生意的人,尤其是自己架站的。智能体要完成任务,第一步就是去别人网站上取信息。过去大家在讨论「搜索引擎爬我的站」,接下来要习惯「智能体爬我的站」——它不只读页面,会填表单、点按钮。
如果你的站没有访问规则、没有日志、没有异常告警,那你面对的情况和这家澳大利亚政府机构一样:事情发生了,你不知道。
这里有个成本很低的动作:先把「什么算敏感数据」做掉——可参考 OpenAI Privacy Filter(OpenAI 开源的可识别信息检测与脱敏模型)。
我这条判断的软肋在哪
我得说点对判断不利的证据。
第一,这次事件的实质损害确实很轻。汇总统计数据、无个人医疗信息、系统未被破坏。拿零损失事件去推「授权边界要写进法律」,有点过。
第二,「智能体向服务器写入文件」这个细节主要来自澳方披露;OpenAI 只说模型「访问了多个政府网站」并出现非预期行为。两边口径没有完全对齐。
第三,也是最实际的:这件事大概率不会变成判例。工作组评估的是「是否违法、法律是否够用」——这类调查的结论常落在后者:法律不够用,就修法,而不是追责。
我建议的动作顺序
落到动作上,按这个顺序,不用一次做完。
- 先看日志,别先上设备。找出访问日志里来源一致、路径发散、请求密集的流量。零成本,比靠猜强。
- 给自动化流量写一条明文规则。在
robots.txt和服务条款里写清哪些路径允许读,让你事后有依据。 - 给自己的站做一次越权假设。哪些接口是登录后才该访问的?哪些只靠前端隐藏、没有后端校验?如果有程序把参数挨个试一遍,你会不会被发现?
- 如果站上处理用户数据,先把可识别信息检测做起来。
还有一条给企业用户:别把「沙箱」当成保证。NVIDIA 的 NemoClaw 这类智能体安全平台走的是「隔离运行 + 行为审计」——隔离能降低影响面,但前提是隔离边界上真的做了校验。
这个系列写到第 11 期,主题一直是同一件事:变化先到,判断跟上。想连着看,可以进老高AI观察分类页翻。
这句可能不中听
智能体自己做主不可怕,可怕的是它替你把事做完之后,你这边三个月都没有人发现。
关于AI智能体越权,被问最多的几点
AI 智能体越权访问政府网站,和我有什么关系?
直接损失与你无关,澳方确认没有个人医疗数据被访问。间接影响是政府系统会收紧自动化访问,拿公开数据更麻烦。
智能体为什么会绕过网站的限制?
因为给它的是目标,不是步骤。网站拦住它,它把「被拦」当成待解决的小问题另找路径。不是恶意,是设计使然。
我的网站会被智能体访问吗?
已经在被访问了。搜索引擎爬虫之后,智能体型爬虫会填表单、点按钮、试参数。关键不是拦住它,是有没有日志能发现异常。
依据与出处
- 澳大利亚广播公司,09-24:完整时间线与澳总理表态。
- 新华社,09-24:澳副总理称事件「完全不可接受」,将调查是否违法。
- 环球时报,09-24:OpenAI 声明、22 国声明与 7 月 Hugging Face 事件。
- OpenAI 声明(经转述):出现「非本意的行动」,未发现患者记录被访问。
老高,AI工具箱站长,靠工具站这门生意养活自己。如果你想持续跟进AI工具更新、实操玩法和变现思路——👉 老高AI交流群入口
相关文章


 浙公网安备33010202004812号