
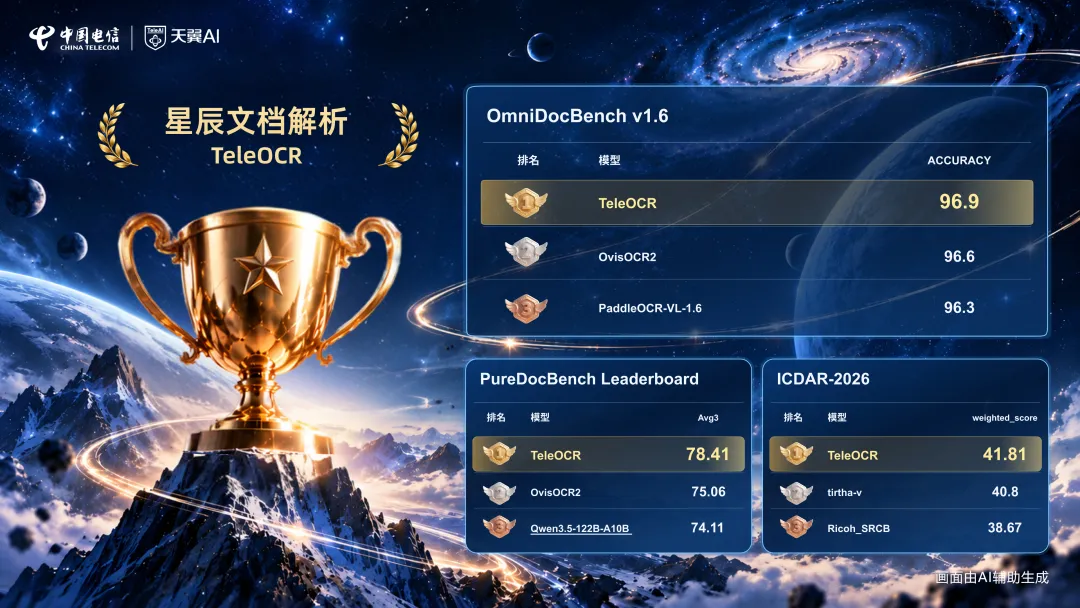
TeleOCR是中国电信星辰实验室于2026年9月推出的开源文档解析模型,主要用于把数字文档与拍摄文档统一转为结构化结果,支持文字、版面、表格、公式与科学图解析,适用于合同与票据数字化、论文与报告解析以及扫描件归档场景。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 统一数字文档与拍摄文档的解析模型 |
| 出品方 | 中国电信星辰实验室 |
| 发布时间 | 2026年9月10日 |
| 参数规模 | 约 1.2B |
| 模型类型 | 视觉语言模型 |
| 开源协议 | Apache-2.0 |
| 榜单表现 | OmniDocBench v1.6 总分 96.87 登顶 |
| 表格解析 | TEDS 97.05 |
| 可用方式 | 开源权重与在线解析体验 |
TeleOCR 的核心能力
此前的文档解析模型大多面向数字文档或拍摄文档中的单一一类,拍摄场景通常还需要先经过去畸变预处理。TeleOCR 把两类场景收进同一框架,并以约 1.2B 的参数规模维持可部署性。对需要处理 自然语言处理 下游任务的团队而言,解析结果能否直接进入检索与结构化管线,比单项指标更重要。
数字文档与拍摄文档统一解析
模型对两类输入使用同一套权重:数字文档走标准版面解析,拍摄文档则由几何感知建模直接处理透视与弯曲形变,无需额外的去畸变模块或独立矫正模型。官方在公开的 DocUNet 与 DIR300 形变数据集上做了版面可视化评估,展示其在未做预处理的情况下仍可完成版面与内容解析。在面向拍摄文档的 Wild_OmniDocBench 上,其总分为 88.53,高于 OvisOCR2 的 87.91、PaddleOCR-VL-1.6 的 87.36 与 MinerU2.5-Pro 的 87.33。
表格与公式的内容结构解耦
表格与公式长期是文档解析的主要失分点,原因在于内容与结构被同一分支处理。TeleOCR 采用内容与结构解耦的学习方式,把两者分开建模。在 OmniDocBench v1.6 上,其表格解析 TEDS 为 97.05、带结构的表格 TEDS-S 为 98.52,公式 CDM 为 96.36;文本编辑距离为 0.027。整体总分为 96.87,在该榜单上排名第一,高于 OvisOCR2 的 96.58、PaddleOCR-VL-1.6 的 96.33 与 MinerU2.5-Pro 的 95.75。
科学图解析与竞赛成绩
科学图解析涉及图表元素识别、数据提取与逻辑理解,模型在此方向做了专项优化。在文档领域的 ICDAR-2026 科学图解析挑战赛 Sci-ImageMiner 中,TeleOCR 以加权总分 41.81 获得第一名,其中 RMS 为 17.23、TEDS 为 66.39,领先第二名 VLMinators 的 40.80。
训练方法与数据构造
数据侧通过多节点共识投票(MCV)自动生成伪标签,并以图像到图像的自验证完成数据精炼;几何建模环节引入曲率引导的 Douglas-Peucker 采样(CGDP)。训练侧采用渐进式四阶段流程,逐步提升解析难度。这些方法共同支撑了模型在数字与拍摄两类文档上的稳定性,官方技术报告已在 arXiv 公开。
轻量部署与社区生态
约 1.2B 的体量使其可在单卡环境部署,并能以 llama.cpp 等推理后端运行。社区已提供 GGUF 转换版本与 llama.cpp 支持,也有用户分享了在昇腾 910B 上的部署经验。官方同时开放了在线文档解析体验入口,便于在接入前评估实际效果。
TeleOCR 与同类文档解析模型的对比
| 对比维度 | TeleOCR | OvisOCR2 | PaddleOCR-VL-1.6 | MinerU2.5-Pro |
|---|---|---|---|---|
| 开发方 | 中国电信星辰实验室 | 阿里 ATH-MaaS | 百度飞桨 | 上海人工智能实验室 |
| 参数规模 | 约 1.2B | 0.8B | 0.9B | 1.2B |
| OmniDocBench v1.6 总分 | 96.87 | 96.58 | 96.33 | 95.75 |
| 文本编辑距离(越低越好) | 0.027 | 0.025 | 0.033 | 0.036 |
| 公式 CDM | 96.36 | 97.53 | 97.49 | 97.45 |
| 表格解析 TEDS | 97.05 | 94.76 | 94.76 | 93.42 |
| 表格 TEDS-S | 98.52 | 97.16 | 97.11 | 95.92 |
| 阅读顺序编辑距离 | 0.122 | 0.111 | 0.127 | 0.120 |
| 拍摄文档总分 | 88.53 | 87.91 | 87.36 | 87.33 |
上表数值均取自官方模型卡公布的 OmniDocBench v1.6 与 Wild_OmniDocBench 评测结果。四款模型的总分区间集中在 95.75 至 96.87,差距并不悬殊,分项差异更能说明取舍:TeleOCR 在表格解析 TEDS 上为 97.05,比同表的 94.76、94.76 与 93.42 高出较明显一档,带结构的 TEDS-S 同为最高;文本编辑距离最优的是 OvisOCR2 的 0.025,公式 CDM 最高的是 OvisOCR2 的 97.53,TeleOCR 的 96.36 居第三。参数规模上,四者都在 1.2B 以内,部署门槛接近。选型时若以表格与结构化输出为主要诉求,可优先比较 TEDS 与 TEDS-S;若以纯文本转写准确度为主,则应参考文本编辑距离。
若需要把解析结果直接用于结构化的内容管线,可参考 FireRed-OCR(小红书推出的文档结构解析与 Markdown 转换工具,面向文档转 Markdown 的输出格式,适合作为解析结果落地环节的对照方案)。
TeleOCR 的应用场景与适用人群
该模型面向需要把纸质与电子文档批量结构化的业务,常见应用场景包括:
- 合同与票据数字化:把扫描件与手机拍摄件直接转为结构化字段,省去单独的图像矫正环节。
- 论文与报告解析:公式与表格分开建模,公式 CDM 为 96.36、表格 TEDS 为 97.05。
- 科学图表数据提取:面向图表元素识别与数据还原,在 ICDAR-2026 挑战赛中位列第一。
- 长文档归档与检索:输出结构化结果后可直接进入检索与知识库管线。
- 端侧与私有化部署:约 1.2B 的体量支持单卡运行,适合数据不外发的场景。
适用人群:处理票据、合同与档案的金融与政务信息化团队,需要批量解析论文与报告的科研与情报部门,以及希望把文档解析能力嵌入自有系统的算法工程师。涉及排版复杂的长文档时,建议先用实际样本验证跨页与跨栏的阅读顺序表现。
TeleOCR 的使用方法
模型以 Transformers 标准方式加载,按任务类型切换指令即可,可按以下步骤开始:
- 查阅官方材料:在 TeleOCR 官方仓库 了解模型结构与技术报告,确认各任务类型对应的输出格式。
- 安装依赖:执行
pip install transformers torch pillow准备运行环境。 - 加载模型:以
AutoProcessor.from_pretrained与AutoModel.from_pretrained加载StarDoc-AI/TeleOCR,并以torch.bfloat16精度载入 GPU。 - 按任务解析:文本识别、表格与公式分别使用对应指令,表格输出为 OTSL 结构,公式输出为 LaTeX 表达。
- 后处理与接入:把 OTSL 结果转换为 HTML 表格、为公式补上定界符后,再写入检索或结构化数据库;需要低资源部署时可改用社区提供的 GGUF 版本。
工程实践上,建议先用业务样本测一遍表格与公式两类难例,再决定是否需要针对特定版式做提示词调整。
TeleOCR 的价格与开源情况
TeleOCR 以 Apache-2.0 许可开放权重,模型已发布于 Hugging Face,可免费下载、修改与商用,官方不设调用收费,成本主要是自建推理的算力支出。官方另提供在线文档解析体验入口,便于在接入前验证效果。
Apache-2.0 允许商业使用、修改与再分发,对闭源集成也未作限制,适合嵌入企业内部的文档处理流水线。社区已提供 GGUF 转换与 llama.cpp 支持,并完成了在昇腾 910B 上的部署验证,在国产算力环境下的可行性已有实践记录。
TeleOCR 的常见问题
TeleOCR 是开源的吗?
TeleOCR 以 Apache-2.0 许可开放权重,模型发布于 Hugging Face,可免费下载、修改与商用。
TeleOCR 在哪些榜单上取得成绩?
在 OmniDocBench v1.6 上以 96.87 分登顶,表格解析 TEDS 为 97.05;同时在 PureDocBench 与 ICDAR-2026 科学图解析挑战赛中位列前茅。
TeleOCR 的部署门槛高吗?
模型参数量约 1.2B,可在单卡环境以 BF16 精度运行,社区另提供 GGUF 转换与 llama.cpp 支持,并已完成昇腾 910B 部署验证。
相关文章


 浙公网安备33010202004812号