
HiDream-O1-Video-1.0(简称 HD-V1)是一款由智象未来(HiDream.ai)于2026年9月推出的原生全模态视频生成模型,主要用于依据文本、图像或视频生成高保真短视频,支持物理规律理解与音画一体化生成,适用于广告、影视预演、短视频与动画创作等场景。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 智象未来推出的原生全模态视频生成模型(HD-V1) |
| 出品方 | 智象未来(HiDream.ai) |
| 发布时间 | 2026年9月15日 |
| 核心能力 | 文本/图像/视频多条件驱动、物理规律理解、音画原生一体化生成 |
| 输出规格 | 5–20 秒 1080p 高保真视频 |
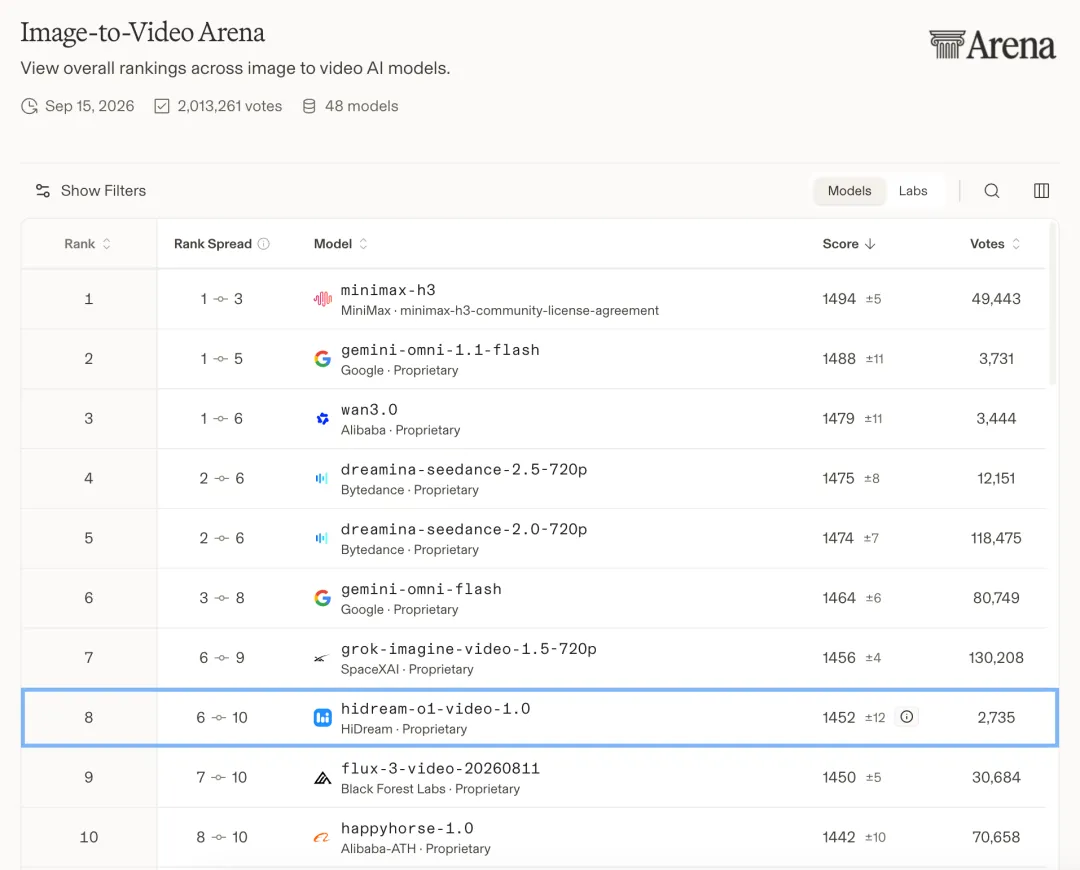
| 关键成绩 | Artificial Analysis 图生视频(With Audio) 全球第四;Arena.ai 盲测第八 |
| 开源与价格 | 内测阶段,非开源 |
HiDream-O1-Video-1.0 的核心能力
作为 AI 模型 中原生全模态路线的代表,HD-V1 将文本、视频与音频信号在同一生成过程中联合建模,强调对真实世界物理规律的理解与遵循。相比多数先生成画面、再后期配音的视频模型,HD-V1 从架构层面就让画面运动、台词与音效相互影响,减少了音画错位与物理失真。HD-V1 是智象自 2026 年 4 月发布 HiDream-O1 原生全模态架构以来的视频生成成员,与同系列图像、世界、具身模型共享统一底座,补全了原生全模态世界模型的闭环。
原生全模态架构
HD-V1 采用智象自研原生全模态架构,对文本、图像、视频、音频进行统一表征与联合建模,而非先生成画面再后期配音的传统路线。在该架构下,画面运动、台词与音效在同一流程中相互约束、相互对齐,模型不再把「画面」和「声音」当作两件独立的事分别处理。这一架构与此前 HiDream-O1-Image 图像模型、HiDream-O1-World 交互式世界模型同源,便于在多模态任务间复用同一套表征。
物理规律驱动的画面生成
模型将重力、碰撞、惯性、光影衰减与空间连续性等物理规律写入生成逻辑,使物体运动、材质质感与因果关系更符合真实世界。无论是针线穿引时的张力变化,还是乒乓球落地时随高度递减的弹跳频率与撞击声响,画面都能保持物理自洽,减少镜头跳戏、人物漂移与音画错位等常见问题。在同等提示词下,模型能避免物体凭空出现、张力反向等违背常识的画面,显著提升可信度。
前置意图理解与结构化规划
生成前,HD-V1 通过多模态意图理解模块对用户输入做结构化规划,明确镜头时长、场景、首帧约束、角色动作表情、运镜与音效设计等字段,让后续联合生成更稳定、更少偏离用户意图。理解越深,规划越稳,后续生成越不容易「跑偏」,也更容易一次产出可用镜头、减少反复重绘。
音画原生一体化
借助文本、视频、音频联合建模,HD-V1 实现原生音画同步:镜头切换时环境声与配乐随之过渡,人物开口时口型与情绪同频,物理动作伴随拟音反馈,避免后期拼接带来的不同步。声音不再只是画面的附属,而是与画面共同决定叙事节奏的要素;相比后期配音方案,原生一体化让声音与动作严格对齐。
叙事时长自主规划
不同于固定时长填充,HD-V1 根据事件展开逻辑与动作完成周期自主规划生成时长,让内容叙事自然推进,而非被迫适应预设时间窗口。一颗苹果从抛出到接住本是一个短促过程,模型不会为了填满 10 秒而让画面无意义停留,也不会用慢放强行凑时长;这种「内容决定时长」的思路,使成片节奏更贴近真实事件,而非被固定窗口切碎。
HiDream-O1-Video-1.0 与同类视频生成模型的对比
| 对比维度 | HiDream-O1-Video-1.0 | 阿里万相 Wan | Pika | 可灵 Kling | Runway |
|---|---|---|---|---|---|
| 开发方 | 智象未来 | 阿里巴巴 | Pika | 快手 | Runway |
| 核心定位 | 原生全模态视频生成模型 | 图像/视频生成模型 | AI 视频生成工具 | AI 视频生成模型 | AI 视频创作平台 |
| 多模态输入 | 文本、图像、视频 | 文本、图像 | 文本、图像 | 文本、图像 | 文本、图像 |
| 音画同步 | 原生联合建模,音画一体化 | 画面为主,音效后期 | 后期配音为主 | 后期配音为主 | 后期配音为主 |
| 物理规律 | 架构级核心卖点 | 非核心叙事 | 非核心 | 非核心 | 非核心 |
| 输出规格 | 5–20 秒 1080p | 图像/视频多规格 | 短视频 | 短视频 | 短视频/多规格 |
| 榜单成绩 | Artificial Analysis 图生视频(With Audio) 全球第四;Arena.ai 盲测第八 | 通用视频生成基线 | 广泛应用 | 头部 | 老牌 |
整体来看,HD-V1 的差异化在于把物理规律理解与音画原生一体化作为架构级能力,而非后期处理;在 Artificial Analysis 与 Arena.ai 两项权威榜单均进入第一梯队,与全球头部视频模型同台竞争。对追求「物理真实感」与「音画一致」的创作者而言,这是它相对可灵、Pika、Runway 等产品的核心差异点。
对希望快速上手视频生成的创作者,也可以关注成熟的视频生成产品。例如 Vidu 提供面向短视频与广告的 AI 视频生成服务,使用门槛更低。

HiDream-O1-Video-1.0 的应用场景与适用人群
- 广告与短视频创作:依据文案或参考图生成带音效的高保真片段,缩短创意到成片的距离。
- 影视与动画预演:用物理规律一致的镜头快速验证分镜与运镜方案,降低预演成本。
- 电商与社媒内容:批量产出符合品牌调性的商品展示与种草视频,支撑高频更新。
- 教育与科普演示:将抽象的物理过程(如碰撞、惯性)可视化为连贯动画,提升讲解直观度。
- 产品三维展示:为电商与工业产品生成可旋转视角的演示动画,突出材质与结构细节。
适用人群:广告与短视频团队、影视/动画预演人员、电商内容运营,以及需要可控物理质感视频的 AI 创作者。
HiDream-O1-Video-1.0 的使用方法
- 提交体验申请:访问 HiDream-O1-Video-1.0 官网(智象未来),在页面填写体验申请表,提交后等待内测资格开通通知。
- 准备输入素材:整理文本描述、参考图像或参考视频,并在描述中明确镜头、时长、运镜与音效意图,越具体生成越稳定。
- 提交生成任务:在开放平台按提示传入多模态条件,设定目标时长(5–20 秒)与分辨率(1080p)后提交生成。
- 评审与迭代:查看成片并核对物理一致性与音画同步,若偏离意图则调整提示词或参考素材后再次生成。
HiDream-O1-Video-1.0 的价格与开源情况
HD-V1 目前处于内测阶段,由智象未来通过官网体验申请分批开放,正式商用价格尚未公布。后续上线后预计以平台调用或订阅方式计费,具体单价、免费额度与企业版权益以官方公示为准。
HD-V1 未开源,不提供模型权重或本地部署版本,仅通过智象未来官方平台使用。需要自托管视频生成能力的团队,可关注阿里万相等开源视频方案作为替代,但其在物理规律与音画一体化上的表现与 HD-V1 不在同一层级。
HiDream-O1-Video-1.0 的常见问题
HiDream-O1-Video-1.0 是什么?
是智象未来于2026年9月发布的原生全模态视频生成模型,支持文本、图像、视频多条件驱动,主打物理规律理解与音画原生一体化生成,可一键直出 5–20 秒 1080p 高保真视频。
HD-V1 支持哪些输入?
支持文本、图像与视频多模态输入,可依据自然语言描述与参考素材生成 5–20 秒 1080p 高保真视频,并能根据叙事逻辑自主规划生成时长,同时支持对镜头、运镜与音效意图的细粒度控制。
HD-V1 现在可以免费使用吗?
目前处于内测阶段,需通过官网填写体验申请表获取资格,尚未公布公开价格与计费方式;正式商用后预计以平台调用或订阅计费。
HD-V1 与阿里万相 Wan 有什么区别?
万相 Wan 是阿里巴巴推出的图像与视频生成模型,画面为主、音效后期;HD-V1 是智象未来的原生全模态视频模型,核心差异在于把物理规律与音画一体化作为架构级能力,而非后期处理。
相关文章


 浙公网安备33010202004812号