
Models.dev 是一款由 OpenCode 团队于 2025 年 6 月开源发布的模型参数索引工具,主要用于集中查询各厂商模型的价格与规格信息,支持 TOML 数据格式与公开 JSON 接口读取,适用于选型比价、成本估算与内部看板搭建等场景。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 多厂商 AI 模型参数与价格索引 |
| 出品方 | OpenCode 团队 |
| 发布时间 | 2025 年 6 月 4 日(GitHub 仓库创建日) |
| 数据格式 | TOML,模型与服务商分层 |
| 对外接口 | 公开 JSON:api.json、models.json、catalog.json |
| 覆盖字段 | 价格、上下文窗口、工具调用、知识截止等 |
| 覆盖范围 | OpenAI、Anthropic、Google 等主流厂商 |
| 使用门槛 | 无需注册;公开接口免费 |
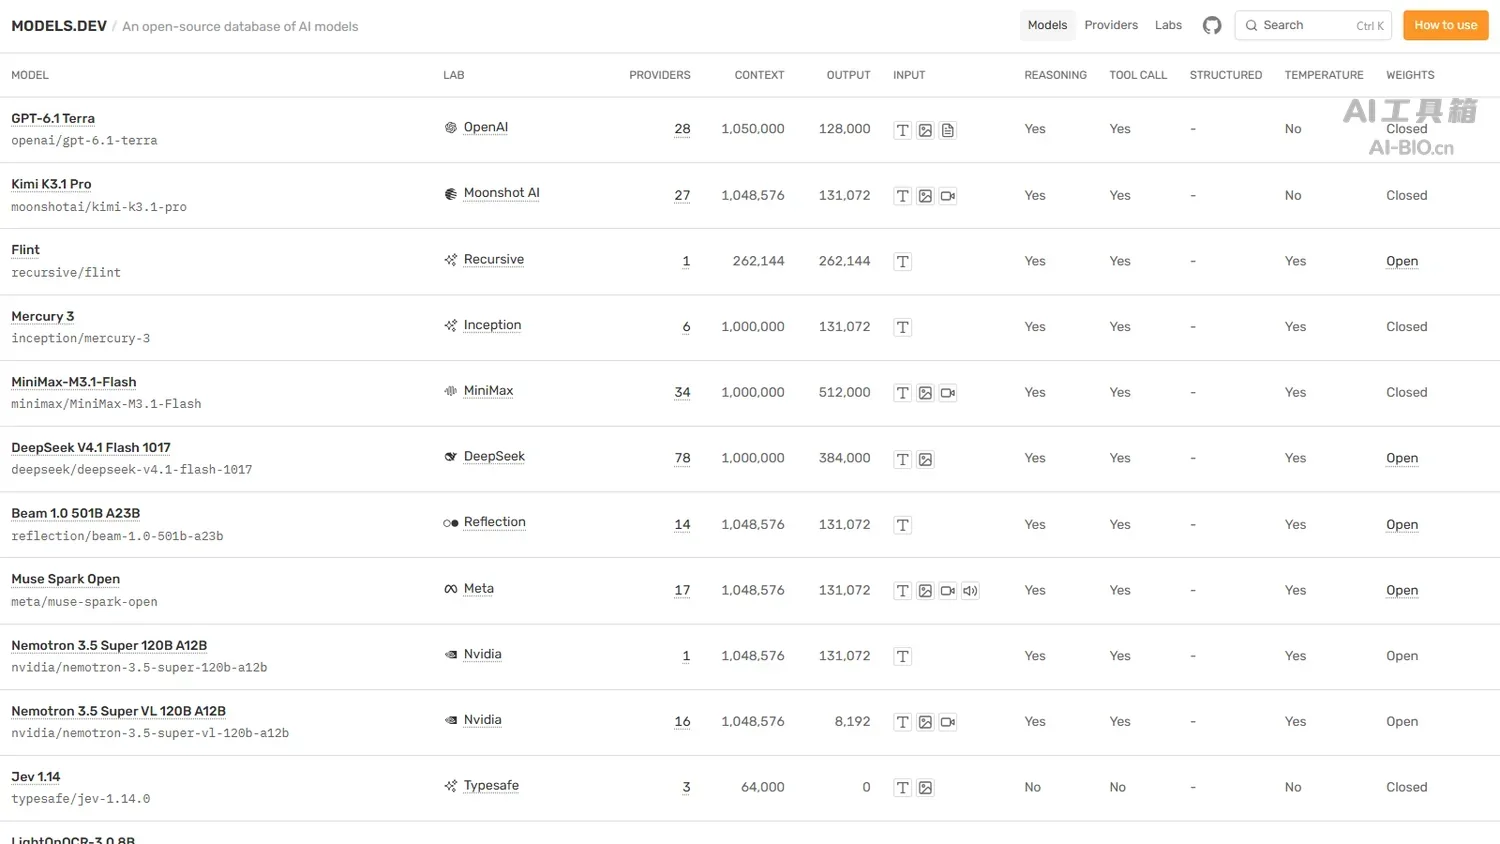
Models.dev 的核心能力
Models.dev 不生成内容,只解决一件事:同一个模型在不同渠道、不同页面写着的参数总对不上。它把这些字段收进一套固定格式,让比价从翻文档变成读一个文件。
把参数写成结构化文件
仓库用 TOML 分两层维护:models 存模型本身的事实,如名称、知识截止、上下文与模态;providers 存同一模型在各服务商处的部署信息,如 API 价格、缓存计费与服务状态。文件以 schema = 2 开头,经统一校验后生成供网站与程序读取的 JSON。同一模型在 OpenAI 与 OpenRouter 的价格可分别记录,不必当成两个基础模型。像 Naive-N0.5-Flash 这类新模型也能按同一格式补进去。
给程序一个直接读的接口
站点提供三个公开 JSON 入口:api.json 给服务商与模型的组合数据,models.json 给模型基础元数据,catalog.json 给两者合并后的目录;特殊模型类型默认不返回,可加 type=all 取完整目录。选型脚本与内部比价看板都能直接消费。工程上通常每天定时拉一次全量数据并留存快照,以便追溯价格变化。
跨厂商拉齐口径
不同厂商对「上下文窗口」的算法不一样:有的算输入输出总和,有的只算输入。字段里 limit.context、limit.input、limit.output 也是分开记录的,比较规格时应分别看这三项,不能只按上下文窗口一个数判断实际可用容量。统一结构能减少口径混乱,但不等于消除厂商间的定义差异,用这类索引看数据时仍建议连同官方文档核对。
可以基于现有格式维护私有清单
数据格式是明文,团队可以照同样的结构维护自己实际在用的模型子集,把内部价格、配额与限流规则一起写进去。这样对外部数据的依赖就降到了「参考」,而不是「唯一来源」;若要复用官方项目的解析与校验能力,需遵循对应 Schema,不宜随意增删字段。选型对比时可配合站内 Step 5 Preview 这类旗舰型号的参数一起看。
Models.dev 与同类模型信息源的对比
下表从形态、数据格式、接口形态与收费方式等维度,把三款模型信息源放在一起对照。
| 对比维度 | Models.dev | OpenRouter 模型列表 | LiteLLM 模型表 |
|---|---|---|---|
| 形态 | 开源模型数据库 | 模型聚合与调用平台 | 多模型调用与路由框架 |
| 数据格式 | TOML 明文,可自行维护 | 平台目录页 | JSON 价格配置与公开目录 |
| 接口形态 | 多个公开 JSON 接口 | 公开模型列表 API | 模型目录 API |
| 收费方式 | 数据库与公开接口免费 | 调用模型时按量计费 | 开源框架免费,模型调用另计 |
| 覆盖重点 | 参数与价格字段齐全 | 可调用性与定价 | 与网关路由相关字段 |
| 使用门槛 | 浏览器或 HTTP 请求 | 目录公开可查,调用需 API 凭证 | Python 环境或 API 接口 |
- 表格内数据来源:Models.dev 取站点结构与仓库说明;OpenRouter 模型列表取站内已有页面与官方文档;LiteLLM 模型表取官方仓库。三个对照产品中只有 OpenRouter 有站内页面,已在表头加链,另两项以纯文本呈现。
- 产品对比简述:Models.dev 在数据格式上用分层 TOML,OpenRouter 模型列表在数据格式上是平台目录页、在使用门槛上目录公开可查而调用需凭证;LiteLLM 模型表在数据格式上是 JSON 价格配置。三者分别侧重元数据、聚合调用与路由接入。
把这类清单接进自己的工具链时,站内的 EchoBird 是一个看「多模型怎么统一管理」的参照。
Models.dev 的应用场景与适用人群
需要反复回答「这个模型多少钱、能吃多长上下文」的时候,这套索引省的是查文档的时间:
- 选型比价:把候选模型的单价与上下文窗口放同一张表里比较。
- 成本估算:按业务实际用量换算月账单,避免只看单价。
- 内部看板:定期拉
api.json做成团队可查的模型清单页面。 - 私有清单维护:照同样格式记录自己在用的模型子集与配额。
- 价格监控:定期拉接口比对关键模型单价,调价时第一时间发现。
适用人群:适合要频繁做模型选型的技术负责人、需要把模型清单接进内部系统的平台团队,也适合写选型脚本的开发者;只想调一次接口试效果的普通用户,直接去厂商控制台更快。调用方工具可对照站内 Command Code。
Models.dev 的使用方法
三条路径从轻到重:在线查一眼、脚本读接口、把数据拉到本地自建一套。
在线查询:先看有没有这个模型
- 打开 models.dev,按厂商筛选或直接搜索模型名。
- 在模型详情里核对价格单位与上下文窗口,注意有的厂商按百万 token 计、有的按千 token 计。
- 把关键字段截图或记录,与厂商官方文档交叉核对一次再用于决策。
接口读取:接进脚本与看板
- 按用途选接口:
api.json看组合数据、models.json看基础元数据、catalog.json看合并目录,缓存到本地避免频繁拉取。 - 按业务需要的字段做筛选:先按是否支持工具调用过滤,再按上下文窗口排序。
- 把价格字段换算成统一口径(每百万 token),再做横向比较。
本地维护:按 Schema 建私有清单
- 克隆仓库,把 TOML 文件按厂商与模型分目录浏览一遍,理解字段含义。
- 只保留团队实际在用的模型,补上内部的配额与限流规则。
- 用同一套脚本同时读外部与私有清单,外部数据作为参考、私有数据作为准绳。
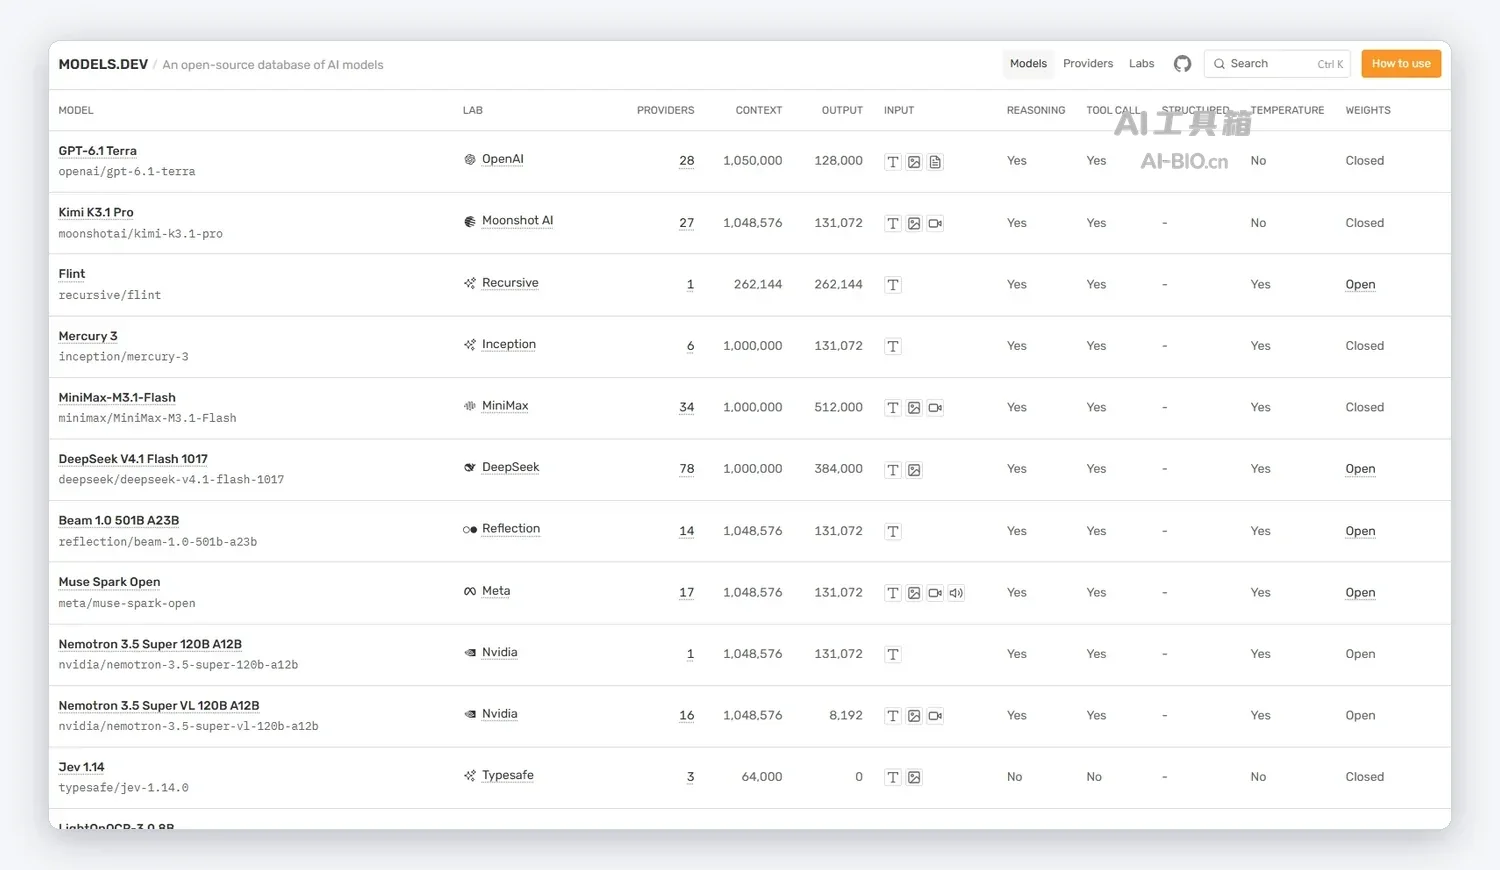
两点要留意:第三方索引的字段可能滞后于厂商调价,做预算前务必回官方核一次;不同厂商对上下文窗口的统计口径不同,直接比大小容易得出错误结论。
Models.dev 的项目地址
- 站点:https://models.dev/
- GitHub 仓库:https://github.com/anomalyco/models.dev
Models.dev 的价格方案
项目采用 MIT License,仓库与官网公开 JSON 接口都免费开放,无需注册;开发者可在遵守许可证条件的前提下使用、修改与集成其数据,没有付费档位。但公开接口不等于承诺无限制访问,官方未声明速率与额度规则,实际集成建议做好本地缓存与请求频率控制。项目不含模型推理能力,因此不存在「按次收费」的环节。
真正的成本在使用侧:按索引选完模型后,调用费归厂商收。这份数据能帮你看清单价,但不会替你省钱——省不省取决于换算方式,比如把按千 token 计价的字段统一成每百万 token 再比较。
若用于商业产品,建议在系统里标注数据来源与抓取时间。模型价格变动频繁,历史报价类内容可参考站内 关于 DeepSeek 调价的观察,理解调价对账单的实际影响。
Models.dev 的常见问题
数据是谁维护的
由 OpenCode 团队维护,仓库公开、数据文件可查。由于是社区维护的索引,个别字段可能滞后于厂商最新公告,关键决策前建议回官方文档核对。
和厂商文档有什么区别
厂商文档按自家口径写,字段名称和单位各不相同;Models.dev 把字段拉齐到一套结构里,方便横向比较。代价是可能丢细节,深度评估仍需回官方文档。
接口有调用限制吗
站点提供公开 JSON 接口,官方未声明付费额度,也没有承诺无限请求或速率上限。工程上仍建议本地缓存、控制拉取频率,既省带宽也避免给站点添压力。
能直接用在自己的产品里吗
项目以 MIT License 发布,商业使用、修改与再分发在遵守许可证条件的前提下允许;数据可以明文维护,但若要复用官方的解析与校验能力需遵循对应 Schema。另建议在产品内标注数据来源与更新时间,避免读者误以为是实时数据。
覆盖中文模型吗
覆盖范围以主流厂商为主,国内外厂商均有收录。具体某个中文模型是否在内,建议直接在站点搜索确认,本文不作未核验的覆盖数量承诺。
相关文章


 浙公网安备33010202004812号