
Stable Audio 3 是一款由 Stability AI 于 2026 年 5 月推出的开放权重音频生成模型家族,主要用于按文本或音频样本生成音乐与音效并完成后续编辑,支持文本生成、音频改写与局部重绘三种模式,适用于配乐批量生产、音效补齐与片段改写等场景。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 面向音乐与音效生成的音频扩散模型家族 |
| 出品方 | Stability AI |
| 发布时间 | 2026 年 5 月 20 日 |
| 开源协议 | 代码 MIT;权重为社区许可,年收入超 100 万美元需企业授权 |
| 规格档位 | Small-Music、Small-SFX、Medium、Large 四档 |
| 参数规模 | Small 433M、Medium 1.4B、Large 2.7B(官方仓库规格表) |
| 最长时长 | Small 120 秒;Medium 与 Large 380 秒(6 分 20 秒) |
| 运行硬件 | Small 可 CPU 或 CoreML;Medium 可 CUDA 或 MLX;Large 走 API |
| 权重发布 | Hugging Face collections/stabilityai/stable-audio-3 |
| API 计费 | 8 credits / 次(1 credit = 0.01 美元) |
Stable Audio 3 的核心能力
Stable Audio 3 的路线和其他音乐生成产品不太一样:它把模型切成四档,让同一套权重既能跑在 MacBook 的 CPU 上,也能挂在 API 后面。以下三块是这个切分带来的实际差别。
四档规格对应四种硬件
Small-Music 与 Small-SFX 均为 433M、配 SAME-Small,支持 CPU 与 Apple Silicon 推理,最长 120 秒;Medium 为 1.4B 配 SAME-Large,标准方案用 CUDA GPU,另有 MLX 路径,最长 380 秒;Large 为 2.7B,普通用户走 API,企业可申请自托管,公开仓库不提供该档权重。参数以官方仓库规格表为准。
三种推理模式共用一套权重
除文本生成音频外,还支持音频到音频的改写与局部重绘(inpaint):给一段已有音频,指定要改的片段重新生成,其余部分保留。对已经有素材、只想换一段副歌或补一个音效的场景,这比整段重生成省时也省一致性。
延迟压到秒级
官方实测:small 生成 120 秒音频在 H200 上 0.45 秒、配 TensorRT 后 0.044 秒;medium 生成 380 秒为 1.31 秒、配 TensorRT 0.43 秒。峰值显存上,Medium 生成 380 秒约需 6.52GB;120 秒场景下分块解码可从 6.49GB 降至 5.14GB,两个数字对应不同生成时长,不能混用。 站内 AuK 从语音生成与编辑的角度给了另一种切法。
同门工程经验的直接继承
仓库自述是 stable-audio-tools 的后继:只保留推理与微调需要的部分,把基础研究与旧模型相关工作留给旧仓库。对只想完成推理的人来说,少掉一大截环境依赖。需要做 foundational research 的团队仍应回到旧仓库。
Stable Audio 3 与同类音乐模型的对比
下表从权重开放度、最长生成时长、运行方式与计价方式等维度,把三款音乐生成产品放在一起对照。
| 对比维度 | Stable Audio 3 | Mureka V9.5 | Magenta RealTime 2 |
|---|---|---|---|
| 出品方 | Stability AI | 昆仑万维 | 谷歌 Magenta |
| 权重开放度 | 四档中三档可下载,代码 MIT | 以官方平台为主 | 开源权重 |
| 最长生成时长 | 380 秒(Medium / Large) | 以官方说明为准 | 以官方说明为准 |
| 编辑能力 | 音频改写与局部重绘 | 以官方说明为准 | 以官方说明为准 |
| 运行方式 | CPU、GPU 本机或 API | 官方平台 | Apple Silicon Mac 本地运行 |
| 计价方式 | API 8 credits/次;自部署仅算力成本 | 官方订阅或点数 | 自部署仅算力成本 |
| 典型用途 | 配乐生产、音效补齐与片段改写 | 整曲创作与演唱 | 实时交互式音乐生成 |
- 表格内数据来源:Stable Audio 3 取官方仓库 README、发布说明与定价页;Mureka V9.5 与 Magenta RealTime 2 取各自官方发布说明,未公开的项标注「以官方说明为准」,不作推测。
- 产品对比简述:Stable Audio 3 在权重开放度上覆盖三档、以编辑能力见长;Mureka V9.5 在典型用途上偏整曲演唱创作;Magenta RealTime 2 的运行方式侧重 Apple Silicon Mac 上的实时交互。三者的计价方式也不同,自部署与订阅不可直接比价。
如果更在意「先写谱再渲染」这种可控性更强的路线,站内的 YuE2 是可以对照着读的另一条思路。
Stable Audio 3 的应用场景与适用人群
手上已有素材、只缺某一段声音,或者需要成批生成同一风格的配乐时,这套模型省的是往返沟通的时间:
- 短视频配乐:按画面节奏批量生成片段,长度不够时直接续写。
- 游戏与交互音效:Small-SFX 支持 CPU 本地推理,适合轻量级音效生成与本地化音频处理,实际交互延迟取决于设备性能与生成时长。
- 片段改写:已有成品只想换副歌或某一句,用局部重绘避免整段重做。
- 素材补齐:给一段人声或环境音补上与场景匹配的背景层。
适用人群:适合手上已有制作流程、需要把音频生成接进流水线的音乐与视频团队,也适合愿意在本机折腾权重、把成本压在算力上的个人创作者;只需要偶尔生成一段完整歌曲、不打算做二次编辑的用户,整曲类平台更省事。同类的整曲生成路线可对照站内 MiniMax Music 3.0。
Stable Audio 3 的使用方法
三条路对应三种投入:想先听效果走网页、想接产品走 API、想把成本压在算力上就走本机权重。
在线试听:先在 Space 里跑一遍
- 打开 Hugging Face 上
stable-audio-3的演示 Space,用文本描述生成一段 30 秒左右的样音。 - 对同一段描述换关键词再生成一次,确认风格控制的稳定性。
- 把满意的提示词记下来,作为后续 API 或本机调用的基线。
API 接入:按 credits 计费
- 在 Stability AI 平台 注册并领取账号赠送的 credits,再按需充值。
- 调用 Stable Audio 3.0 的
text-to-audio接口生成音频,需要局部修改时改用 inpaint 接口并指定片段。 - 先按单次 8 credits 估算日均成本,确认量级后再决定是否转自部署。
本机部署:按显存与时长选档
- 从 Hugging Face 取 Small 档权重,可在纯 CPU 环境跑 120 秒以内的生成。
- 需要 380 秒长音频时换成 Medium 权重,配 CUDA GPU;峰值显存按 6.5GB 估算,分块解码可降到 5.1GB 左右。
- 显存紧张时逐段生成再拼接,注意拼接处的结构连贯性,或改用局部重绘补过渡。
三点要留意:Large 档只提供 API,权重无法本地加载;权重用的是 Stability AI 社区许可而非代码的 MIT,商用前要单独看条款;模型的 380 秒上限是按单次生成算的,需要更长音频时要自己做分段与衔接。
Stable Audio 3 的项目地址
- 官方发布说明:https://stability.ai/news-updates/meet-stable-audio-3-the-model-family-built-for-artistic-experimentation-with-open-weight-models
- GitHub 仓库:https://github.com/Stability-AI/stable-audio-3
- Hugging Face 权重:https://huggingface.co/collections/stabilityai/stable-audio-3
Stable Audio 3 的价格与开源情况
代码以 MIT 在 GitHub 发布,权重在 Hugging Face 以社区许可发布,Small 与 Medium 两档可下载自部署,不向 Stability AI 付费,成本落到自己的 CPU 或 GPU 上。Large 档不提供公开权重,普通用户走 API,企业客户可申请自托管部署。
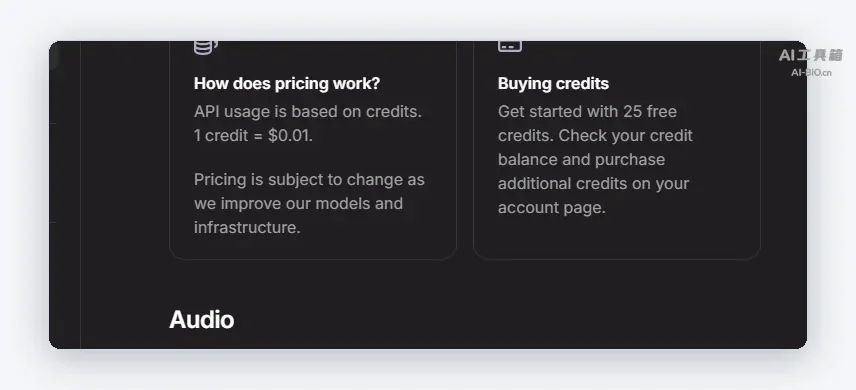
API 按 credits 计费,1 credit 等于 0.01 美元,一次 Stable Audio 3.0 生成消耗 8 credits,折合约 0.08 美元;新注册账号赠送 25 credits,够试跑三次左右。官方说明 credits 单价会随模型与基础设施改进调整,实际以定价页为准。
自部署的账要算两块:算力与工程时间。Small 档在 CPU 上就能跑,适合低频使用;Medium 档需要 GPU,若日均生成量不高,API 的单价往往比自己养一张卡更划算。同类产品的自部署成本可对照站内 YuE2 的说明自行折算。
Stable Audio 3 的常见问题
和 Stable Audio 2.5 有什么区别
据官方定价页与仓库说明,3.0 单次最长可生成 6 分 20 秒(380 秒)音频,2.5 为三分钟;3.0 另提供了重新组织过的仓库结构与四档规格,代码从 stable-audio-tools 中拆了出来。
能在 MacBook 上跑吗
能。Small 两档配 SAME-Small 自编码器,官方实测在 Mac CPU 上 120 秒音频约 5.92 秒、CoreML 下约 3.09 秒;Medium 除标准 CUDA 方案外,官方还提供面向 Apple Silicon 的 MLX 优化路径,Mac 也能本地部署,只是不同后端的性能差异较大。
生成的音频能商用吗
代码是 MIT,权重采用 Stability AI 社区许可:年收入低于 100 万美元的个人与组织可免费商用,超过该门槛需另取 Enterprise License;走 API 时还受平台服务条款约束,正式商用前建议按模型卡与条款逐条确认。
支持中文提示词吗
官方说明模型主要用英文音频描述训练,其他语言表现可能下降,中文提示可尝试但不宜假定效果与英文相同;模型面向音乐与音效生成,不以语音或人声生成为目标。把风格、乐器、节奏、时长拆成短句描述,通常比长段中文更容易得到稳定结果。
Large 为什么没有公开权重
Large 为 2.7B 参数档,官方定位为质量上限,公开仓库不提供该档权重,普通开发者通过官方 API 调用;企业客户可联系 Stability AI 了解自托管部署方案。能本地下载的止步于 Small 与 Medium。
相关文章


 浙公网安备33010202004812号