
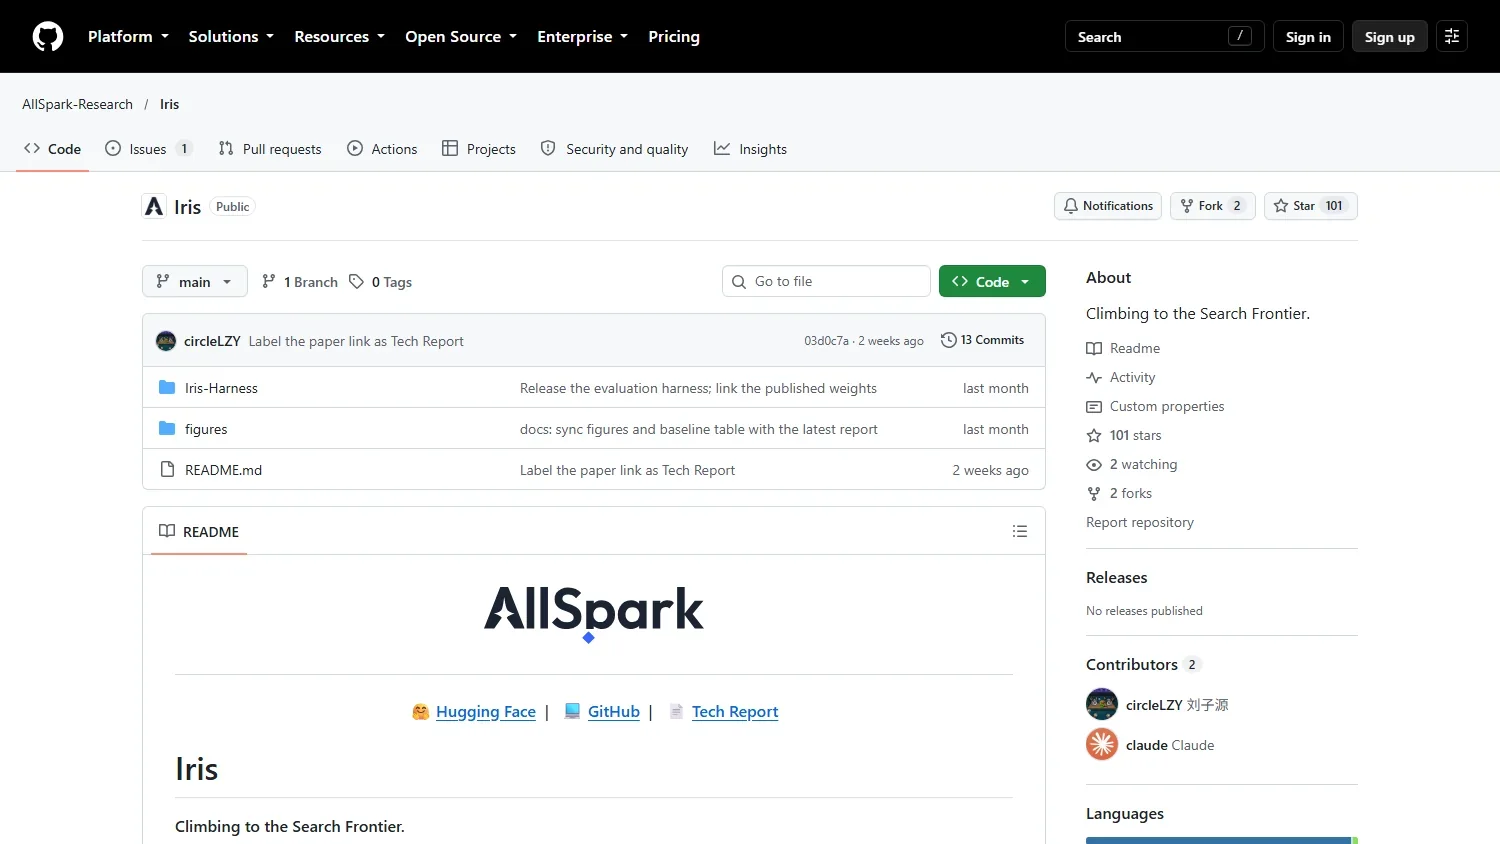
Iris是小红书 AllSpark 团队开源的搜索智能体,项目仓库于2026年9月建仓并开放权重。它含 mini 与 pro 两个版本,能在真实网络中自主决定搜什么、怎么读、何时收敛作答,通过从网页超链接反向构造训练数据,并在多个网页检索基准上取得同量级开源领先成绩,搜索能力还可外溢到通用工具调用任务。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 开源搜索智能体 |
| 发布时间 | 2026 年 9 月 1 日(仓库建仓) |
| 开源团队 | 小红书 AllSpark |
| 模型版本 | mini 与 pro 两档 |
| 训练方法 | 监督微调与强化学习交替 |
| 评测基准 | BrowseComp、DeepSearchQA、HLE 等 |
| 开源范围 | 权重与评测代码 |
| 部署方式 | 本地推理框架加载权重 |
Iris 的核心能力
传统检索问答往往停在关键词匹配,找到相似段落就算完成。Iris 的训练目标更靠后一步:让模型自己决定搜什么、读到何时收手,并给出覆盖完整证据链的答案。理解这类由模型自主完成检索决策的产品,可以先了解 AI 智能体 的执行方式。
自主网络搜索
模型自己决定搜什么、如何阅读检索结果、何时继续或停止,边搜边推理边作答。与固定流程的检索增强方式相比,这种自主决策让模型可以根据中间结果调整后续查询,而不是按预设步骤走完一遍。
多步跨页推理
模型能在多个网页之间逐步锁定唯一答案,而不是依靠关键词匹配走捷径。当答案需要串联多处信息才能推出时,多步跨页推理是把问题真正解决的关键,也是区分检索与理解的分界线。
证据覆盖型问答与难题求解
回答时完整覆盖证据链,并在需要专家级推理的高难度问题上具备求解能力。对深度研究与事实核查类任务,覆盖完整证据比给出一句结论更有价值,因为它留下了可以复核的路径。
上下文管理与能力外溢
模型支持截断与压缩等上下文管理策略,长链路搜索不中断,小模型从中获益尤为明显;未经专门训练,其搜索能力也可外溢到通用工具调用与办公协作等任务,说明检索是可以复用的原子能力。
反向造题的数据构造
团队以种子页面为答案,顺着超链接聚成实体图谱,在图谱上生成必须跨页多步推理的题目,再把题面中答案以外的实体改写成描述性指代以抹掉可匹配线索,最后用参考模型双重筛选,只保留闭卷答不出、给证据能唯一答对的样本,全程自动化并可随语料规模扩展。
训练与线上的一致性
训练阶段使用的判分与摘要模型同时用于评测与线上推理,减少了训练与使用之间的错位。对检索类模型,这种一致性意味着评测分数与实际表现之间的距离更小,调优方向也更明确。
面向开发者的部署路径
项目提供权重与评测代码,训练配方详见官方技术报告,团队可以按自己的检索工具与业务场景做二次适配。对希望把检索能力嵌进自有产品的开发者,这比直接调用通用模型接口更可控,也便于按需替换底层工具。
Iris 与同类搜索模型的对比
下表从模型定位、参数规模与检索基准几个维度,对比 Iris 与站内收录的 Kimi K3 两款具备检索能力的大模型。
| 对比维度 | Iris | Kimi K3 |
|---|---|---|
| 模型定位 | 以检索为核心的开源智能体模型 | 通用大模型,兼具智能体能力 |
| 参数规模 | mini 与 pro 两档,体量适中 | 万亿参数级通用模型 |
| 检索基准 | 多个网页检索任务上开源领先 | 单智能体表现靠前 |
| 参数效率 | 较小体量即可逼近超大模型水平 | 需大规模参数达到相近水平 |
| 开放性 | 权重与评测代码开源 | 开源权重,训练细节未公开 |
| 评测公平性 | 统一工具与判分,单智能体评测 | 部分成绩依赖多子智能体加成 |
| 能力外溢 | 未专门训练即可胜任通用工具调用 | 工具调用为通用能力 |
| 适用场景 | 深度研究与可复用的检索底座 | 综合问答与通用任务 |
上表 Iris 一列取自其开源仓库与官方发布说明,Kimi K3 一列取自其产品公开信息。两者的取向不同:Iris 把检索能力单独训练成一个可复用的原子模块,强调参数效率与评测公平;Kimi K3 是面向综合任务的通用大模型,检索只是其中一项能力。若需求集中在可溯源的深度检索,以检索为核心能力的模型在效率上更有优势。
如果希望先了解面向大众的通用对话与检索产品,可以参考 Kimi(一款提供长上下文理解与检索能力的对话助手,与 Iris 同属检索问答方向,差异在于 Kimi 面向日常问答场景,而 Iris 把检索能力单独训练成可部署的开源模型)。

Iris 的应用场景与适用人群
把检索决策交给模型之后,常见用途包括:
- 深度研究与调研报告:自动多轮检索、跨页推理并覆盖完整证据,适合行业研究、竞品分析与学术调研。
- 复杂事实核查:答案需跨多个网页多步锁定,适合辟谣、事实核查与尽职调查等必须找到出处的场景。
- 中英文双语搜索:在中文与英文网页检索任务上均保持领先,适合中英混合语料的跨境信息检索。
- 通用工具调用智能体:检索能力外溢到通用工具调用任务,可作为智能体产品的通用底座。
- 办公与文档协作:在办公类任务上无需专门训练即可上手,适合嵌入办公助手处理文档问答与流程任务。
- 跨境信息检索:中英混合语料的检索任务,在同一模型内完成切换。
适用人群:需要搭建可溯源检索能力的研究与情报团队、做深度调研的产品与咨询人员,以及希望用开源权重自建检索底座的技术团队。部署需要自备算力与检索工具接口,涉及联网检索的部分需自行确认合规要求。
Iris 的使用方法
官方仓库给出的部署与推理路径大致如下:
- 克隆代码仓库:执行
git clone https://github.com/AllSpark-Research/Iris获取推理与评测代码,仓库地址见 Iris 官方仓库。 - 下载模型权重:从官方模型库下载对应版本的权重文件。
- 配置运行环境:按仓库要求安装依赖的推理框架,并配置好搜索工具接口,联网检索是搜索智能体的必要前提。
- 加载模型并接入工具:以推理智能体的形式加载模型,把搜索引擎作为工具注册给模型调用。
- 提出问题运行推理:输入问题后,模型自动规划搜索查询、阅读网页、多步推理并收敛给出带证据的答案。
Iris 的价格与开源情况
Iris 以开源形式发布,权重、评测代码与训练相关材料均对外公开,模型本身不产生授权费用。使用成本主要来自推理算力与检索工具接口的调用,按实际部署规模自行估算。
自建检索底座需要准备推理框架与搜索接口,工程投入取决于现有技术栈。对已有算力与检索服务的团队,开源权重能显著降低长期调用成本;若只是偶尔使用检索问答,直接使用现有产品可能更省事。
Iris 的常见问题
Iris 是开源的吗?
是。权重与评测代码均对外公开,可自行部署与审查;训练配方详见官方技术报告。
Iris 有哪些版本?
提供 mini 与 pro 两档模型,前者体量较小、参数效率突出,后者能力更强,可按算力与效果需求选择。
Iris 的检索能力只能用于搜索吗?
不止。其搜索能力可外溢到通用工具调用与办公协作等任务,未经专门训练即可上手,适合作为智能体产品的通用底座。
运行 Iris 需要准备什么?
需要自备推理算力、部署对应推理框架,并配置搜索工具接口,因为联网检索是搜索智能体的必要前提。
Iris 与其他大模型的差别在哪?
它把检索能力单独训练成专用模型,强调参数效率与可复用的检索底座,而不是把检索作为通用模型的一项附带能力。
相关文章

 浙公网安备33010202004812号