

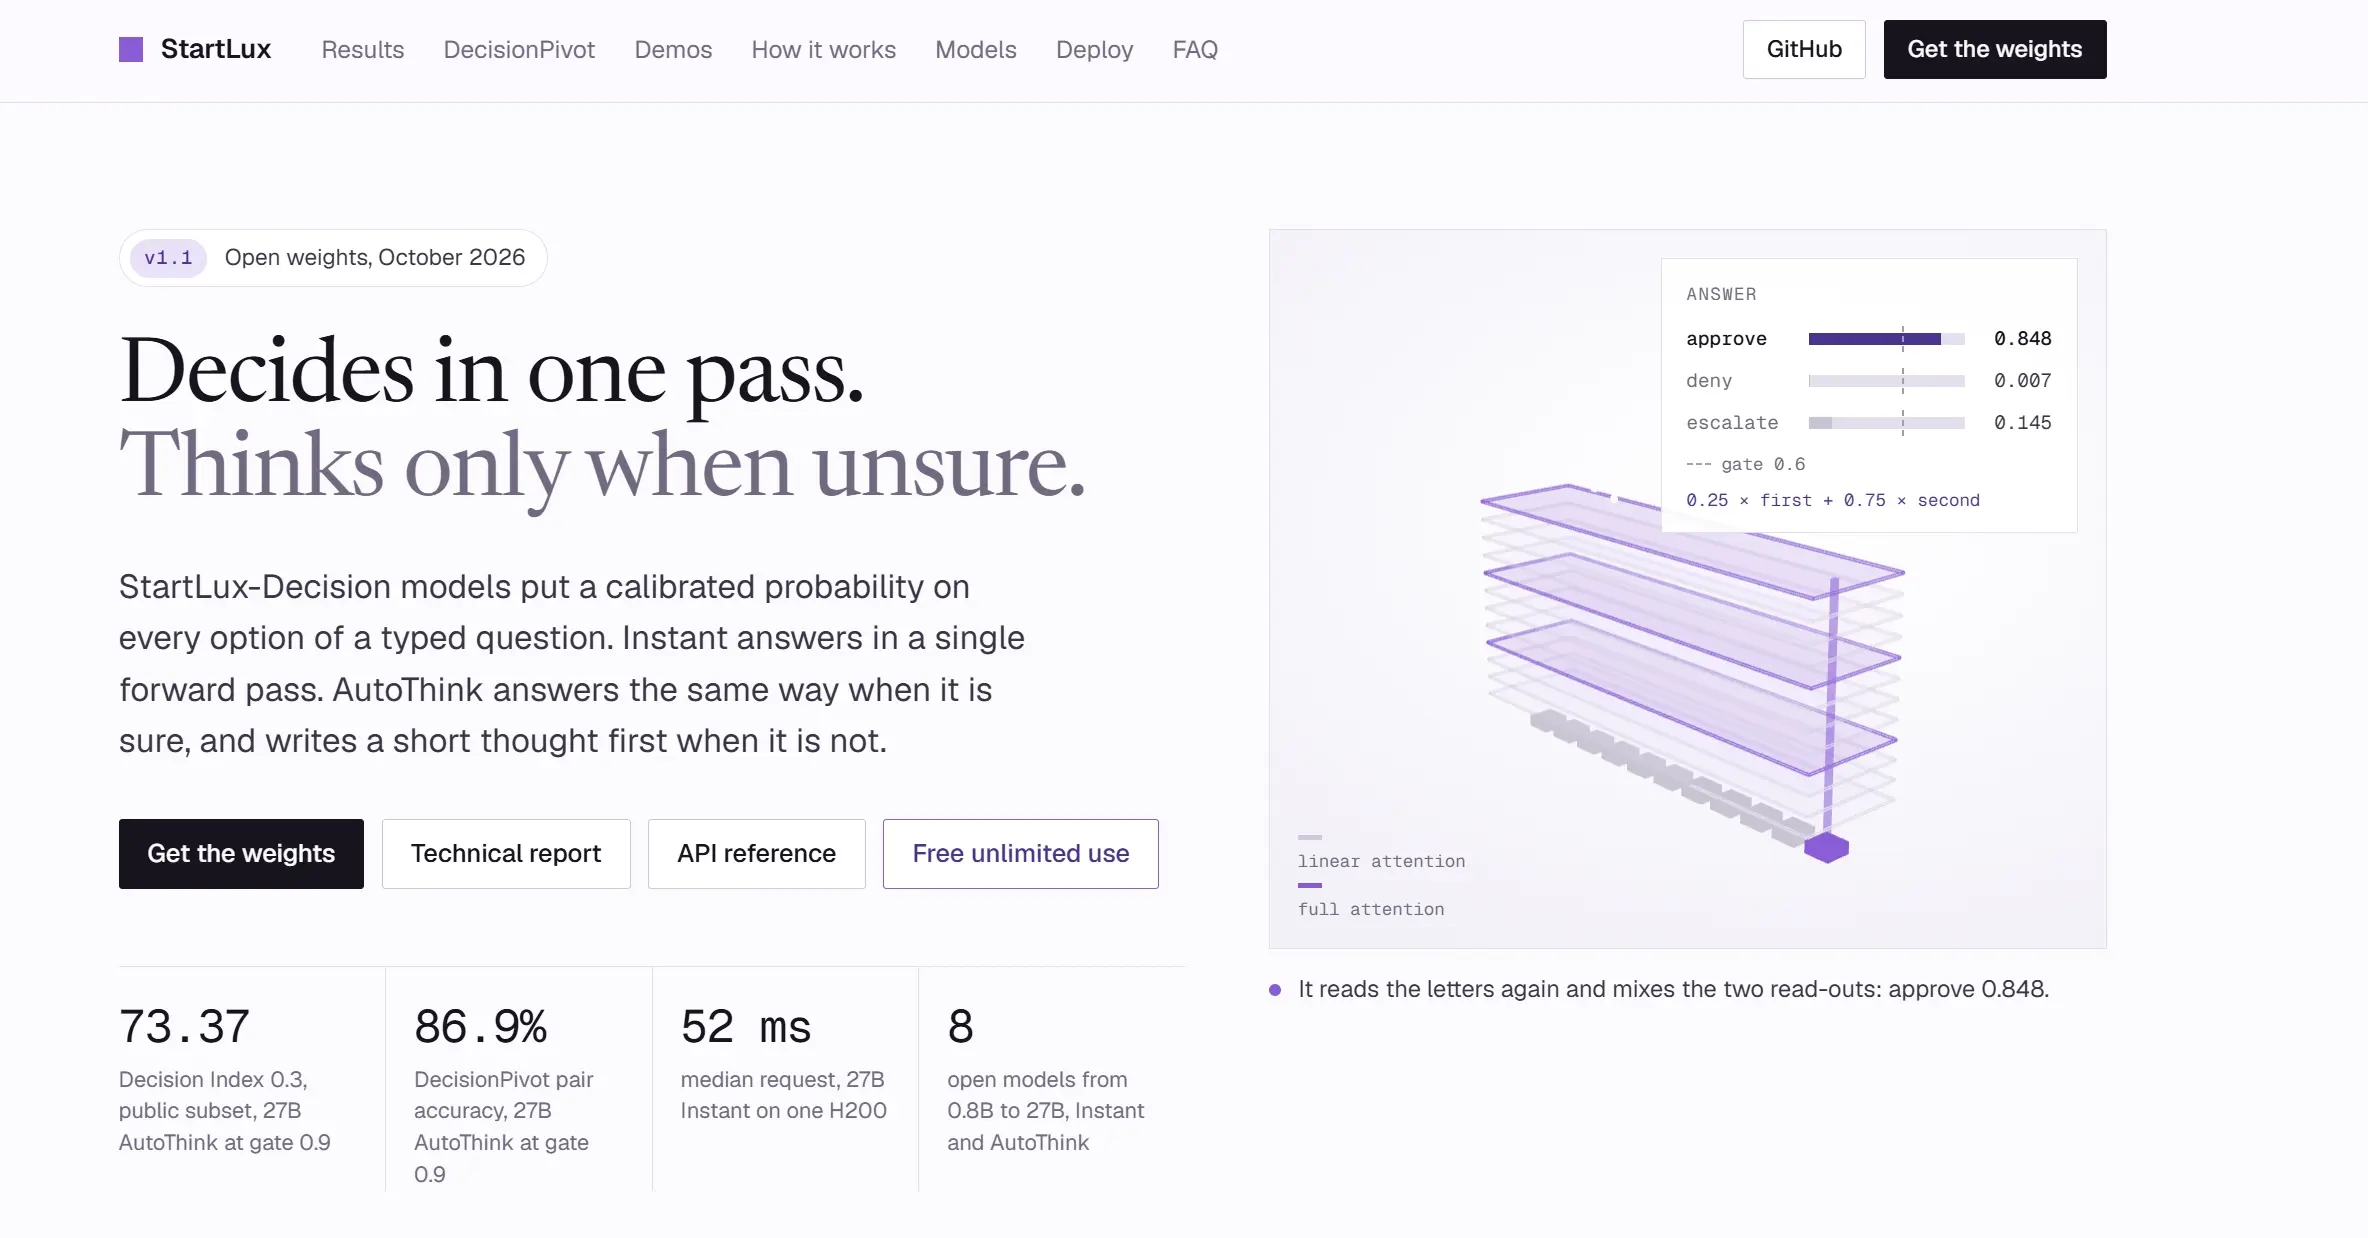
Startlux-Decision是StartLux Labs于2026年9月开源的决策模型家族,主要用于智能体执行任务时的高频判断环节,一次性提供 0.8B 至 27B 五档参数版本与 35B-A3B 混合专家版本,单次前向推理即返回各选项概率。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 开源类型化决策模型家族 |
| 出品方 | StartLux Labs(原点星辉) |
| 发布时间 | 2026年9月29日 |
| 参数版本 | 0.8B 至 27B 稠密 + 35B-A3B |
| 上下文长度 | 262,144 token |
| 决策类型 | 选择题、是非题、评分题 |
| 输入形态 | 文本、JSON 与图片 |
| 开源许可 | CC BY-NC 4.0 |
| 部署方式 | 自托管、GGUF 与 MLX |
Startlux-Decision 的核心能力
智能体执行任务时,大量判断并不需要写出一段文字,而是在若干预设选项里挑一个。每一步等待累积起来会直接影响整体效率,这类高频判断正是决策模型要解决的部分。理解这类组件在智能体里的位置,可以先了解 AI 智能体 的任务执行方式。
类型化决策输出
模型支持选择题、是非题与评分题三种问题类型,每个问题返回各选项的概率分布。模型把选项渲染为字母标记,答案从单次前向传播后对应字母位置的数值直接读出,不生成答案文本。
多模态状态输入
状态可以是文本、JSON 或图片,证据与图片都能作为请求的一部分参与判断。这条能力让模型可以直接读取界面截图或凭证图片作为决策依据,而不必先经过一次转写。
超长上下文与分块读取
全系列模型原生支持 262,144 token 的提示长度,长状态按块读取一次,请求中的每个问题再从各自的表示分支计算,避免重复编码带来的额外开销。
置信度可直接使用
每个问题返回的概率可以直接当作置信度使用,适合需要风险量化的自动化流程。与先生成文本再解析的方案相比,这种方式省去了格式校验环节,也更便于在流程里设定阈值。
多档参数与全平台部署
家族覆盖 0.8B 到 27B 的稠密版本以及 35B-A3B 混合专家版本,并提供 GGUF 量化权重用于本地推理,在 Apple Silicon 上还可以使用对应的后端。官方说明 35B-A3B 每个 token 仅激活约 3B 参数,延迟约为 27B 稠密模型的一半。
Startlux-Decision 与同类决策系统的对比
下表从产品性质、评测表现与部署方式等维度,对比两个常被放在一起评估的决策模型。
| 对比维度 | Startlux-Decision | Jev |
|---|---|---|
| 产品性质 | 开源决策模型家族,0.8B 至 35B 多档 | 闭源商业托管的决策服务 |
| 公开评测 | 27B 版本 Decision Index 0.2.1 得分 63.88 | 同榜单得分 57.91 |
| 基准对比 | 38 项基准中有 31 项领先 | 38 项基准中有 7 项领先 |
| 上下文长度 | 262,144 token | 未公开披露 |
| 图片输入 | 支持,全尺寸可用 | 未提及 |
| 输出形式 | 每个选项的概率分布 | 选项答案 |
| 部署方式 | 自托管,另提供 GGUF 与 MLX 支持 | 仅云端接口 |
| 接口兼容 | 采用 TypeSafe 的会话格式,原客户端可接入 | 自有接口 |
上表 Startlux-Decision 一列取自其官方项目说明,Jev 一列取自其公开资料。两者走的是同一条技术路线:不生成答案文本,而是直接对候选选项打分。差别在于开放程度与部署形态——Startlux-Decision 一次性开放了从小到大的多档权重,并附带量化版本用于本地推理;Jev 以闭源托管服务的形式提供,接入需要申请。需要在本机或内网完成判断的场景,前者的可选空间更大;希望免去运维的团队,后者更省事。
如果想了解这类决策模型通常嵌入在什么样的执行环境里,可以参考 Manus(通用型自主执行智能体,与 Startlux-Decision 同属智能体执行链路上的组件,区别在于前者负责整条任务的推进、后者只承担其中每一步的判断)。

Startlux-Decision 的应用场景与适用人群
把高频判断从文本生成里拆出来之后,常见用途包括:
- 智能客服分单:输入工单文本或图片,单次请求判断处理团队、是否加急与严重程度,各选项的概率可以直接作为置信度使用。
- 电脑操作自动化:驱动浏览器逐步选择控件并判断任务是否完成,官方演示了自动完成网页下单购物的完整流程。
- 游戏 AI 决策:单次前向输出走子、建造与射击等动作的概率,官方在棋类与即时策略类场景中做过验证。
- 金融风控与合规:覆盖合同条款核查、金融实体识别与钓鱼邮件甄别,输出的概率可以接入既有的风控流程。
- 企业检索与分类:以较低延迟完成意图识别、查询分类与检索结果的事实核查,适合请求量较大的业务场景。
适用人群:搭建智能体流程的应用开发团队,以及需要在本地或内网完成判断推理的工程人员。权重采用 CC BY-NC 4.0 许可,商业使用前需要核对许可条款,确认识别到的约束是否与产品形态相符。
Startlux-Decision 的使用方法
从下载权重到发起请求,可按以下步骤操作:
- 下载权重:用
hf download startlux-models/StartLux-Decision-v1-4B --local-dir StartLux-Decision-v1-4B从 Hugging Face 获取。 - 安装依赖:进入模型目录执行
pip install -r requirements.txt。 - 验证内核:运行
python -m startlux_decision.check StartLux-Decision-v1-4B,需要看到快速内核已激活的输出。 - 启动服务:执行
python -m startlux_decision.server --model StartLux-Decision-v1-4B --port 8090启动本地推理服务。 - 发送请求:向本地服务的会话接口发送 JSON,包含状态与问题列表,问题可以是选择、是非或评分类型。
- 读取结果:响应返回每个问题各选项的概率分布,可直接作为决策置信度使用。
- 量化部署(可选):下载对应的 GGUF 仓库后先启动本地推理服务端,再运行配套脚本在
llama.cpp之前提供决策服务。官方项目地址见 Startlux-Decision 官方仓库。
建议先按官方说明验证运行环境是否满足要求,再进入实际业务;接入生产流程前应结合自身任务做一轮评测,确认概率输出与真实准确率的关系,并据此设定阈值,而不是直接采用官方公布的基准分数。
Startlux-Decision 的价格与开源情况
Startlux-Decision 的权重以 CC BY-NC 4.0 许可在 Hugging Face 与 ModelScope 上开放下载,并提供支持本地部署的量化模型;该许可对商业使用有明确限制,商用前需要与官方确认授权方式。
模型本身不收取调用费用,成本来自本地推理所需的算力。官方说明家族覆盖从小到大的多个档位,实际选型时可以在延迟与准确率之间取平衡,先用小尺寸版本验证流程,再按效果决定是否换用更大的版本。
Startlux-Decision 的常见问题
Startlux-Decision 和普通大模型有什么区别?
它不生成答案文本,而是把候选选项渲染成字母标记,单次前向传播后直接读取对应位置的数值作为概率,因此延迟更低,输出也不需要再做格式解析。
Startlux-Decision 支持哪些输入?
状态可以是文本、JSON 或图片,全系列模型均可读取图片作为判断依据;问题类型覆盖选择题、是非题与评分题三种。
Startlux-Decision 可以商用吗?
权重采用 CC BY-NC 4.0 许可,对商业使用有限制,正式用于商业产品之前需要先与官方确认授权方式。
相关文章

 浙公网安备33010202004812号