
老高AI观察 · 第4期|2026 年 9 月 16 日
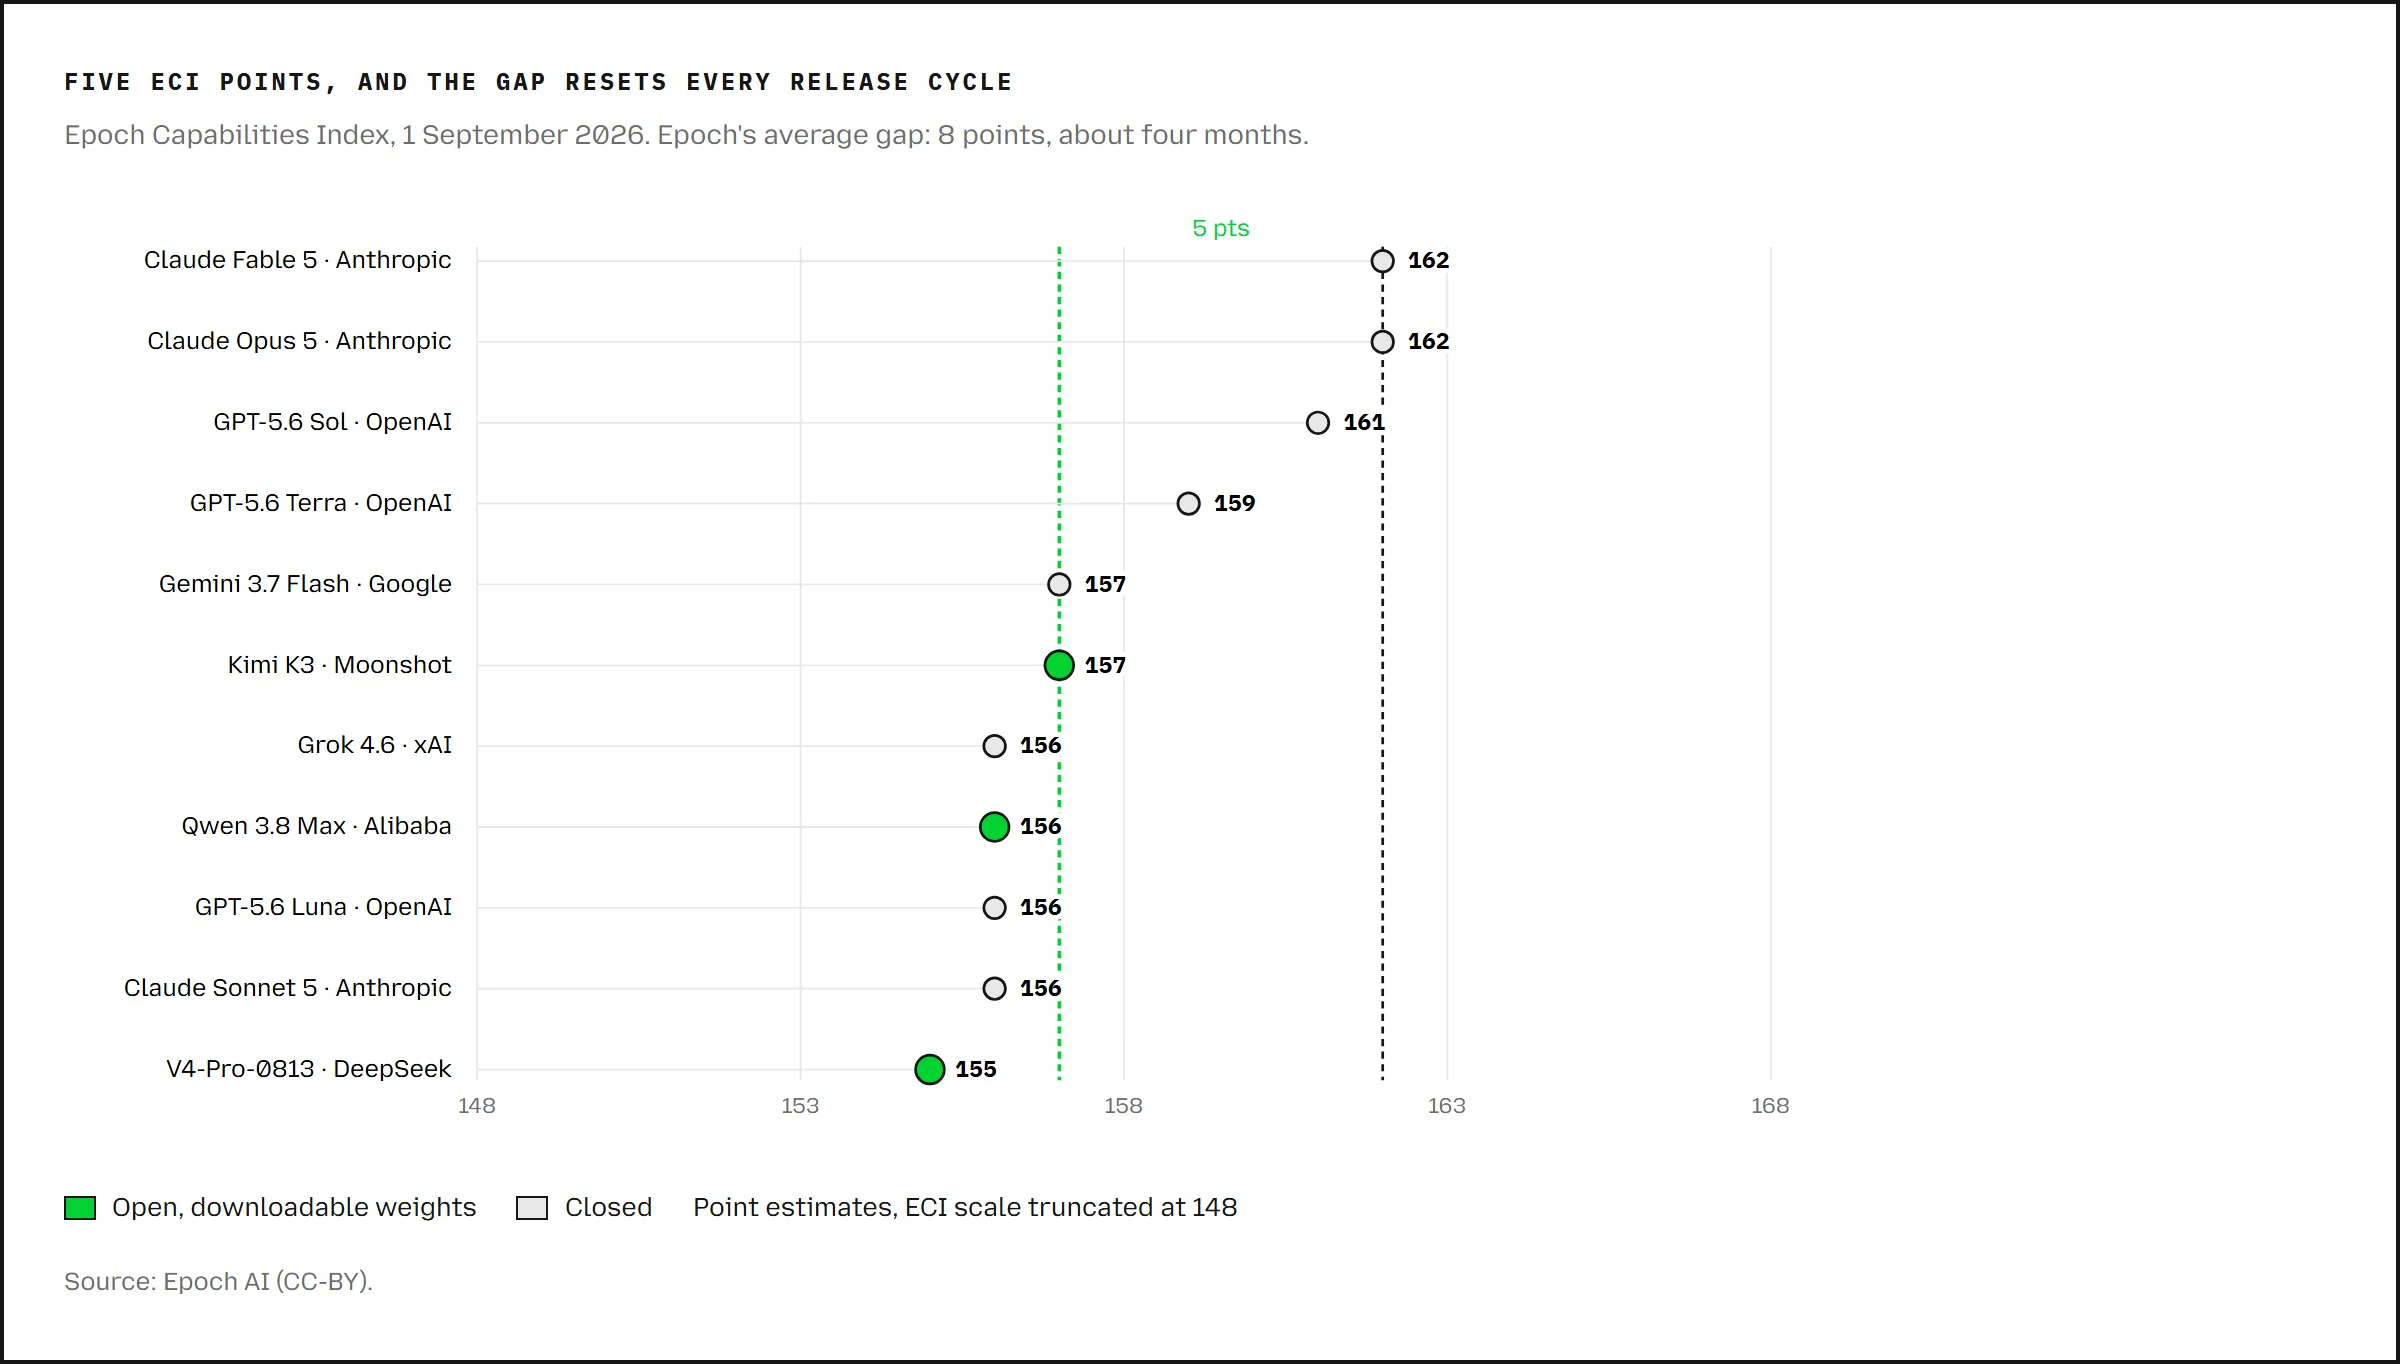
2026 年 9 月 15 日,Mozilla 放出第二版《State of Open Source AI》报告。有意思的是,就在前后这几天,Anthropic、OpenAI、谷歌接连发了新旗舰,全是闭源。报告里那个数字才真正扎人:按 Mozilla 测算,美国前沿闭源模型跟中国最好的开源模型,能力差距只剩 4.4 个月。我的判断是:闭源今天卖的不是”更强”,是”4 个月的时间差”。这 4 个月值不值那个价,不看厂商报价,看你手上的活有多长。
Mozilla 把闭源的溢价算成了一笔时间账
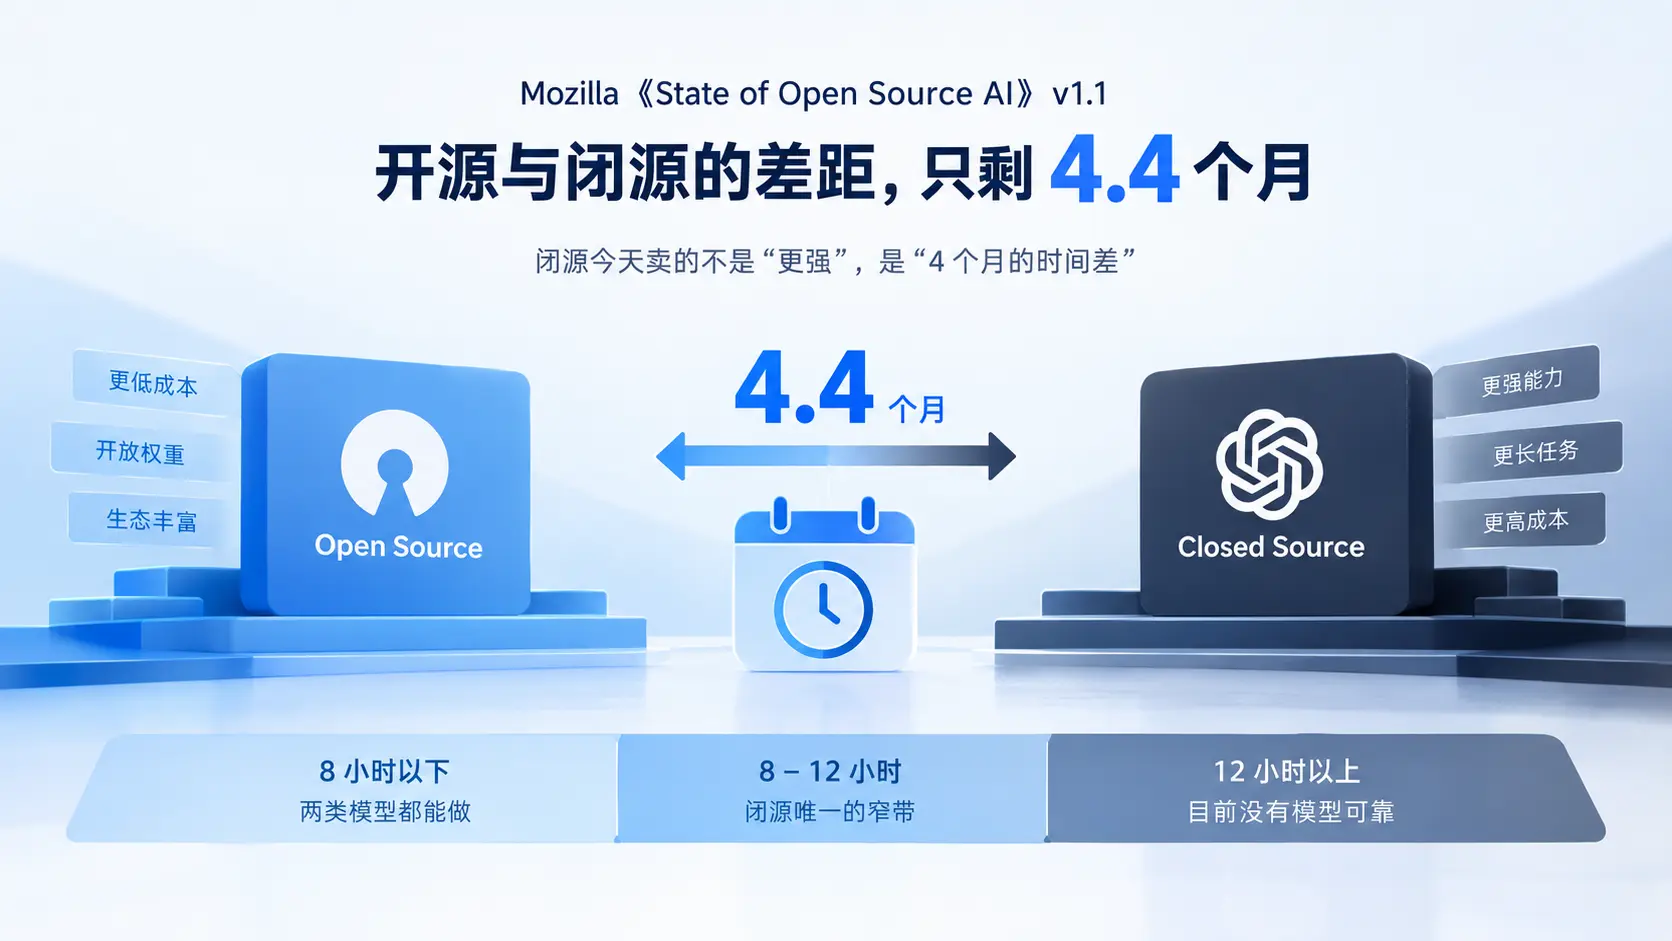
2026 年 9 月 15 日,Mozilla 发布《State of Open Source AI》v1.1(见 官方报告页);Ars Technica 在发布前拿到报告,做了独家解读(见 原文)。结论一句话:闭源前沿模型对中国头部开源模型的领先,只剩 4.4 个月。
报告给了几组互相印证的数字:
- Kimi K3 综合分 60.0,比 Claude Opus 5 低 3 分、比 Claude Fable 5 低 2.1 分,而标价只有 Fable 5 的 30%($3/$15 对 $10/$50);
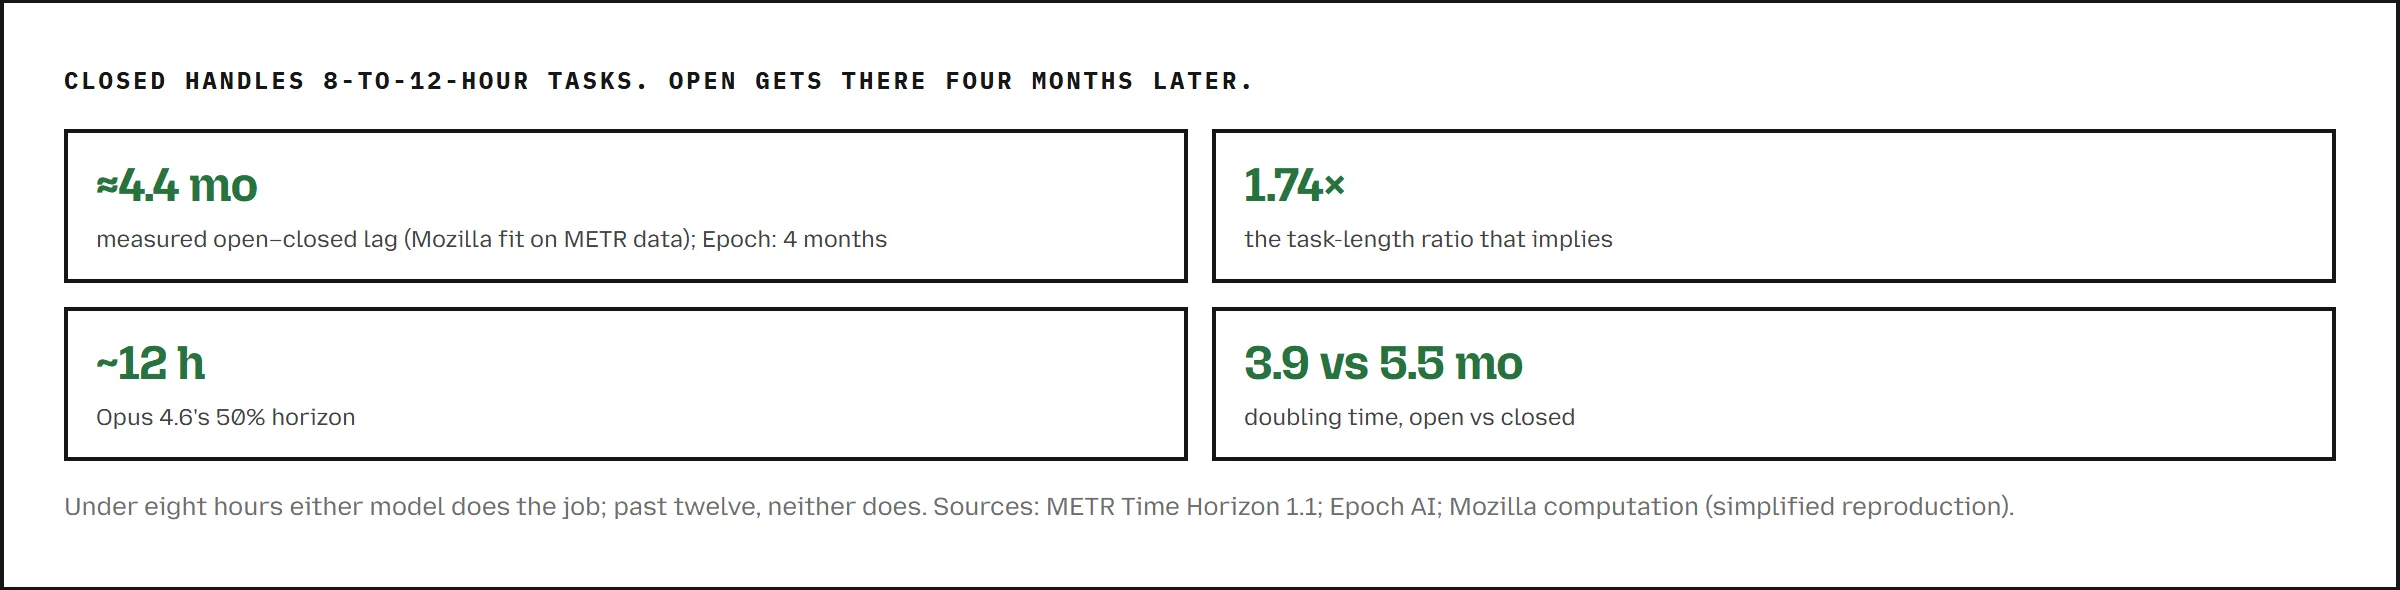
- 按 METR 口径,最强闭源能可靠完成的任务时长是最强开源的 1.7 倍——开源扛 7 小时,闭源扛 12 小时;
- Vals AI 用同一套中性 harness 跑基准,智谱 GLM 5.2 与 Claude Opus 4.7/4.8 只差不到 1 分,单任务成本约低 5 倍;
- OpenRouter 上 8 月 token 用量前十的模型,八个提供开放权重。
Mozilla CTO 基里科里安的原话是:8 到 12 小时,是闭源唯一还能做、开源还做不了的窄带;8 小时以下该交给便宜的;12 小时以上目前没有模型可靠。开源为什么追得快——”中国实验室在跑美国人对 Android 的那套剧本:送出去,但握住周边生态。”
被当作头号证据的两个模型站内都有页:Kimi K3(月之暗面开源的超长上下文模型)和 Claude Fable 5.1(Anthropic 的编程旗舰)。一份报告把”开源能不能用”,换成了”你愿不愿意为 4 个月多付几倍钱”。
为什么是现在
这不是第一版。首版 2026 年 7 月 14 日发布,不到两个月就出了 v1.1——更新速度本身就是信号。
第一,时间尺度在加速。METR 的规律是模型能可靠完成的任务时长按固定节奏翻倍,而节奏还在变快——翻倍一快,”领先几个月”的含金量就下降。
第二,企业已经在用真金白银切了。报告点名 DoorDash:常规工作交给 Kimi,难题留给 Fable。而 OpenRouter 这类按量计价的中转平台,把”哪家便宜换哪家”变成了改一行配置。
第三,闭源也没停。9 月一个月里 Fable 5.1、GPT-6 Astra、Gemini 3.8、Grok 4.7 密集发布。两边都在提速,结果不是拉开差距,是压缩差距。
不是开源追上了闭源,是”够用”的门槛被挪到了 8 小时
大部分人看到”差 4.4 个月”,第一反应是”那还是闭源强”。这话没错,但账没算完。分界不是”谁最强”,是”你这件活有多长”。
按报告口径:8 小时以下两类都能干;8 到 12 小时是闭源唯一的窄带;12 小时以上谁都靠不住。那问题就变朴素了——你日常跑的活里,有几个要”专家做满 8 小时以上”?
我的答案是没有。写稿、选品调研、扒竞品、改代码,实际耗时都在几十分钟到几小时,属于”开源够用”那一档。要连续跑 8 小时的活,多半也不是为省时间。
所以”开源追上了闭源”不准确。准确的说法是:“够用”的门槛挪到了 8 小时,而绝大多数人的活都在门槛以下。天花板还在闭源那边,但你够不到。
被定价的不是能力,是时间
换个角度算账:如果闭源的领先被定义成”4 个月”,它卖的就是一个期权。真问题不是”开源何时追上”,是”这个期权值不值得买”。
报告的回答我认同:值得买的场景很窄,比如截止日期正好落在开源追上来之前;”下季度还要做的常规工作”就不值得——很快能用五分之一成本干完。
有个容易看漏的细节:不同口径的”贵”不是一回事。5 倍是单项基准 Terminal-Bench 上的单任务成本,不是通用定价比;报告同时提到开放模型在全球 AI 收入里只占约 4%(数据窗 2025 年 5-9 月,已偏旧)。钱还在闭源那边。
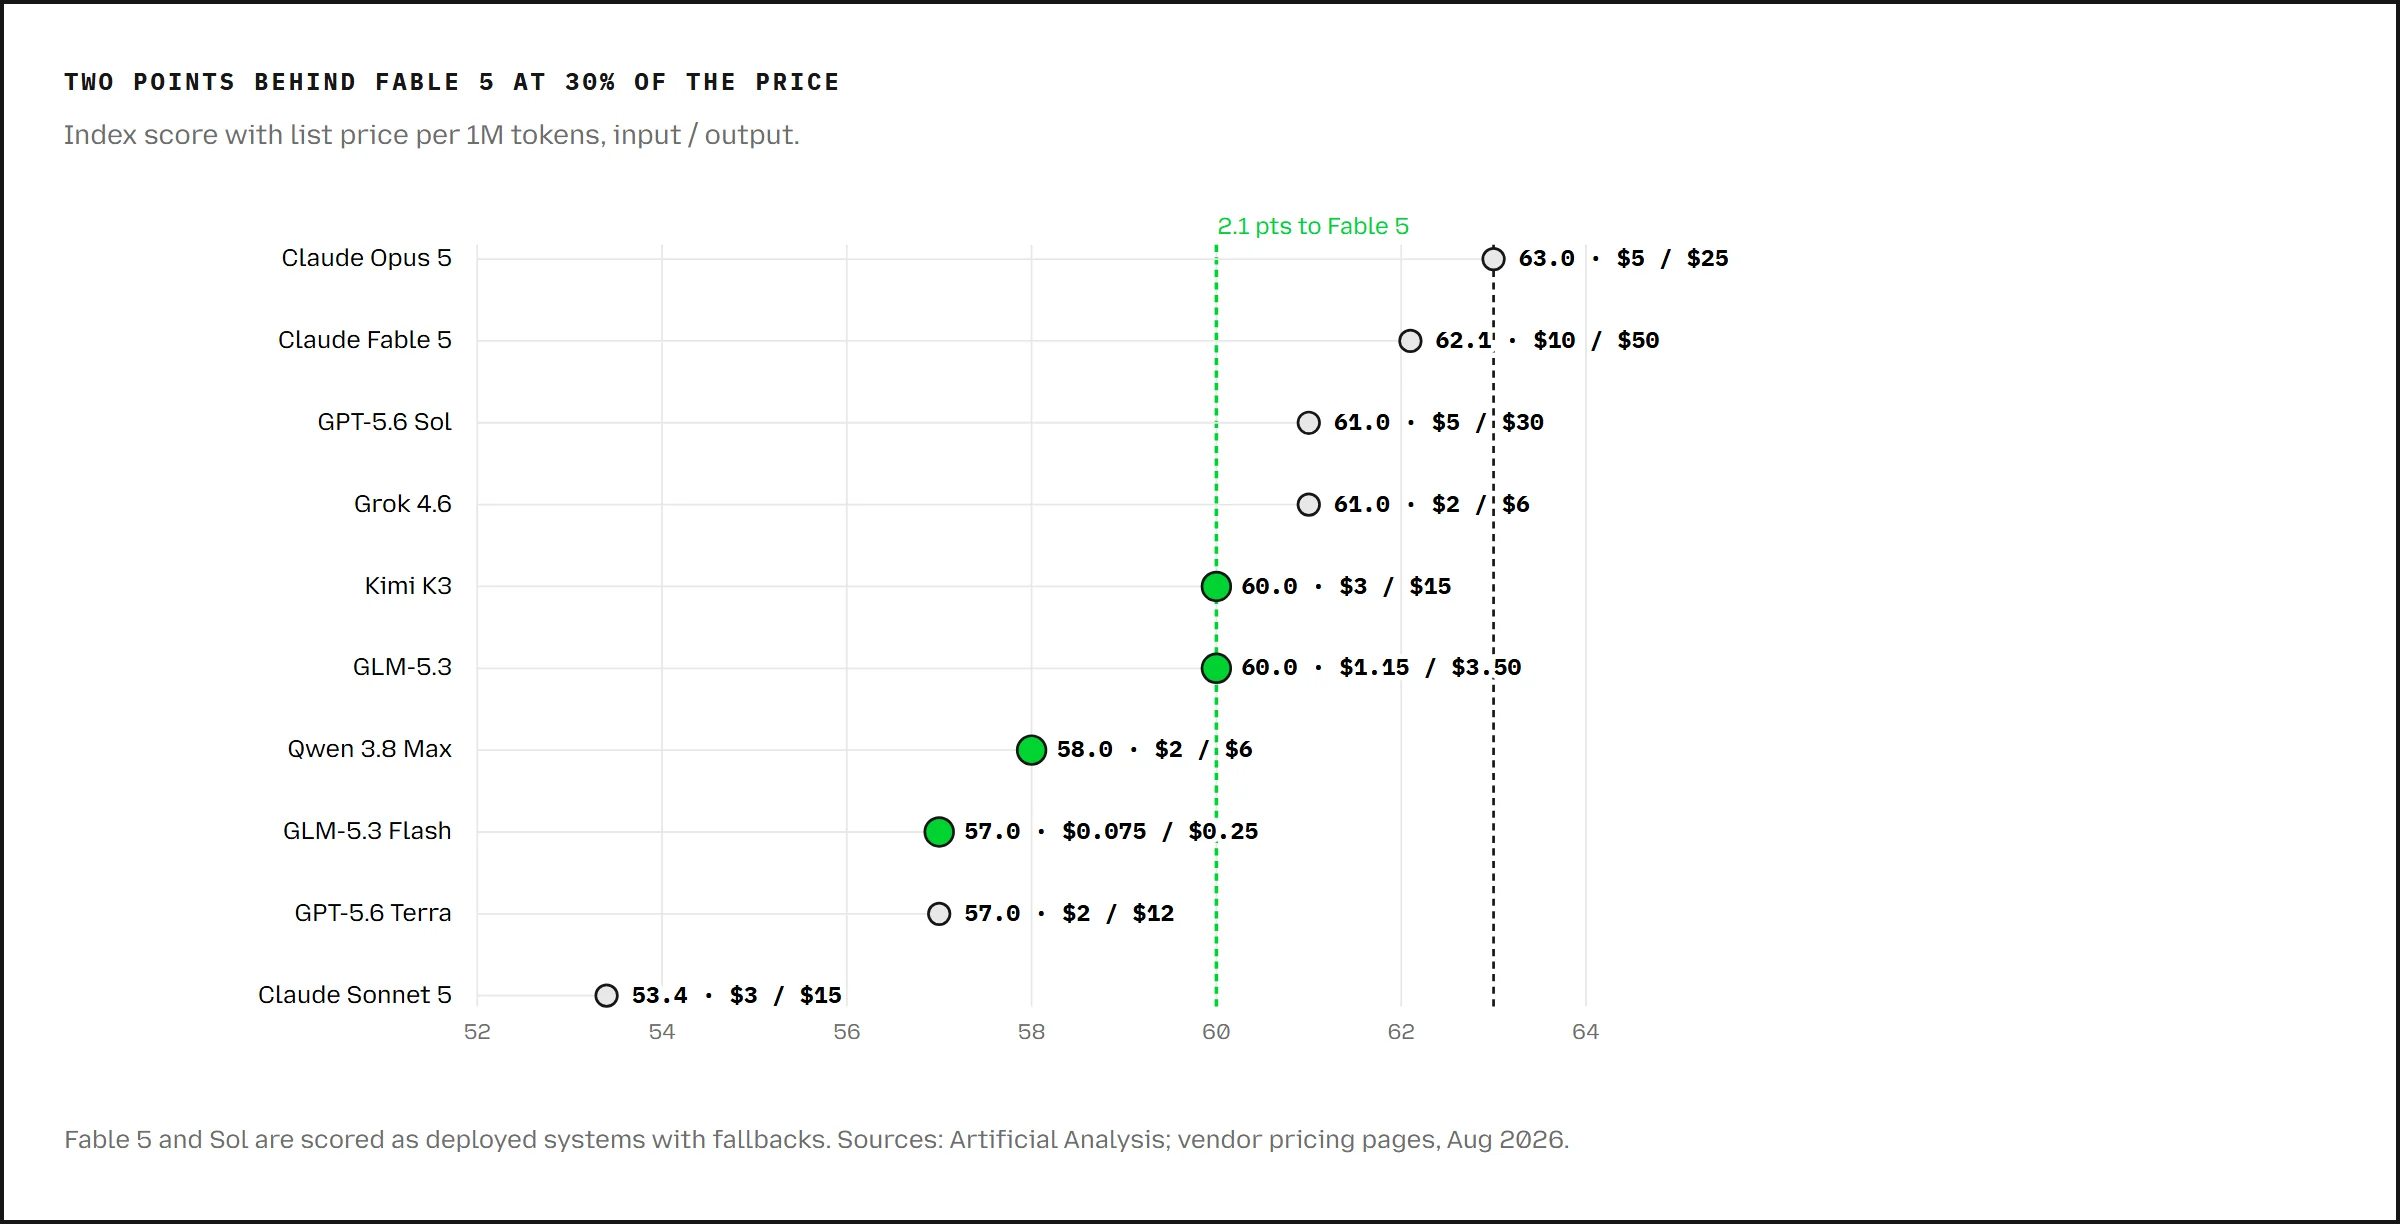
对做产品的人是好事:成本结构第一次可以自己挑。想动手的话,DeepSeek V4.1 Flash 这类低成本主力模型就是现成选项——原生多模态,主打压低 Agent 场景的调用成本。
这件事影响谁
对普通用户:手机上那些免费或很便宜的 AI 工具,背后调的模型可能已经悄悄换成开源的,体验差别多数场景里比宣传小。真正该留意的是数据落在哪——同一个模型,自己部署和别人代管,责任是两回事。
对做 AI 工具生意的人:这是一段实打实的成本窗口。但别把”省钱”当护城河——权重是公开的,你能降别人也能降,最后拉开差距的仍是场景和工作流细节。这条线怎么走,这份 AI工具站从 0 到日 IP 2000+ 的操作手册 比堆功能管用。
报告里被拿来跟 Claude Opus 对比的 GLM 系列出自 Z.ai(智谱的模型与开放平台),站内收录的是更靠后的 GLM-5.3。想看看开源模型现在什么水平,从这家开始最直接。

我可能错在哪
第一,4.4 个月是 Mozilla 自己的测算口径,不是行业标准。换一套评测集、换一个任务分布,数字就会变。
第二,收入对比(开放约 4% / 闭源约 96%)的数据窗是 2025 年 5-9 月,报告方自己说预计已变化。5 倍价也只是一项基准上的单任务成本,不能推广成”闭源普遍贵 5 倍”。
第三,也是我最有保留的一点:开源不等于免费。权重不要钱,但自托管的人力、稳定性,还有”谁兜底”,恰恰是很多企业继续买闭源的真实原因(报告也承认多数组织跑不好开源)。如果自托管总成本吃掉省下的 API 费用,这篇判断就只对一半。
接下来怎么办
- 按任务时长切模型清单:8 小时以下的常规活先换便宜的开源或国产模型,长任务留给旗舰;
- 算”每完成一个任务”的成本,别只看每百万 token 单价——两者经常得出不同结论;
- 换开源前先确认数据条款:自托管等于合规责任回到你自己身上。
第三条最大的心理门槛是”我电脑能不能跑”。这一步比想象中轻——可参考 Ollama(把开源大模型下载到本地、一条命令跑起来,不需要显卡集群)。先跑两天再决定要不要动预算。
老高的一句话
你为闭源旗舰多付的钱,买的不是更强的能力,是四个月的时间。问题在于——你手上真有非等这四个月不可的活吗?
关于开源模型与闭源模型的常见问题
开源模型和闭源模型现在还差多少?
按 Mozilla 2026 年 9 月的报告测算,中国头部开源模型与美国前沿闭源模型的能力差距约 4.4 个月;这是该报告的测算口径,不是行业统一标准。
换成开源模型是不是就不用花钱了?
不是。权重免费,但算力、部署和运维要自己出;很多企业继续买闭源,买的正是”出问题有人兜底”。
哪些任务适合先换成开源模型?
报告给的分界是 8 小时:以下的任务两类模型都能做,优先用便宜的;8 到 12 小时的长任务暂时留给闭源。
参考来源
- Mozilla《State of Open Source AI》v1.1(2026-09-15)
- Ars Technica 独家解读(2026-09-15)
- OpenRouter token 用量榜(2026 年 8 月)
老高,AI工具箱站长,更关心这些变化对普通人意味着什么。
想第一时间知道哪些AI工具值得花时间——
相关文章

 浙公网安备33010202004812号