
老高AI观察 · 第3期|2026 年 9 月 15 日
2026 年 9 月中旬,两件方向相反的事撞到一起:一边是全球最不缺算力的公司,把别家最强的模型从核心业务里挪出去;另一边是模型的卖方,主动把数据保管权交还给客户。我的判断是——这件事改变的不是安全标准,是采购标准。往后卡住签单的不是”谁更聪明”,是数据能不能一步都不出我的边界。
三家最怕泄密的公司,先把自己的用法收紧了
2026 年 9 月 14 日,The Information 报道英伟达、Palantir 和博思艾伦汉密尔顿已限制使用 Anthropic 旗舰模型 Fable(见 原文〔付费墙〕、转载)。三家收紧方式不同:
- 英伟达:Fable 只留给低敏感度任务,核心业务改用自研模型
- Palantir:拿到不可撤销的零数据保留承诺前,暂停在客户软件里提供 Fable
- 博思艾伦:禁止员工拿它处理客户专有的网络安全软件
同一报道还提到,一家美国大型公用事业公司因拿不到不可撤销的无留存协议,放弃了在电网运营上测试 Fable。收紧的不只这三家,是所有”数据出门就出事”的行业。英伟达的替代品是它开源的 Nemotron 3 Super。
为什么是现在
起点不是 9 月,是 6 月。2026 年 6 月,Anthropic 对 Fable 5 和 Mythos 5 引入 30 天滚动留存,官方理由是最复杂的滥用分散在多个会话和账号里,只看单次交互抓不到。政策覆盖 Fable 5、5.1 和 Mythos 5、5.1 四个”受管辖模型”。
一个容易忽略的细节:即便企业已签零数据保留(ZDR)协议,用这几个模型照样受约束;开了 ZDR 却没为它们单独启用留存,请求会直接报错。
然后 9 月 1 日,Anthropic 发布 Enterprise Frontier Safeguards(EFS),公告里有一句卖方自己写下来的话:很多企业理解留存的安全价值,”但不少企业——尤其是受监管行业——发现带留存条款的模型很难用”(见 官方公告)。这等于承认政策在挡单。
为什么是现在?一是风险被能力推高了——公告写了近期模型被滥用、甚至”自主从事破坏性行为”的证据。二是钱:Anthropic 6 月 1 日已秘密递交 S-1 草案,5 月 H 轮投后估值 9650 亿美元,据《金融时报》8 月报道,投资方预期上市估值约 2 万亿。
变的不是安全标准,是采购标准
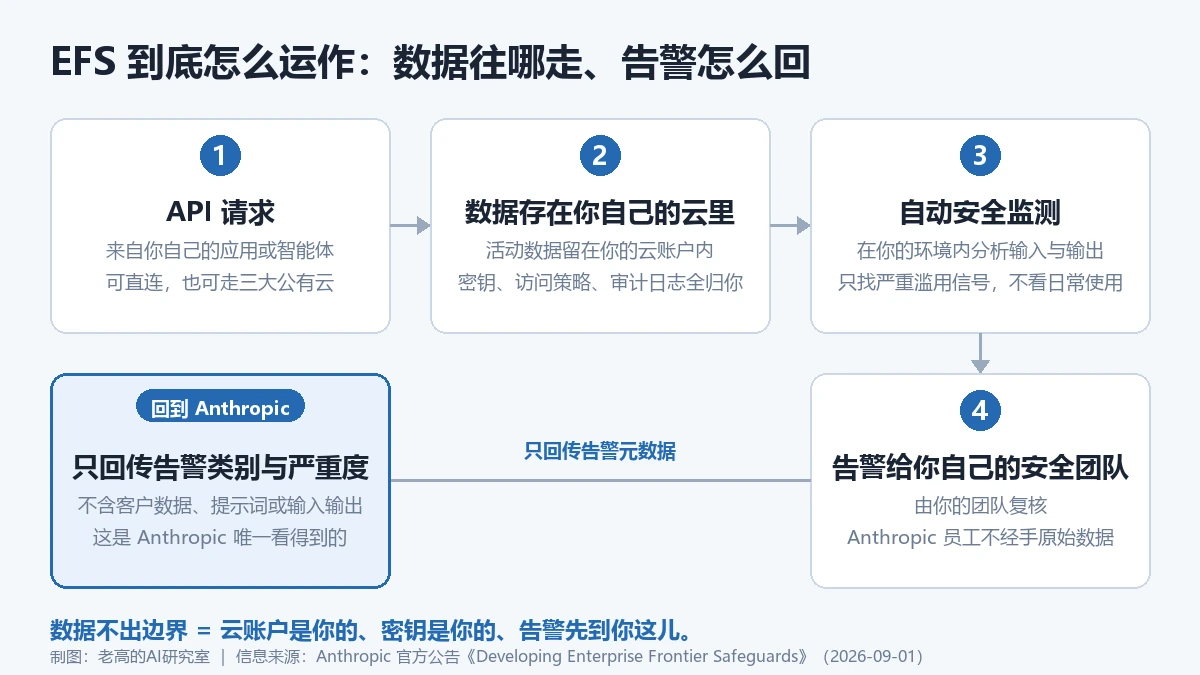
EFS 的做法是三项能力,企业按需开启:活动数据存在客户自己的云账户(S3、Azure Blob、GCS 都行);密钥由客户托管;审查全自动——可疑信号直接发给客户自己的团队复核,不需要 Anthropic 员工去看。设计是跟 100 多家客户一起谈出来的,包括美国几家最大银行 CISO 组成的 ARC。
这不像安全产品升级,更像一次角色调整。Anthropic 原来是”数据受托方”——客户把数据交给你,你负责守好;EFS 之后它主动降成”模型供应商”——数据不经过我,我只负责跑模型。对一家以安全立身的实验室,这是让出最有利的位置。
因为采购桌上最硬的那句话变了:前两年问”你比别人聪明多少”,现在先问”数据在哪、谁能看、多久删”。另一个信号来自模型本身:争议中心的 Claude Fable 5.1 默认 30 天留存,同批的 Claude Mythos 5.1 也一样,但体系内其它模型仍可维持 ZDR。
免费让出数据控制权,说明能力已经不是卖点
EFS 有几个细节值得拎出来:Anthropic 不对 EFS 额外收费;三项能力都不改变模型行为、API 定价和速率限制;数据存在客户自己云里,由云厂商按存储和流量正常计费。卖方付出了改架构、放弃数据可见性的成本,却一分钱没多收。
愿意做这种让渡,通常只有一个原因:这条政策在挡单,挡的还是它最需要的那批单。所以 EFS 是防守动作,不是产品创新。更值得琢磨的是它没解决问题——公告两周后最敏感的三家公司还是有限制:EFS 给的是”可以撤销的控制”,Palantir 要的是”不可撤销的保证”。
所以英伟达那条路才显得合理:与其在条款上反复拉扯,不如把关键业务搬回自己能控制的地方。内部换用自研模型是一层,企业级 Agent 安全与自演化平台 NemoClaw 是另一层。这个顺序一旦定下来,就不是采购调整,而是长期架构选择。
这件事影响谁
第一层是普通用户。条款变化会顺着 API 传下来。如果你在用第三方套壳工具、或自己调 API 做小产品,值得查一下用的模型属于哪一档数据规则。
第二层,也是我更想说的:做 AI 工具生意的人。第一,”数据不出边界”正从加分项变成准入证。第二,本地和私有路线被抬了一档:英伟达的本地推理路由 NVIDIA PAIR、Meta 开源可本地运行的 Muse Glimmer 都属于这个方向。想上手最简单的一步是用 Ollama(本地跑开源大模型的工具,一条命令拉模型、离线运行,数据不出本机)。

第三,如果你在链条中间做转售、代理或垂直 SaaS,上下游会同时收紧:上游给你加数据条款,下游甲方问你要数据承诺。往后得额外回答一句”我凭什么替你保管数据”。
我可能错在哪
第一,限制使用不等于停止采购。报道当天被点名的三家公司股价走势并不一致,市场看起来把它读成治理决策而不是营收损失——英伟达卖的是芯片不是模型访问权。
第二,替换成本比看上去高,所谓限制更可能挤出最敏感的那一小块预算,而不是挤出整张清单。第三,EFS 才公布两周、秋季才分批上线,现在说”不够”可能只是时间太早。
最脆弱的一环是:我把数据条款当成了主因。它也可能是被媒体抓住的一个横切面——企业本来就在重新算 AI 的投入产出,数据条款只是恰好成了那个说得出口的理由。
接下来怎么办
- 查默认条款:搞清楚你在用的模型属于哪一档,哪些必须留存、哪些还能维持 ZDR
- 把数据边界写成一句话:在产品页加一行”数据存在哪、谁能访问、多久删除”
- 重新算私有化的账:现在早不是自建集群那么重
第三条展开说一句。想知道零成本自建私有知识库长什么样,可以参考这份 Dify 挂载 DeepSeek-R1 的私有化部署实测;只是想先给数据脱敏,OpenAI Privacy Filter(能在内容送进外部模型之前先脱敏一遍的开源工具)更轻。
老高的一句话
模型能力会继续趋同,数据边界不会。往后决定一单能不能签的,不是谁的模型更聪明,而是谁能证明数据一步都没离开客户的墙。
关于企业AI数据托管的常见问题
零数据保留(ZDR)和企业自存储有什么区别?
ZDR 是厂商承诺不留存你的数据,控制权仍在厂商;企业自存储是把数据放进你自己的云账户,密钥和审计日志由你掌握。前者靠信任,后者靠架构。
哪些 Claude 模型默认要求 30 天数据留存?
Fable 5、Fable 5.1、Mythos 5、Mythos 5.1 默认保留 30 天;即便签过 ZDR 协议,用这几个模型同样受约束。
我自己调 API 会受影响吗?
会。同一家厂商的不同模型规则可能不同,使用前建议查清所属档位;涉及客户数据时先确认留存与删除条款。
参考来源
- The Information(2026-09-14):三家美企限制 Anthropic 模型使用
- 路透社(2026-09-14):转引上述报道
- Anthropic 公告(2026-09-01):Enterprise Frontier Safeguards
我是老高,靠AI工具吃饭的个体站长,只写自己看得懂的那部分。
关心AI工具怎么真正用到生意里,而不只是看热闹——
相关文章

 浙公网安备33010202004812号