
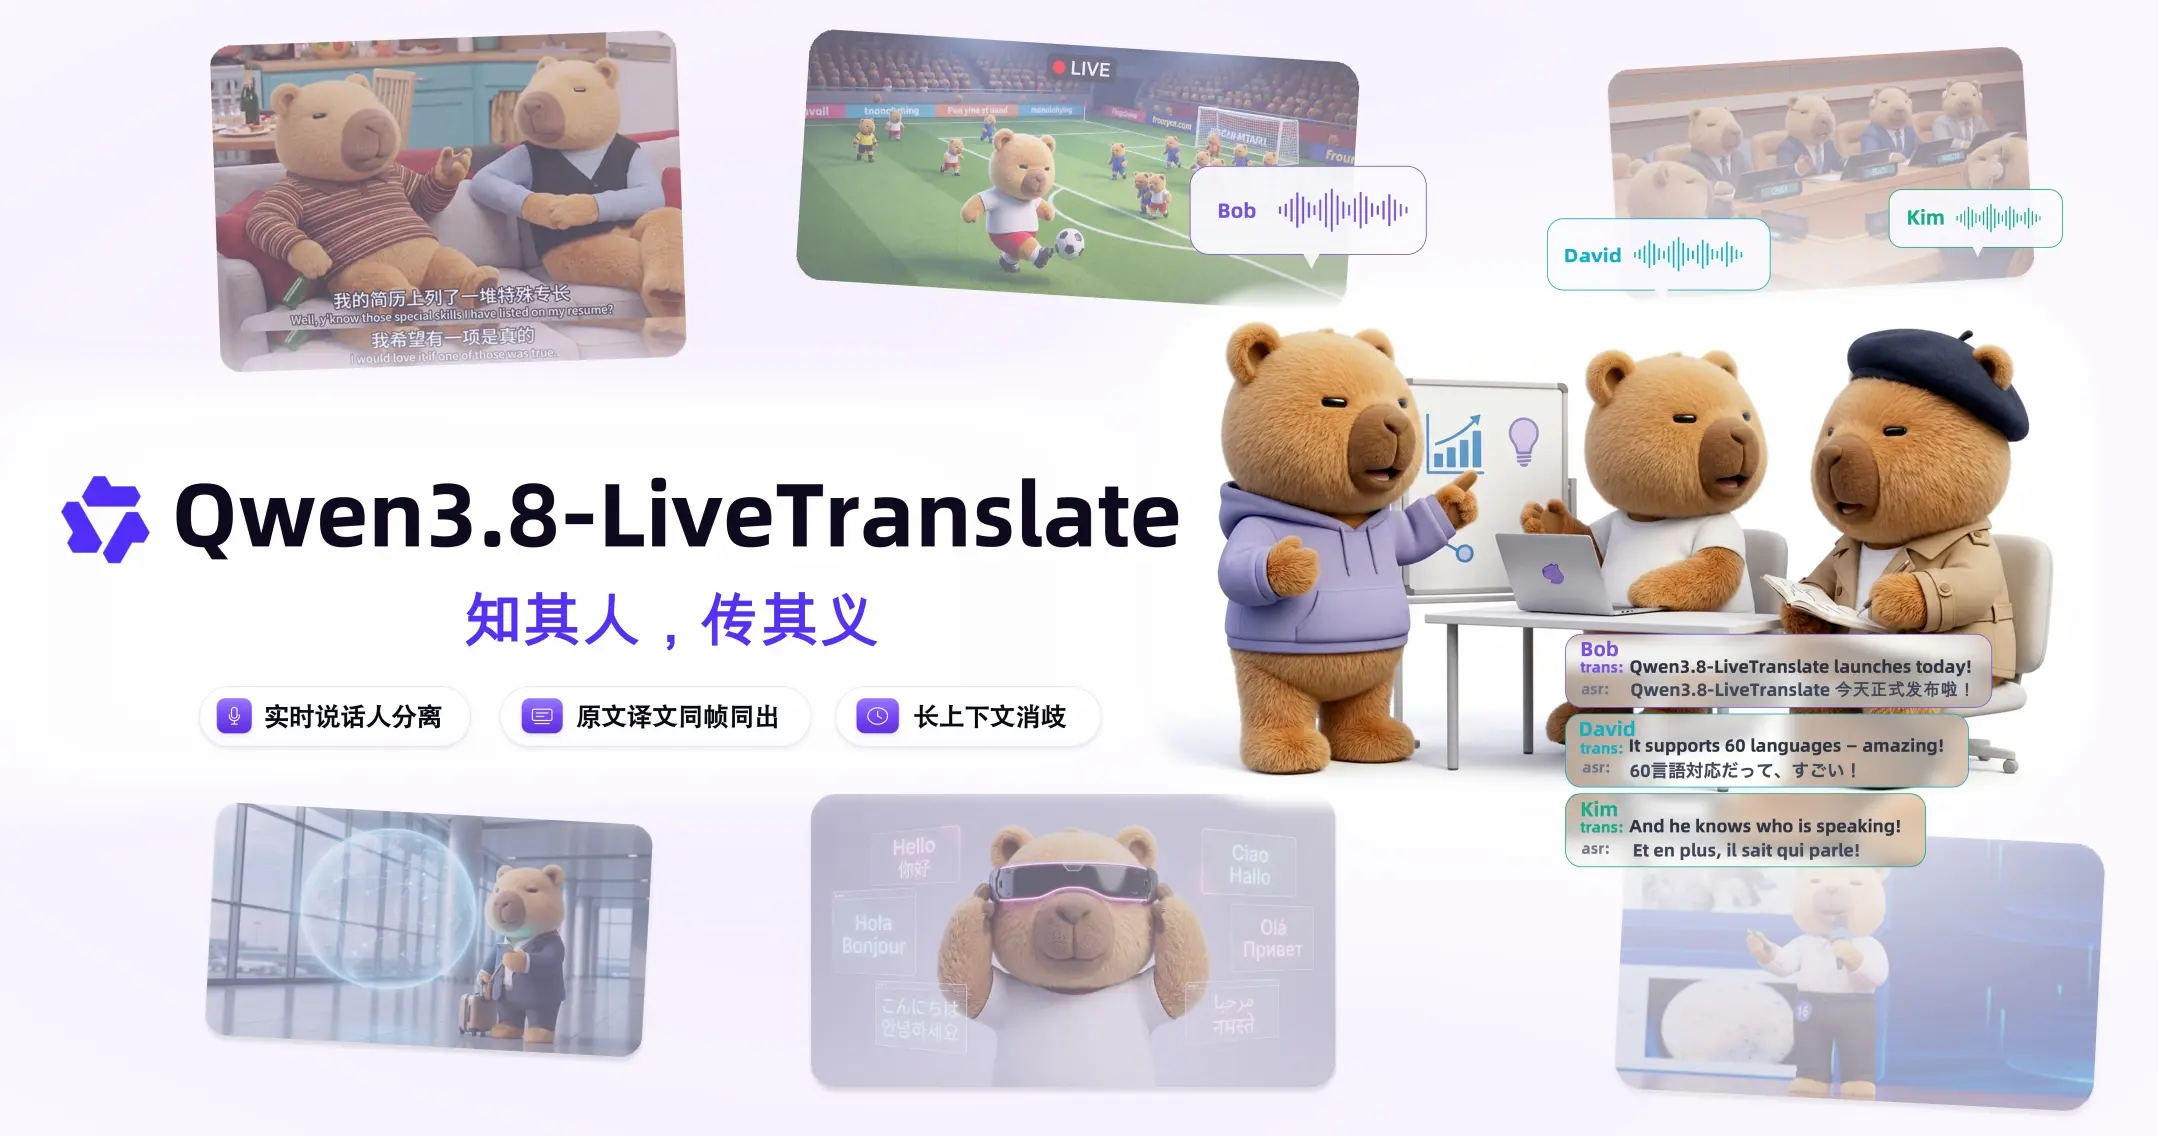
Qwen3.8-LiveTranslate是一款由阿里通义千问于2026年9月推出的端到端实时同声传译大模型,主要用于边听边译的跨语言实时交流,字均延迟(LAAL)降至 2.3 秒、支持 60 种语言音频输入与 29 种语言语音输出,适用于跨国会议、跨境直播与视频本地化等场景。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 端到端实时同声传译大模型 |
| 出品方 | 阿里通义千问(Qwen) |
| 发布时间 | 2026年9月18日 |
| 核心架构 | Hybrid MoE 的 Thinker–Talker 双模块 |
| 字均延迟 | 2.3 秒(LAAL) |
| 语言覆盖 | 60 种语言输入 / 29 种语音输出 |
| 新增能力 | 说话人分离、双语同帧、长上下文消歧 |
| 输入模态 | 音频、视频 / 图像(辅助消歧) |
| 模型编码 | qwen3.8-livetranslate-flash-realtime |
| 接入方式 | DashScope WebSocket 实时 API |
| 开源情况 | 未开放权重,仅云端 API |
Qwen3.8-LiveTranslate 的核心能力
本代改动集中在一条主线上:把「还在听」和「已经在译」压进同一条流。这类端到端模型也是 AI 大模型 从通用能力走向垂直场景的典型落点。
Interleave 单流架构与 2.3 秒字均延迟
模型把同传重构为音频与文本交织的单流:已听到的音频与已生成的译文可缓存复用,不必每句从头重算。底层是基于 Hybrid MoE 的 Thinker–Talker 双模块——Thinker 把视频、音频、原文与译文编排进同一条因果序列并端到端产出;Talker 结合译文与源音频,合成保留原说话人音色的语音。官方给出的字均延迟(LAAL)为 2.3 秒。
实时说话人分离与音色复刻
多人交替发言时,模型先做说话人分离,把每句话归属到具体参与者,并据此为同一位说话人复刻音色。在覆盖 14 个语向的 Omnilingua-MSpeaker 评测中,其流式说话人分离错误率(DER)为 9.7%;译文语音不再是单一音色朗读,「谁在说」这条信息被保留了下来。
双语同帧输出与长上下文消歧
原文与译文在同一条交织序列中对齐生成,天然支持同帧输出:双语字幕、会议速记与内容检索都不必再做时间轴对齐。模型同时把历史对话纳入上下文,跨轮关联前文来确定当前译法,缓解专有名词与人名指代在长会话中前后不一致的问题。
60 种语言覆盖与视觉辅助输入
模型支持 60 种语言的音频输入与文本输出,其中 29 种可输出译文语音,其余语种返回文本。输入侧除音频外还可选传视频或图像帧,画面中的文字与手势可作为消歧线索,在嘈杂环境或同音词场景下补足声学信息。
Qwen3.8-LiveTranslate 与同类同声传译模型的对比
同传模型的取舍集中在延迟、翻译质量与多人长会话的一致性。以下对比数值取自千问官方发布材料的 FLEURS 评测图表(19 种语言、70 个语向),逐格列出。
| 对比维度 | Qwen3.8-LiveTranslate | Qwen3.5-LiveTranslate | GPT-Realtime-Translate | Gemini 3.5 Live Translate |
|---|---|---|---|---|
| 开发方 | 阿里通义千问 | 阿里通义千问 | OpenAI | 谷歌 |
| 产品定位 | 端到端同声传译模型 | 上代实时语音翻译模型 | 实时语音翻译与对话 | 实时语音翻译与沟通 |
| 字均延迟(秒) | 2.3 | 2.5 | 2.8 | 3.1 |
| 翻译质量 | xCOMET-XXL 85.7 | xCOMET-XXL 83.0 | xCOMET-XXL 73.5 | xCOMET-XXL 65.2 |
| 语音识别 | ASR WER 6.6% | ASR WER 7.0% | 未在对比项内 | 未在对比项内 |
| 语音自然度 | UTMOS 4.0 | UTMOS 3.9 | UTMOS 3.4 | UTMOS 3.0 |
把四项指标放在一起看,Qwen3.8-LiveTranslate 在延迟、翻译质量、识别准确率与语音自然度上同时超过上一代:2.3 秒对 2.5 秒、xCOMET-XXL 85.7 对 83.0、ASR WER 6.6% 对 7.0%、UTMOS 4.0 对 3.9。拉开最大距离的是识别准确率——6.6% 的字错率比 73.5 分的 GPT-Realtime-Translate、65.2 分的 Gemini 3.5 Live Translate 低了十几个点,说明延迟下降未牺牲识别质量。多人长音频线上,9.7% 的流式 DER 也低于 GPT-4o-transcribe-diarize 的 18.0% 与Gemini-3.5-transcribe-preview 的 26.7%;后两者为离线系统,与流式口径不完全可比。
如果想了解同门在实时语音方向的其他路线,可参考 Qwen-Audio-3.0-Realtime(阿里通义推出的实时语音交互模型,主打端到端语音对话与低延迟响应)。两者都处理流式音频,区别在输出目标:本模型产出另一种语言的译文,它面向的则是同一语言内的对话。
Qwen3.8-LiveTranslate 的应用场景与适用人群
该模型面向有真实跨语言沟通压力的场景,价值集中在多人、长时间、需要即时反馈的会话里:
- 跨国会议与商务谈判:多人交替发言时说话人分离能把每句话归属到参与者,译文语音保留各自音色,听感更接近真人同传。
- 跨境直播与在线教育:原文与译文同帧输出,双语字幕可直接投屏,下游无需再做时间轴对齐。
- 视频本地化与涉外服务:支持视频与图像输入,画面文字与手势可作消歧线索;长上下文消歧保证人名与术语前后一致。
适用人群:需要把跨语言沟通接进产品的工程与产品团队;跨国会议、跨境直播与涉外服务的运营方;以及正在做技术选型、需要实测同传延迟与质量基线的算法工程师。
Qwen3.8-LiveTranslate 的使用方法
模型提供在线体验与 API 两条路径,生产接入以流式会话为主:
- 在线体验:从 Qwen3.8-LiveTranslate 官方发布页 进入演示页,授权麦克风并选定源语言与目标语言,即可看到双语字幕与译文语音。
- 开通接口:在阿里云百炼(DashScope)控制台创建 API Key 与业务空间,确认可访问
qwen3.8-livetranslate-flash-realtime模型。 - 建立 WebSocket 会话:连接
wss://{workspace_id}.cn-beijing.maas.aliyuncs.com/api-ws/v1/realtime,用session.update把input_audio_format设为pcm,并选择output_modalities的text或text+audio。 - 开启增强能力:在会话配置里打开源语言识别与说话人标识,服务端会在返回译文的同时给出说话人标记与原文,不必再单独调用 ASR。
会话结束前必须发送 session.finish,否则最后一段译文会丢失;音频输入默认 16 kHz、输出 24 kHz。
Qwen3.8-LiveTranslate 的价格与开源情况
Qwen3.8-LiveTranslate 通过阿里云百炼(DashScope)按实时会话计费,官方发布材料未给出统一价目,单价随地域与音频输入输出时长浮动,落地前建议以百炼控制台的实时计费页为准。译文语音输出比纯文本输出消耗更多额度,长会议与直播建议先小流量试跑,量出输入与输出的时长比例再决定是否开启语音输出。
权重方面,本代模型未开放下载,只提供云端 API 调用,模型编码为 qwen3.8-livetranslate-flash-realtime。实时同传强依赖服务端的流式调度与音频编解码链路,目前仍以闭源商用服务交付,需要私有化部署的团队需自行串联语音识别、翻译与语音合成三段链路。
Qwen3.8-LiveTranslate 的常见问题
Qwen3.8-LiveTranslate 的字均延迟是多少?
官方对比图表给出的平均 LAAL 为 2.3 秒,为同批对比模型中的最低值,且是在翻译质量同步提升的前提下取得的:其 xCOMET-XXL 为 85.7,高于 GPT-Realtime-Translate 的 73.5 与 Gemini 3.5 Live Translate 的 65.2。
Qwen3.8-LiveTranslate 怎么处理多人发言?
模型在翻译前先完成实时说话人分离,把每句话归属到具体说话人,再据此为每位说话人复刻音色生成译文语音。在覆盖 14 个语向的 Omnilingua-MSpeaker 评测中,其流式 DER 为 9.7%。
Qwen3.8-LiveTranslate 能本地部署吗?
不能。本代未开放模型权重,只能通过阿里云百炼(DashScope)的实时 API 调用。
相关文章

 浙公网安备33010202004812号