

老高AI观察 · 第33期|2026 年 10 月 20 日
1995 年,法国数学家 Étienne Ghys 提出:混沌的动力系统,能不能决定几何上的分类。三十年过去没人证出来。今年 7 月末,大湾区大学教授许地生把三维情形喂给了书生-S2,第一轮推理吐出 400 页推导。10 月 15 日,上海人工智能实验室官网挂出通报:三维 Ghys 猜想证明完成,四个主要定理全部通过机器检验。
多数人关心「AI 会不会做数学」。我看的是另一处:这算不算一个证明,已经先交给机器去说了。
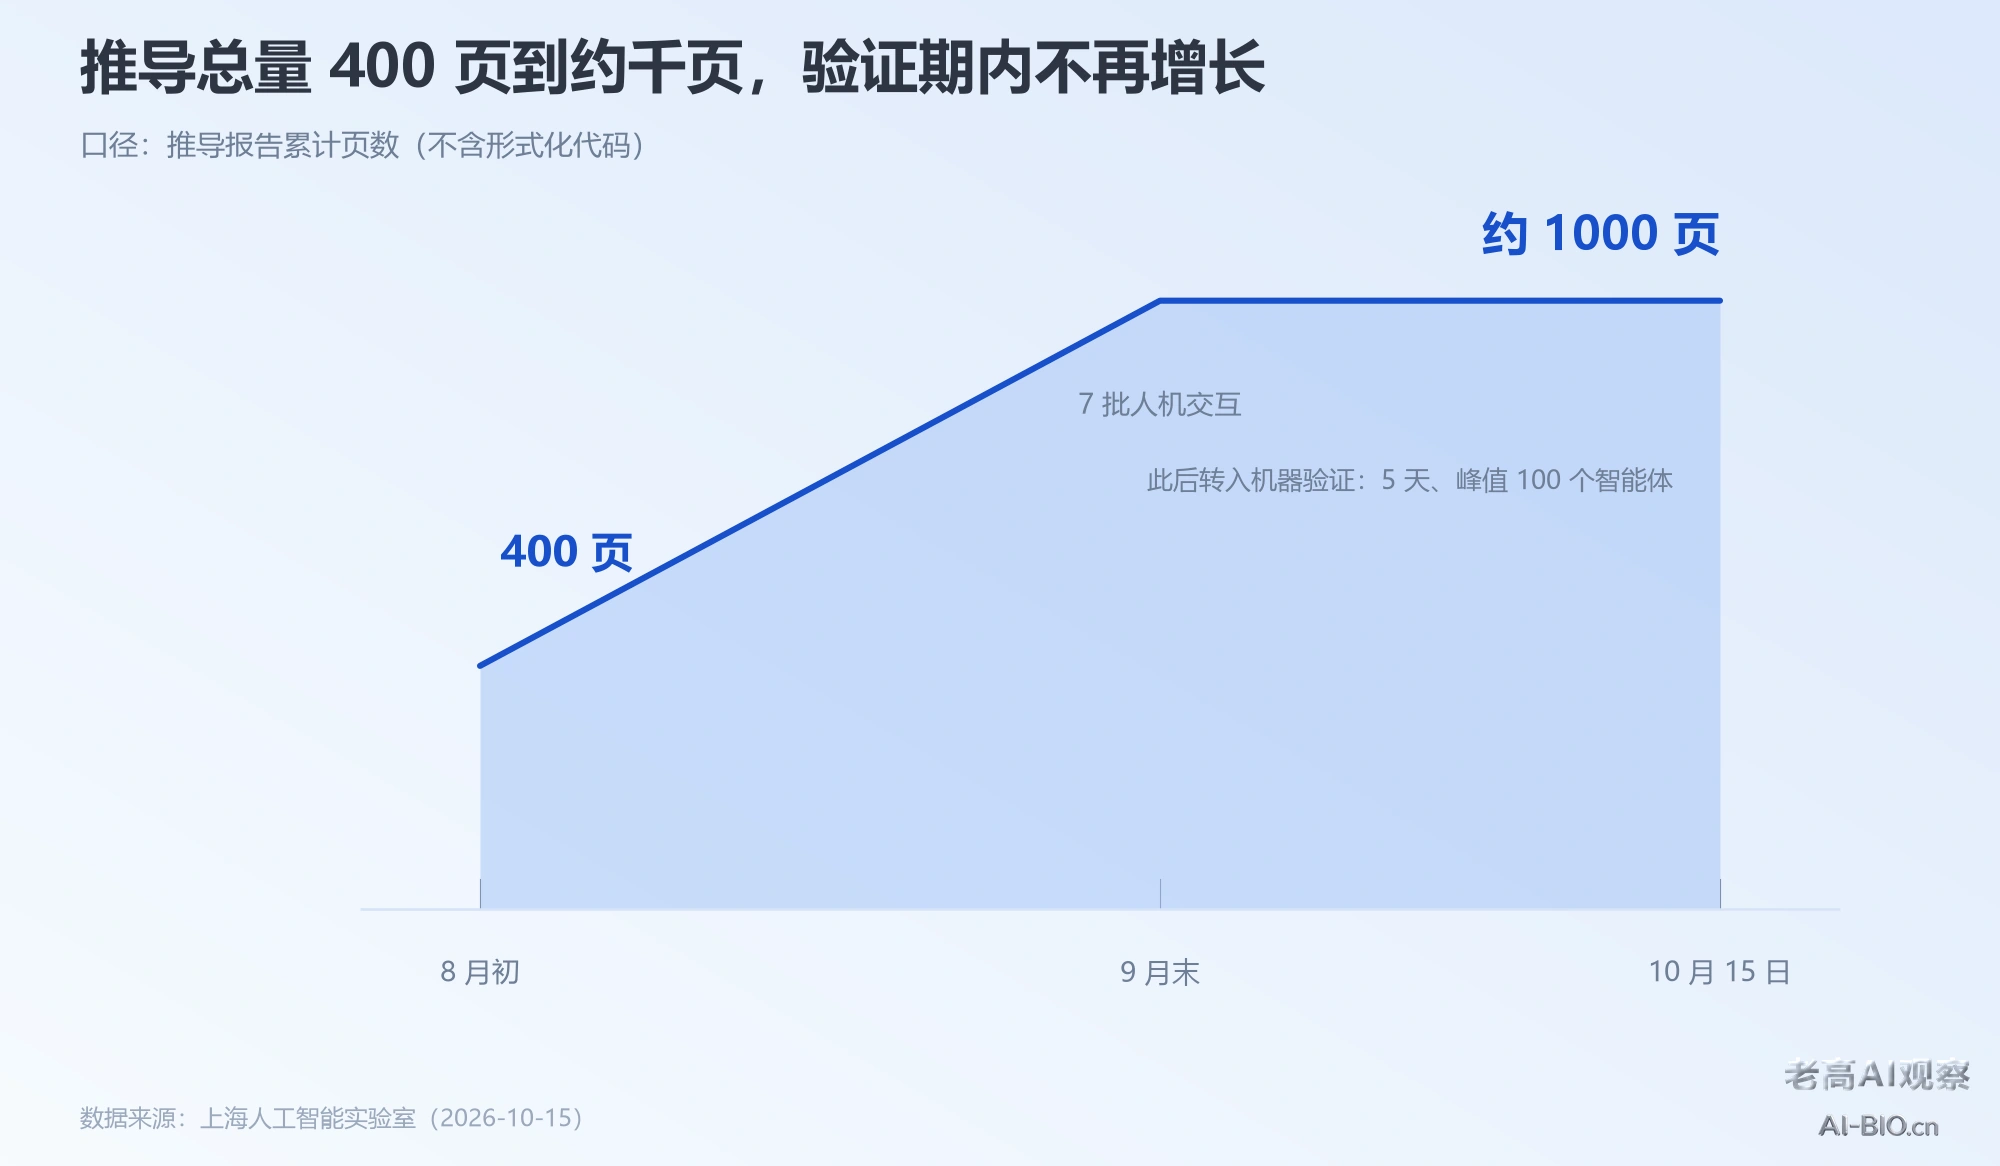
首轮 400 页,7 批推到千页
这条线不是突然起来的。2025 年全国中学生数学奥林匹克竞赛第一次设 AI 测试,上海 AI 实验室上一代模型书生-S1 拿到 102 分,超过人类选手金牌线。许地生注意到这件事,实验室那边也想把模型从竞赛级推到研究级,2026 年初两边正式合作。
今年 7 月末,许地生发现模型能力出现质变,把猜想直接喂了进去。首轮推理,400 页推导报告。此后团队持续给反馈、校准方向,书生-S2 又完成 7 批接续推演,问题图从 15 个节点扩到 389 个,输出到千页,还生成数十种新的论证思路。许地生的学生张洁松现就职于瑞典皇家理工学院,这次也加入了攻关组。
证明出来还得有人验。北京大学董彬、刘若川团队用自研 SHEAF 框架和 Lean 4 做形式化验证:约 5 天,峰值 100 个智能体并行,约 55 万行 Lean 代码,论文四个主要定理全部通过。10 月 15 日,上海人工智能实验室的成果通报挂上官网,论文已在预印本平台发布,形式化代码在 GitHub 开源。本站有这套模型的收录页,可看 书生-S2 的介绍。
早半年晚半年,都不是这个结果
为什么是现在?三个条件刚好凑齐。
一是模型侧。竞赛分数证明它能算,研究级数学要的是长链条不出错。实验室走「通专融合」路子,加强专业数学训练,还搭了一套面向数学研究的 Harness 系统,许地生从实际需求出发挑毛病,系统一轮轮迭代。竞赛是短跑,研究是接力。
二是人这一侧。许地生跟导师、菲尔兹奖得主 Artur Avila 研究过三维情形,没走通。他心里有题,缺一个能陪他熬几个月的工具。
三是行业气压。9 月以来国际几家动作很密:OpenAI 说用 88 小时、10000 个智能体攻下纳维-斯托克斯方程,本月初又公开 722 篇数学手稿。9 月 11 日,25 位菲尔兹奖得主联名表态,认为把解难题当能力基准可能损害数学共同体。第一财经的报道里也提到,近期公开的成果质量参差不齐。热闹和质疑同时到,这时交出带机器验证的答卷,时机不是挑出来的。
不是AI会证了,是判定权换了手
先说清这次验证验了什么。Lean 4 是定理证明器,把证明拆成一条条可机械检查的推理步骤;SHEAF 负责把论文翻译成 Lean 能懂的陈述。55 万行代码跑完、4 个主定理通过,意思是:从形式化陈述出发,推导链条没有漏洞。
但它不回答另一个问题——形式化出来的那句话,是不是原来那个猜想。这一步叫陈述的形式化,仍由人担保,而且最容易出错。所以准确的说法是:AI 写推导,人做翻译,机器确认推导没错。三件事,缺一件都不算完。
我的判断在这儿:生产证明的成本被打到 5 天机器时间,承认证明的定价权,挪到了形式化系统手上。以前看同行认不认,现在多一道更硬的关口,机器说不过,人很难再说它过。这道关口比模型本身更值得盯,国内做 Lean 4 形式化证明的团队也不止一家。
长在问题图上,不长在篇幅上
两个数字放一起看很有意思:问题图从 15 个节点扩到 389 个,是首轮的 25.9 倍;推导篇幅从 400 页到千页,只涨 2.5 倍。如果 AI 只是灌水,该涨的是页数;实际涨得更凶的是问题结构。
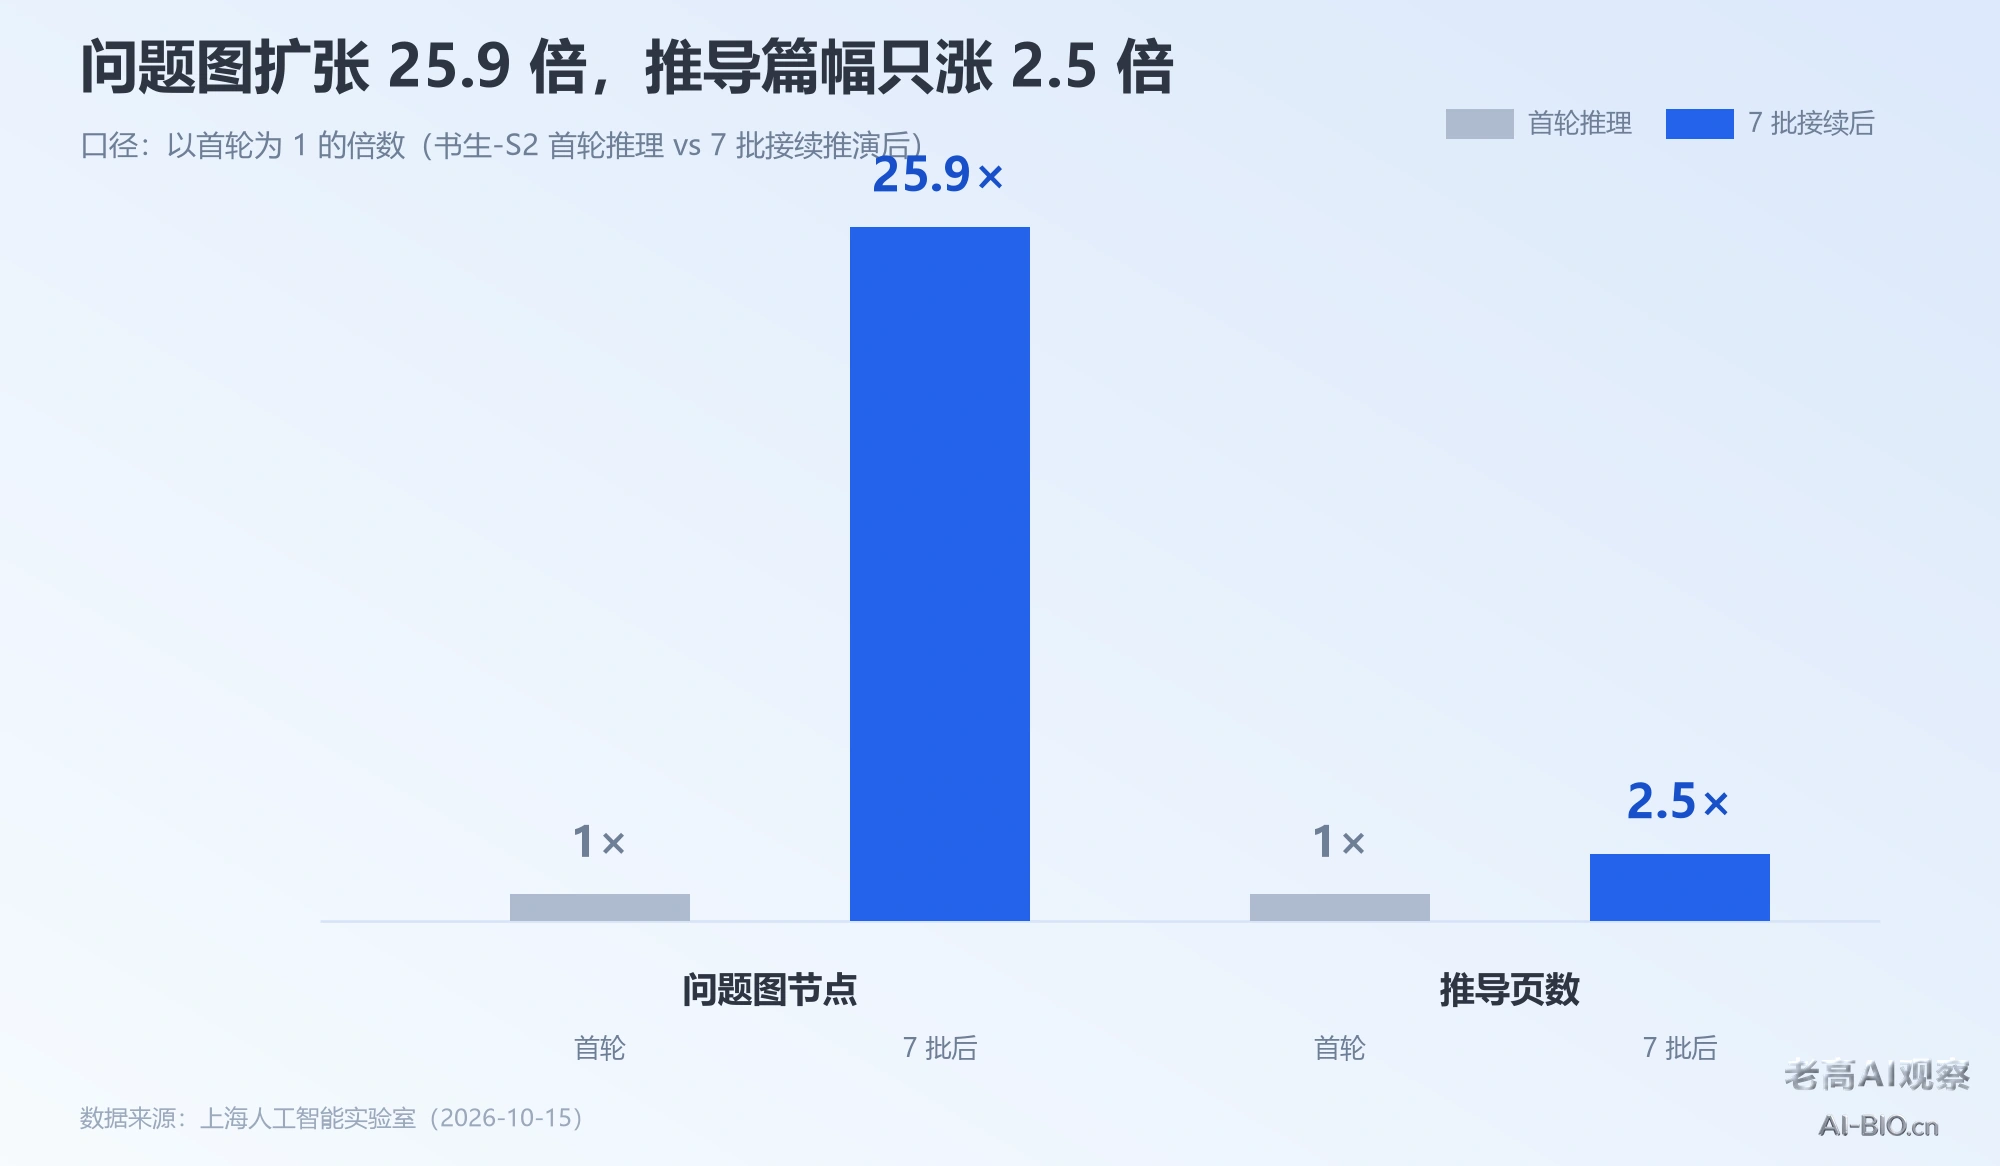
它做的事更像不停把大问题拆成小分支,试探哪条能走通,再让许地生判断哪条值得深挖。7 批接续里,人的作用不是给答案,是给方向。AI 擅长铺开搜索空间,人擅长铺开之后挑一条。
官网把这套过程总结成可复制的闭环:系统探索、专家判断、成果积累、反馈修正,以后要封进「书生·端砚」科学发现平台。对做工具的人有参考价值——它卖的不是「会解题的模型」,是「把专家稀缺领域的探索规模放大的一整套流程」。类似思路国内已有团队在做 科学发现智能体,差别在有没有把验证环节一起做进去。
谁的旧经验不管用了
普通用户这边,最先感受到的是话术通胀。接下来你会看到大量「AI 攻克世界难题」的宣传。一个简单分辨法:有没有第三方验证、验的是形式化陈述还是原始猜想、同行评议走完没有。隔着的不是分数,是能不能被检验。
做 AI 工具生意的人值得多看两眼。过去两年大家卖「生成」——写文案、写代码、出图。这次信号是「生成」之后那一段开始有钱赚:谁来验、怎么验、验完怎么存证。此前写过的 AI 开始自己改进自己就是同一方向的另一面。若想找现成落地页参考,可参考 书生大模型(上海人工智能实验室的多模态科学基础模型系列)。

哪些是我推出来的,不是查到的
第一,四个主定理通过机器检验,不等于整个猜想被数学界承认。论文还在预印本平台,同行评议没走完。机器验的是推导,不是声誉。
第二,400 页、千页、389 个节点都是单方披露,目前没有第三方独立复算。这些数大概率是真的,但还没人独立验过。
第三,澎湃自己的稿子里就写着,近期国际顶尖模型公开的数学成果质量参差不齐,不少结论有待严格核验。这个提醒对整个方向都成立,不只针对某一家。
第四,许地生自己说得很克制:破解这个猜想并不意味着它能在接下来一两个月内就有潜在应用价值。
至于「判定权换手」——那是我的判断,不是官方说法。
不用换工具也能试的几步
看到「AI 攻破世界难题」这类消息,先问三个问题:谁验证的、验的是形式化陈述还是原始命题、有没有走过同行评议。答得上来再当新闻转,答不上来当宣传看。
如果你在做内容或者做站,把「可验证」当选题方向。写工具评测时把「官方说」和「我实测」分开标;写模型对比时标明数字是谁给的。信息越嘈杂,标出处越值钱。
把任务切成探索、判断、验证三段,想清楚哪段交给模型、哪段必须留人——这次给出的不是「模型很强」,是「流程可以拆」。
这些判断都记在 老高AI观察 里,一期只讲一件事。
说到底就一句
AI 把证明变便宜了,但算不算证明,以后要听机器的。
关于书生-S2的补充问答
书生-S2 和书生-S1 差在哪?
S1 是上一代,2025 年 CMO 首次 AI 测试拿 102 分;S2 增加了大规模递归推理和更灵活的人机交互,面向研究级数学。
三维 Ghys 猜想现在算解决了吗?
论文已公开、形式化代码已开源,四个主定理通过机器检验;但同行评议还没走完。
这件事对普通人有什么影响?
短期几乎没有直接影响。中期看,能分辨宣传和实证的人会更占便宜。
资料与出处
- 上海人工智能实验室《中国科学家首次用中国大模型攻克世界级数学难题》(2026 年 10 月 15 日)
- 第一财经同题快讯(2026 年 10 月 15 日)
- 澎湃新闻《攻克困扰数学界 30 余年难题》(2026 年 10 月 15 日)
- Yicai Global 英文报道(2026 年 10 月)
- 代码仓库 frenzymath/HolomorphicAnosov(GitHub 公开)
我是老高,AI工具箱站长,只写自己看得懂的那部分。想持续跟进AI工具更新和实操玩法——👉 老高AI交流群入口
相关文章


 浙公网安备33010202004812号