

EchoWM 是一款由京东未来研究院联合港科大等机构于 2026 年 8 月开源的可进入式全模态世界模型,主要用于从首帧图像与场景描述出发生成可连续操控的视听内容,支持键位动作序列控制与画面、环境声、语音同轨生成,适用于交互场景预演、短片镜头续接与具身环境构建等场景。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 可进入式全模态世界模型 |
| 开发团队 | 京东未来研究院联合港科大等 |
| 发布时间 | 2026 年 8 月 26 日 |
| 开源协议 | LTX-2 社区许可,含营收门槛 |
| 生成范围 | 画面、环境声、音乐、语音同轨 |
| 控制接口 | Action DSL 键位与相机控制 |
| 单次时长 | Base 版约 10 秒 |
| 输入条件 | 首帧图像加六字段提示词 |
| 运行环境 | NVIDIA GPU,支持多卡并行 |
| 文本编码器 | gemma-3-12b-it,需授权访问 |
| 在线体验 | 仓库自带 Gradio 演示界面 |
| 社区热度 | GitHub 约 2000 stars |
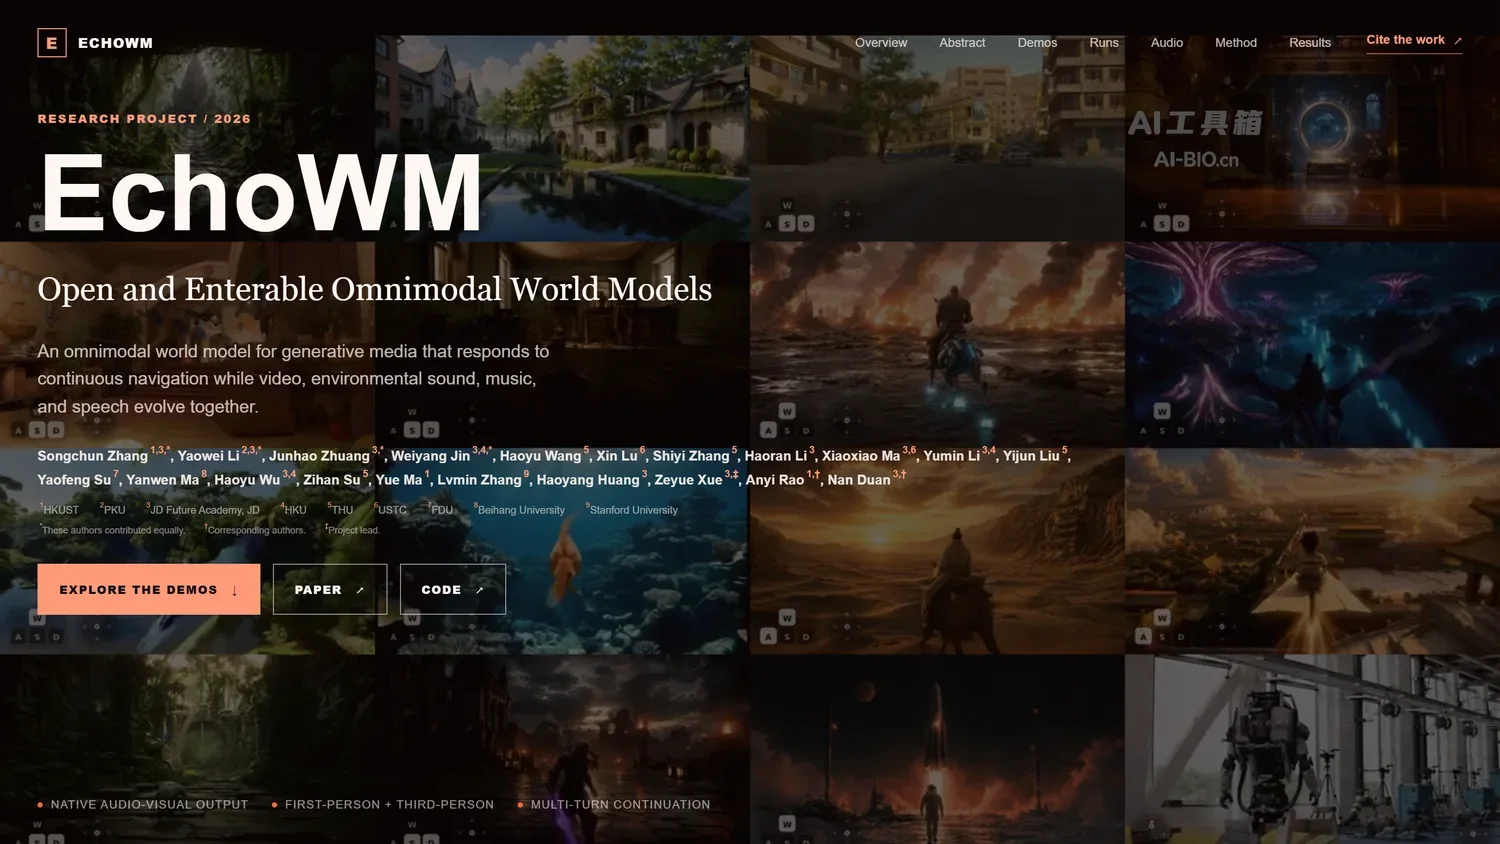
EchoWM 的核心能力
它的输入不是单句描述,而是一组起始状态:一张首帧图像、一段拆成六个字段的场景描述,以及一串描述操作的动作序列。
视听同轨:声音作为世界状态的一部分生成
官方把音频放进生成状态本身,而不是事后配一条音轨。环境声、音乐与对话语音在画面推进时同步演化:镜头靠近某处,声场随之变化;画面里有人开口,语音与口型落在同一次采样里。项目页提供第一人称与第三人称两组演示。
动作序列:把操作写成可复现的字符串
控制走 Action DSL,每段写成 键位-帧数,多段用逗号连接:w 与 s 前后移动、a 与 d 左右平移、i 与 k 俯仰、j 与 l 偏航,none 表示镜头不动。键位可组合,例如 w-60,wj-60,w-60,d-60。同一串字符重跑能得到同一段走向,这让交互过程可复现、可对比。
六字段提示词:场景描述被拆成可核对的结构
提示词固定分成 Environment、Character、Style、Perspective、Sounds、Speech 六段。拆开写的好处是每个字段可以单独改:换掉 Sounds 就换了一整套声场,改 Perspective 就换了机位高度,其余字段保持不动。PixVerse R2 同样主打实时全模态,但输入组织方式不同,字段化描述在本机批量改写时更省事。
两种视角与多轮续接
同一个控制接口既能驱动第一人称运动,也能跟随第三人称的主体。官方演示里的长序列由多轮续接得到:上一段末帧作为下一段首帧,世界状态因此延续,而不是每段重新起头。这决定了它能做一直走下去的镜头,而不只是固定长度的片段。
预览版走自回归:四步蒸馏换取更短迭代
除 Base 版外,仓库还提供 Echo-WM Flash Preview:用 DMD 蒸馏把采样压到四步,以自回归方式出画面,适合先看走向再决定是否用 Base 版重跑。官方说明长时版本仍在准备中,预览版与 Base 版共用同一份首帧与提示词格式。
EchoWM 与同类实时世界模型的对比
三款产品都把可交互放在核心位置,差别落在声音是否进入生成范围、单次生成长度,以及权重开放附带什么条件。
| 对比维度 | EchoWM | Matrix-Game 4.0 | LingBot-World 2.0 |
|---|---|---|---|
| 出品方 | 京东未来研究院联合港科大等 9 家机构 | 昆仑万维 Skywork | 蚂蚁灵波科技 |
| 技术路线 | 基于 LTX-2.3 的视听联合生成 | 自研实时视频生成,单卡运行 | 因果预训练、MoBA 与两阶段蒸馏 |
| 控制信号 | Action DSL 键位与帧数、纯相机控制 | 键盘操控与自然语言改写 | 角色动作、环境事件、相机位姿与文本 |
| 输出构成 | 画面与环境声、音乐、语音同轨生成 | 视频画面 | 视频画面 |
| 单次时长 | 约 10 秒(Base 版) | 15 秒评测片段,可连续游玩 | 5 至 60 秒评测,小时级连续生成 |
| 开放方式 | 代码与权重开放,LTX-2 社区许可 | 代码 MIT、权重 Apache-2.0 | 代码、权重与技术报告开放 |
| 硬件口径 | NVIDIA GPU,支持多卡并行 | 单张 RTX 5090,显存峰值 18.5 GiB | 1.3B Small 版单卡消费级 GPU |
上表 EchoWM 一列取自其官方项目页与仓库说明,Matrix-Game 4.0 一列取自昆仑万维官方发布材料,LingBot-World 2.0 一列取自其官方开源说明。输出构成是唯一的结构性差异:只有 EchoWM 把环境声与语音放进同一次生成。单次时长上它与 Matrix-Game 4.0 都停在十几秒,LingBot-World 2.0 走小时级。开放方式上 LTX-2 社区许可附营收门槛,另两家没有这一条。
如果只想看上一代实时交互世界的规格与实测表现,可以参考 Matrix-Game 3.5(昆仑万维 Skywork 推出的上一代实时交互世界模型,延续了动作控制与长时序记忆的设计)。
EchoWM 的应用场景与适用人群
这套接口把首帧、场景描述与操作串当成一组输入,常见场景包括:
- 交互场景预演:用键位字符串驱动镜头走一遍路线,先看可交互效果,再决定是否制作精细美术资产。
- 短片镜头续接:上一段末帧接着下一段生成,镜头与环境声一起延续,减少逐段起头的接缝。
- 具身环境构建:把机器人移动写成动作序列,在生成环境里先行验证路径、视角与场景可读性。
- 空间音频试验:声场跟随画面变化,可测试某段设计里环境声与语音该落在什么位置。
适用人群:世界模型与视听生成方向的研究团队、需要低成本预演交互场景的内容团队,以及为智能体搭建可控环境的工程团队。
EchoWM 的使用方法
官方提供的是本地运行路径:从仓库拉代码与权重,按内置样例验证环境,再把首帧与动作序列换成自己的。
- 确认硬件与环境:一张 NVIDIA 显卡即可起步,多卡按样例分片执行;Python 依赖按仓库说明安装,文本编码器以 bfloat16 运行。
- 取代码与权重:从 JoyAI-Echo 官方仓库 克隆后,在
echo_wm目录执行hf download Echo-Team/Echo-WM --local-dir checkpoints取回检查点。 - 准备文本编码器:
gemma-3-12b-it-qat-q4_0-unquantized属受限仓库,需先在模型页接受许可并执行hf auth login,注意取未量化的那一份权重。 - 运行内置样例:执行
python scripts/run_wm_case.py --case examples/wm_cases/0010,输出目录会同时留下result.mp4与本次的提示词、动作串、随机种子记录。 - 换成自己的画面:用
--image指定首帧,六字段提示词写进--prompt,动作串写进--action-str,视角与引导强度分别由--fov-deg、--video-cfg、--audio-cfg控制。
需要图形界面时执行 ./run_gradio.sh 并访问本机 7860 端口,可在界面上直接拖参数、单独关闭音频轨或动作叠加层。官方没有提供公开的在线体验入口,显卡型号与显存下限也未给出统一数值。
EchoWM 的项目地址
- 项目主页(论文与视听样例):https://echo-team-joy-future-academy-jd.github.io/Echo-1.5-Page/wm/
- GitHub 主仓库(代码、权重下载与运行脚本):https://github.com/jd-opensource/JoyAI-Echo
EchoWM 的价格与开源情况
EchoWM 的代码与权重按 LTX-2 社区许可(2026 年 1 月 5 日版)分发,个人与中小团队可直接下载、修改与再分发,不产生许可费用。
许可里有一条需提前看清的门槛:年营收达到 1000 万美元及以上的商业实体,必须另签付费商用协议,未签约的商业使用被明确禁止。它与常见的 Apache-2.0 不同,商用前应回到仓库 LICENSE 原文核对自己是否落在该范围内。成本则落在算力上:一次十秒左右的片段要同时加载视觉主干与 12B 量级文本编码器,显存占用随分辨率与步数而变。
EchoWM 的常见问题
EchoWM 和普通文生视频模型有什么区别?
区别在于可交互。EchoWM 接受键位动作序列与视角参数,画面与环境声、语音在同一轨迹里连续演化;普通文生视频只输出一段固定片段。
跑 EchoWM 需要什么硬件?
官方只要求 NVIDIA GPU 并支持多卡并行,没有给出统一的显存下限。文本编码器以 bfloat16 运行,实际占用随分辨率与采样步数变化,建议先按内置样例测一次占用。
能用它做商用项目吗?
可以,但要先看主体规模。LTX-2 社区许可允许一般主体使用与再分发;年营收达到 1000 万美元及以上的公司须另签付费商用协议,未签约的商用被明确禁止。
相关文章


 浙公网安备33010202004812号