

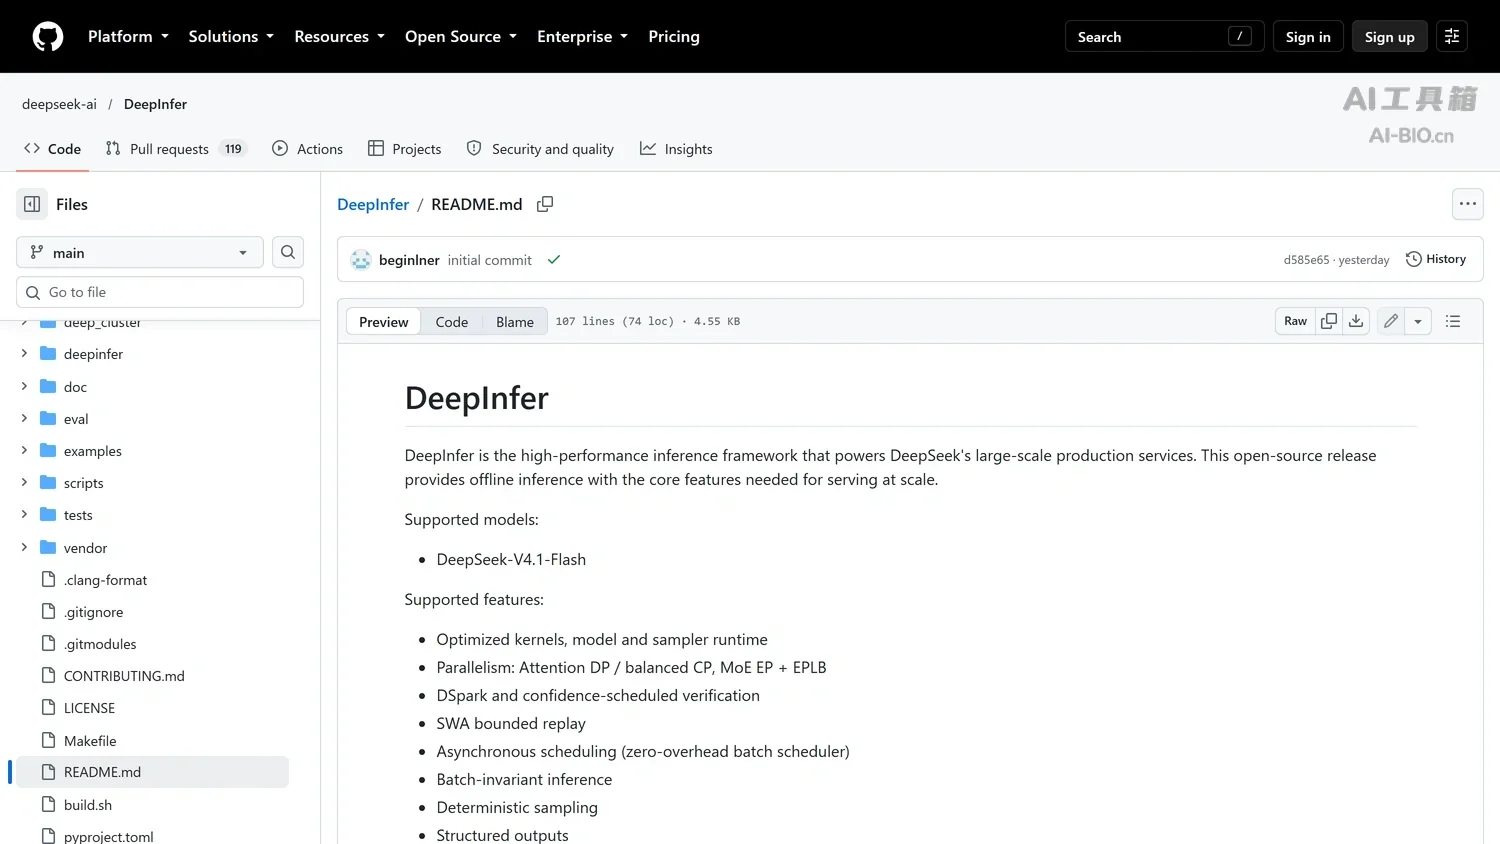
DeepInfer是DeepSeek于2026年10月全面开源的大规模推理框架,支撑线上 DeepSeek-V4.1-Flash 的高吞吐服务,集成高性能算子与深度优化的推理引擎,支持分布式推理、推测解码、SWA 有界重放与结构化输出,可在英伟达与华为昇腾平台上运行,适用于企业自建私有化推理集群、云厂商搭建在线推理服务等场景。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 大规模云服务推理框架(开源) |
| 出品方 | DeepSeek(深度求索) |
| 发布时间 | 2026 年 10 月 20 日 |
| 开源许可 | Apache-2.0 |
| 支持模型 | DeepSeek-V4.1-Flash |
| 支持硬件 | NVIDIA SM100 系列 GPU、华为昇腾 950 NPU |
| 运行环境 | Linux、GCC 13+、Python 3.12、CUDA 13 或 CANN 9.2 |
| 并行策略 | Attention DP/平衡 CP、MoE EP 配 EPLB |
| 生产实绩 | 155 万亿 Token/天;38 美元/卡/小时(谷价) |
| 未开源部分 | KV cache 管理、负载均衡等与内部设施耦合的组件 |
DeepInfer 的核心能力
官方把能力分成两层:底下是算子与运行时,上面是集群调度与并行。前者决定单卡的吞吐上限,后者决定整个集群少空转多少卡。
算子层与推理引擎的两层结构
算子来自一组已单独开源的库:注意力 FlashMLA、矩阵乘 DeepGEMM、专家通信 DeepEP、算子生成 TileKernels 与 DeepSelect,自研部分用 TileLang 编写。这次按生产调用顺序串成引擎,补上模型运行时与采样器运行时,把此前分散发布的算子库按线上服务的调用路径收进一处。
Prefill 用小专家并行,Decode 用 Wide-EP
两段任务用两套并行度。部署问答给的取值:Prefill 用 EP2 至 EP8、DP2 至 DP8,显存允许就取最小;Decode 用 EP64 至 EP128 的 Wide-EP,卡够就取最大;视觉编码器单卡部署。配合 EPLB,Prefill 慢卡与均值之比实测 1.045 至 1.074,Decode 为 1.090;官方称负载均衡达到完美均衡离线基准的约 80%。
推测解码与 SWA 有界重放
推测解码官方叫 DSpark,用草稿 token 加速、按置信度决定验证多少位;开关是 DEEPINFER_ENABLE_MTP_VARLEN=1,草稿上限由 DEEPINFER_USE_NEXTN_DECODE 控制,默认 5。SWA 有界重放只回放最近 128 个 token,把重算成本压成常数,官方称预填充总量接近减半。
异步调度与结果可复现
异步调度器把 CPU 侧批调度与设备侧执行重叠,官方称零开销批调度,默认开启。批次不变推理用 DEEPINFER_BATCH_INVARIANT=1 打开,保证同一请求在不同批次组合下结果一致;确定性采样再关掉变长草稿并固定 seq_seed。两项只在 NVIDIA 平台生效。
结构化输出与跨平台运行
结构化输出把生成约束在正则、JSON Schema 或 EBNF 内,参数从 so_args 传入,适合工具调用与表单填充。配套的 deepseek-recipe 按特殊 token 分段编码,压掉长输入分词耗时,也挡住特殊 token 注入。硬件支持 SM100 与昇腾 950,昇腾侧需 CANN 9.2;这条路线与站内写过的昇腾份额变化同线。
DeepInfer 与同类推理框架的对比
DeepInfer 一列取自官方文档,其余三列取自各自仓库 README 与许可证原文。
| 对比维度 | DeepInfer | vLLM | SGLang | TensorRT-LLM |
|---|---|---|---|---|
| 出品方 | DeepSeek | vLLM 开源社区 | SGLang 开源社区 | NVIDIA |
| 开源许可 | Apache-2.0 | Apache-2.0 | Apache-2.0 | Apache-2.0 |
| 支持模型 | 仅 DeepSeek-V4.1-Flash | 多家族模型通用 | 多家族模型通用 | 多家族模型通用 |
| 支持硬件 | NVIDIA SM100、昇腾 950 | NVIDIA、AMD、Intel 及插件硬件 | NVIDIA、AMD、TPU、NPU 等 | NVIDIA GPU |
| 设计重心 | 集群级两段式并行与重算成本 | 通用吞吐与易用性 | 调度与前端语言 | 单卡到多卡的极致性能 |
| 开箱即用的在线服务 | 否,KV cache 与负载均衡未开源 | 否,需自建周边 | 否,需自建周边 | 否,需自建周边 |
| 使用门槛 | 按源码构建,绑定特定 CUDA 或 CANN 版本 | pip 安装后即可运行 | pip 安装后即可运行 | 需按版本编译,绑定 NVIDIA 生态 |
| Star 数(10-21) | 约 14,000 | 94,496 | 37,530 | 14,890 |
八行里最能说明差异的是支持模型、设计重心与使用门槛三行:DeepInfer 只认一个模型,把并行度与重算成本做到集群级,代价是按源码构建并绑定特定 CUDA 或 CANN 版本;vLLM 与 SGLang 走通用路线,模型覆盖与安装便利性更高,但不替某一家模型做深度裁剪。四家许可证均为 Apache-2.0,差别在生态不在授权。
训练侧也有同类产物:QwenGyre 是阿里千问开源的在线强化学习框架,同样只服务自家模型,同样把并行与调度做成可配置项。
DeepInfer 的应用场景与适用人群
官方把它定位在私有化与公有云的大规模部署,常见场景包括:
- 私有化推理集群:手上有 SM100 或昇腾 950,缺的是把卡用满的调度经验,官方并行度配置可直接当起点。
- 云厂商与算力服务商:要算清一次调用的真实成本,155 万亿 Token/天与 38 美元/卡/小时是少见口径。
- 需要结果可复现的场景:评测与效果对照要求同一输入必得同一输出,批次不变推理与确定性采样可用。
- 国产芯片适配:昇腾侧有官方路径与 CANN 9.2 要求,比从通用引擎改移植少走一段。
适用人群:有自建集群的模型团队、云厂商推理平台研发、需要复现官方部署参数的工程团队;只调用 API 的用户用不到这一层,站内企业级知识管理平台更贴近直接使用。
DeepInfer 的使用方法
官方只提供源码一条路径。
- 准备环境:Linux,GCC 13 以上,Python 3.12,NVIDIA 需 CUDA 13,昇腾需 CANN 9.2。
- 构建:导出
DEEPINFER_ACCELERATOR=nvidia或ascend,执行./build.sh。 - 准备权重并跑离线推理:默认 checkpoint 为
deepseek-ai/DeepSeek-V4.1-Flash-1017,本地副本用DEEPINFER_HF_MODEL_DIR指定,随后跑python examples/offline_inference.py。 - 自建在线服务:KV cache、分离部署、跨副本负载均衡需自行补齐,参数写在 DeepInfer 官方仓库的部署问答里。
官方基准是预填充 4 张 SM100、解码 64 张 SM100。
DeepInfer 的价格方案
框架本身不收费:仓库采用 Apache-2.0,下载、修改与商用都不需付费或授权,也没有订阅与接口计费。成本落在硬件与部署:官方建议最小高效部署单元是 64 张卡预填充加 64 张卡解码;每台 KV cache 服务器配 20 块 30.73 TB 固态盘,读不低于 40 GB/s、写不低于 5 GB/s;跨机房按每 8 张卡约 400 Gbps 互联带宽估算。
收入口径方面:单一集群每天吞吐 155 万亿 Token,整体收入按谷价折算为每卡每小时 38 美元。官方同时说明负载均衡只做到完美均衡离线基准的约 80%。deepseek-recipe 以 MIT 许可单独开源;DeepSeek 的算力投入与定价空间,站内此前在DeepSeek 融资与国产算力一篇里算过。
DeepInfer 的常见问题
DeepInfer 和 vLLM 是什么关系?
官方致谢写明它最早主要基于 vLLM 构建。差别在于只服务 DeepSeek-V4.1-Flash 一个模型,按该模型形状重做并行度与调度。
DeepInfer 支持其他模型吗?
不支持,README 的支持模型一栏只有 DeepSeek-V4.1-Flash,其他模型仍需 vLLM 或 SGLang。
开源版能直接搭一套线上服务吗?
不能。这次发布只提供离线推理与大规模服务的核心能力,KV cache 系统、分离部署与跨副本负载均衡仍需自行补齐。
相关文章

 浙公网安备33010202004812号