
老高AI观察 · 第23期|2026 年 10 月 7 日
过去几年,中国的 AI 芯片几乎都活在”被卡“的叙事里。10 月 6 日,华为轮值董事长徐直军的一段问答被媒体转了个遍。那段话出自 9 月全联接大会(HC)媒体沟通会——从华为能够统计到的数据看,昇腾在中国市场的份额已超过英伟达。但同一位发言人也承认,产能连国内需求都满足不了;华为给出的应对不是继续比单颗芯片,是换了一套打法:把百万颗处理器连成一台计算机。份额是结果,换赛道才是原因。
华为把百万芯片连成一台计算机
先摆事实。他重点讲的两样东西是 9 月 17 日大会发布的。一样是 Peerium 计算架构——基于嵌套并行、统一内存寻址和平等互联,让百万级处理器强扩展。另一样是灵衢总线(UnifiedBus,简称 UB):用统一协议把 CPU、NPU、内存、固态硬盘、网卡和交换机连起来,让计算、存储、网络平等互联。
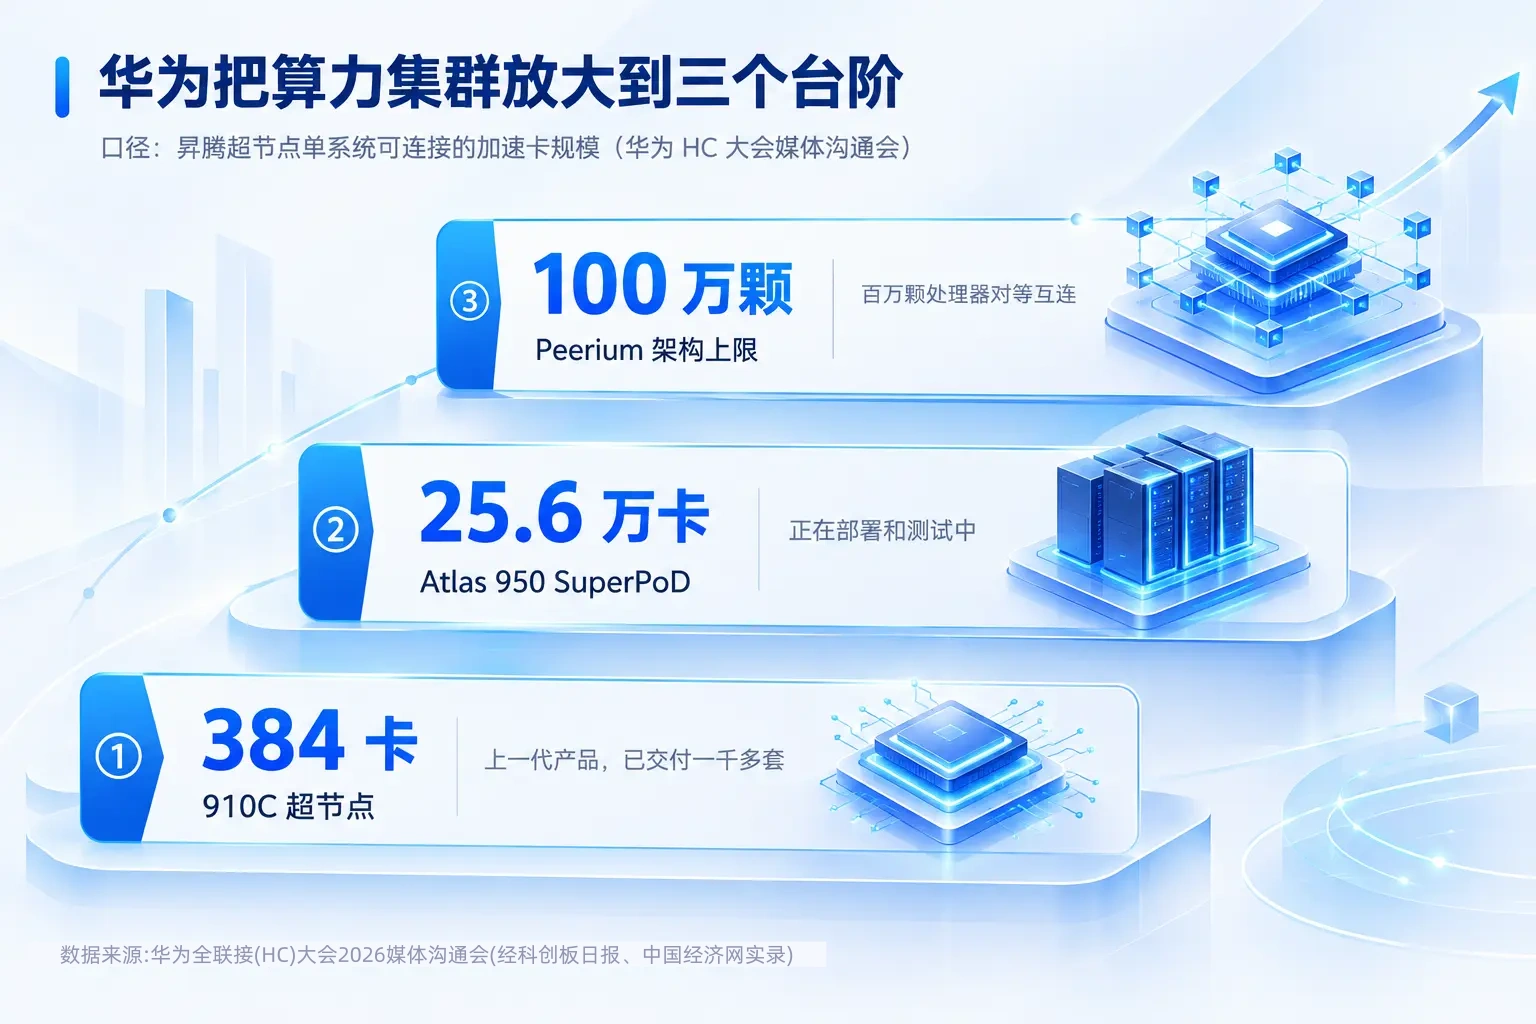
产品层面,华为展出了昇腾 950 和 Atlas 950 超节点。面向推理的 950PR 已于 2026 年一季度上市,面向训练的 950DT 还在测试,规模供货要等到今年年底或明年初。系统侧,上一代 910C 超节点做到 384 卡、已交付一千多套;Peerium 架构的 Atlas 950 超节点,25.6 万张卡规模的集群正在部署测试中,按设计最终可达百万颗对等互连。
海思首席科学家廖恒补了规模来由:未来两年中国预计出现 6 到 7 家前沿 AI 实验室,目标训练 10 万亿到 40 万亿参数的基础模型,与超节点内存容量匹配;另一个约束是电,20 万卡左右是保守选择。(信源:灵衢官方开放协议、科创板日报实录)
这波热闹不是一天攒出来的
这不是一场发布会临时攒出来的方案。去年的 HC 大会上,徐直军就发布了昇腾芯片路线图(950、960、970 以及超节点与集群方案),并宣布开放灵衢协议。今年展出的昇腾 950 和 Atlas 950 超节点,是那条路线的第一个落地形态。
更早的铺垫在软件侧。国产芯片难推的一直不是硬件,是软件——昇腾最常被提到的障碍,就是 PyTorch 加 CUDA 的生态壁垒。这个局面近一年半松动了:廖恒的说法是,随着大模型变得更细粒度,前沿实验室已不再过度依赖 CUDA。站内也写过:DeepSeek 开源昇腾组件那次,六个组件几乎是对着英伟达的软件栈逐个补齐的。
卡在制程,就在互联上换道
为什么非要费这个劲,把几万颗芯片连成一台计算机?因为单颗芯片这条路短期走不通——徐直军没有回避:华为的单芯片仍然受国内制造工艺的限制。
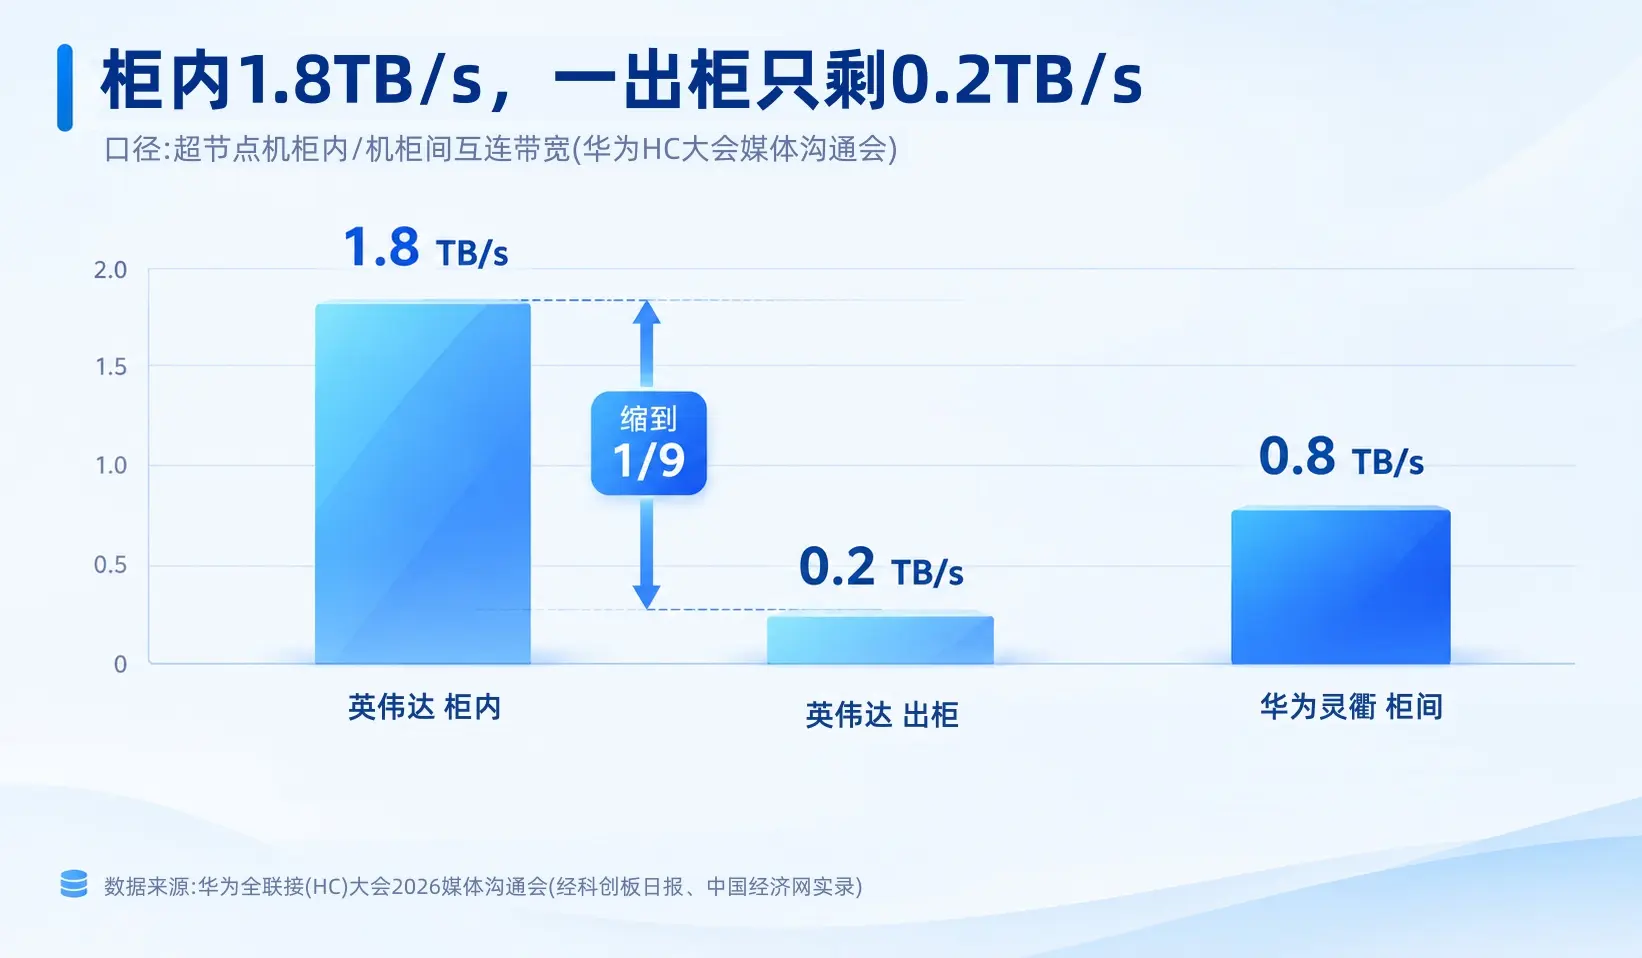
而”多芯片互联”,过去一直是打补丁。英伟达做了柜内 NVLink 和柜外 InfiniBand 两套网络,跨柜要做协议转换——徐直军给的对比很直接:最新一代 NVL72 柜内带宽 1.8TB/s,一出柜就掉到 0.2TB/s。要把百万颗处理器当一台计算机用,这个带宽根本不可能。廖恒补了另一层代价:协议转换一次至少是微秒级。
华为的答案是把”Link”做成”总线”:灵衢用统一协议,数据包从柜内网转到柜间网大约只要 150 纳秒,比协议转换省一个数量级;徐直军说基于灵衢,柜间带宽最高可做到 800GB/s。这个数字离柜内 1.8TB/s 还有距离,但它是”出柜不掉”的那一档。站内早前那篇词元用量全球第一讲的是用量,而用量能否持续,最后回到单位算力成本。
份额超过不等于交付跟得上
说回那句最容易被传播的话。徐直军讲得很清楚:在中国统计英伟达的占有率很难,但”从华为能够统计到的数据看,昇腾应该已经超过了英伟达”。这是自述口径,没给具体数字,也没有第三方机构核过。
更有信息量的是紧接着的两句。一是产能:昇腾满足国内需求还远远不足,没有全面出海计划,只有少数国家做了测试。二是节奏:面向推理的 950PR 上市量不算大,面向训练的 950DT 超节点要等到今年年底或明年初才规模供货。他说从明年开始会有大量模型训练构筑在 950DT 上——但这是预期。
所以正确读法是:份额反超不等于交付跟得上。份额这件事,很大程度不是”谁更强”投出来的票,而是”能不能买到别家的”逼出来的结果,瓶颈已经从”有没有需求”换成了”能不能交付”。这也是我把上个月那篇讲中美 AI 差距收窄到 3%的判断接在这里的原因,而这一期老高AI观察写到第 23 期,这条线一直在跟。
这件事先动到谁
普通用户这边,影响是间接但实在的。模型能跑多大、跑多便宜,很大程度取决于算力供给。国产算力这条路一旦走得通,”模型能力”就越来越少卡在芯片供应上——你手里的国产模型会继续变强、继续便宜。
做 AI 工具生意的人,盘算要具体一些。过去两年,选国产算力的最大顾虑是”生态不好用、迁移成本高”,这个顾虑正在变薄。值得盯的是三件事:能不能稳定拿到算力、成本多少、迁移要付多少一次性代价。放到整站看也一样,我们 AI 模型库 里的国产模型,今年明显是”数量更多、差异更小”。
这些数字都还没人独立复算
这一段的判断有几个明显的软肋,我逐条说清楚。
第一,”份额超过英伟达”是华为自述口径——徐直军自己就说统计很难,也没给具体百分比,本文只保留原话、不引用份额数字。第二,25.6 万卡超节点”正在部署和测试中”,不是稳定商用,量产交付之间还隔着良率、电力、运维。第三,”明年会有大量模型训练构筑在 950DT 上”是预期。第四,软件差距”明显缩小”不等于追平,新生态和旧生态在算子覆盖、开发者社区上仍有距离。所以我只在”竞争单位从单颗芯片换成整台计算机”这一层站得住。
现在能做的几件事
落到动作上,还是按不同位置分开说。
如果你是普通用户——不用做什么。国产模型该怎么用还怎么用,真正会变的是明年之后你手上那些工具的响应速度和价格。
如果你在做 AI 应用或副业——把”算力从哪来”写进你的成本表。国产那一侧要试的不是”能不能跑”,是”迁移一次要花多少时间”。华为这条线上,开发者侧的工具也在铺——面向企业研发的 AI 编程工具可参考 华为云码道(华为云 CodeArts 的 AI 编程工具)。
如果你在看行业——把注意力从”谁的单卡更强”挪到”谁的集群更大、交付更快”。接下来一年国产算力的新闻,多数会落在产能、电力和生态迁移上,而不是参数。

最后说一句
我的结论是:华为这次的动作,不是把单颗芯片做到最强,而是把竞争单位从”一颗芯片”换成了”一台计算机”——份额是结果,换赛道才是原因。
关于华为昇腾,被问最多的几点
华为昇腾真的超过英伟达了吗?
这是徐直军在 HC 大会上的自述口径——”从华为能够统计到的数据看”。他也承认统计英伟达在中国的份额很难,没给具体数字,目前没有第三方可核对的结论。
这件事跟我用什么模型有关系吗?
短期没有直接关系。中期看,国产算力的接入成本和可得性会变好——如果你在做 AI 应用,值得盯的是能用上多少算力、成本多少,而不是排名。
华为为什么不全面出海?
徐直军的说法是产能不够:昇腾满足国内需求”还远远不足”,没有全面出海计划,只有少数国家做了测试。
条目出处
- 华为全联接(HC)大会 2026 沟通会(2026-09-17;纪要 10/5 披露):徐直军、廖恒答媒体问
- 科创板日报(2026-10-06):沟通会问答实录,记者黄心怡
- 中国经济网(2026-10-06):刊出沟通会全文摘要
- 21 世纪经济报道(2026-10-06):950PR 一季度上市、950DT 年底或明年初供货
我是老高,AI工具箱站长,每天盯着AI工具生态的变化。关心AI工具怎么真正用到生意里,而不只是看热闹——👉 老高AI交流群入口
相关文章

 浙公网安备33010202004812号