
老高AI观察 · 第18期|2026 年 10 月 2 日
国庆假期第二天,AI 圈最硬的消息不是哪个模型又拿了第一,而是一家中国公司把最难的那一层开源了。
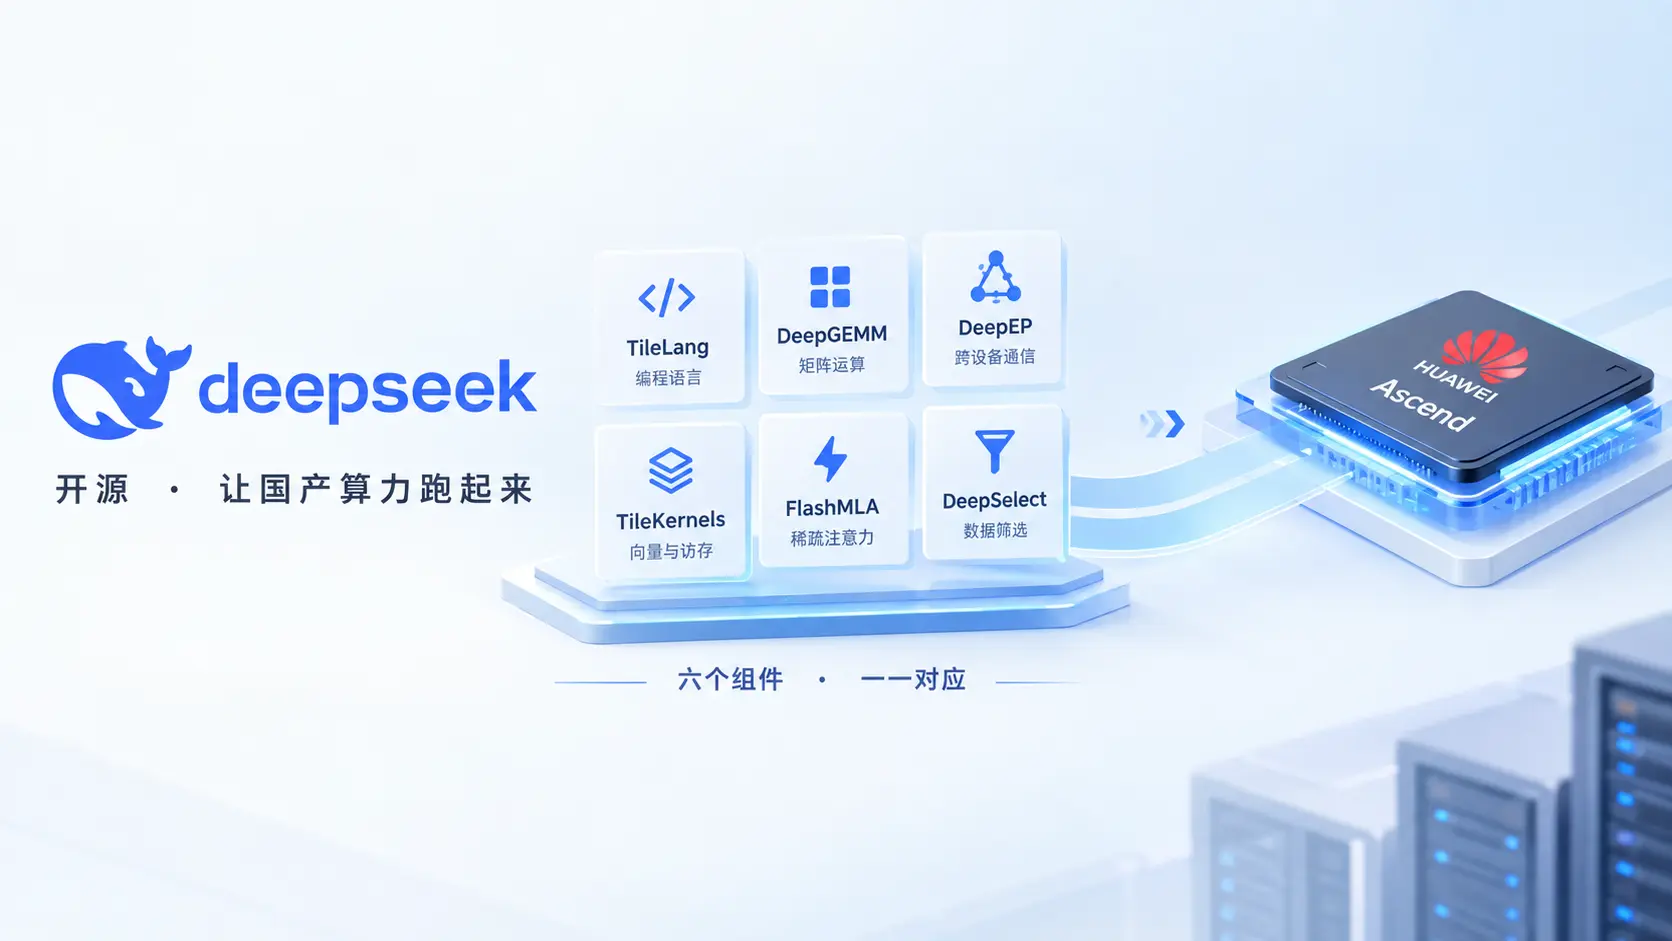
9 月 30 日,DeepSeek 官宣面向华为昇腾的开源基础设施组件,一共六个,覆盖编程语言、计算库和分布式通信,与它此前给英伟达做的那一套一一对应。
假期里这条消息没炸出多少水花,但分量和发一个新模型不是一个量级:模型榜单每周都在换名字,这次动的是榜单下面那一层——CUDA 的护城河从来不是芯片性能,是迁移成本。
六个组件,全对着英伟达开
据 DeepSeek 官方公告和它 同步放出的开源仓库,六个组件分别是 TileLang(编程语言)、DeepGEMM(矩阵运算)、DeepEP(跨设备通信)、TileKernels(向量与访存)、FlashMLA(稀疏注意力)、DeepSelect(数据筛选)。
关键在”一一对应”。以前国产卡要跑大模型,算子得一家一家手工重写;现在接口、用法甚至函数名,都对着英伟达那一套来。据 太平洋科技 9 月 30 日的报道,这是模型侧能力第一次往芯片底层延伸一整层。
DeepSeek 称训练用到的每个 TileLang 算子,在昇腾上都有高性能实现;同一天华为在 CANN 社区把联合成果开源,两家还联合调了 128 卡昇腾 950 超节点。
这一步埋了比看上去更久
这不是突然的开源。TileLang 最早出自北京大学团队,昇腾版 2025 年 9 月已开源过一次;DeepSeek 把它当主线工具用了一年,先在英伟达的卡上验证,再往昇腾上搬。
时机也有铺垫。有报道估算,昇腾 910C 的推理性能约为英伟达 H100 的六成,其中相当一部分是靠软件优化抠出来的。
把节点连起来:模型先证明能用国产卡跑,再把跑得动的软件交出来——剩下的就是让别家跟着搬。这跟第 13 期《美团新模型不再开源》是一条线;再往前《英伟达限制Claude》那期讲的是门被人从外面锁上,这次是有人在里面配了钥匙。
CUDA 真正贵的是迁移成本
很多人把英伟达的优势理解成”卡快”。卡确实快,但它最贵的是软的:据 AI Industry Today 这篇梳理,全球约 400 万开发者在写 CUDA 代码,十几年的库和教程堆在那里。从英伟达换走,付的不是硬件差价,是几个月的重写和调优。
这次开源针对的正是这一环:TileKernels 只维护一套 Python 接口,底层自动选英伟达还是华为;昇腾版 DeepGEMM 保持接口兼容;昇腾版 DeepEP 把通信接口对齐英伟达的写法。
把迁移从”重写一遍”改成”换个后端”,这才是它真正的价值。
面壁智能的 CANN 端侧模型走的是另一条路,把模型压小、适配华为软件栈——一个补训练侧工具链,一个补端侧模型适配。
从几个月重写,压到换个后端
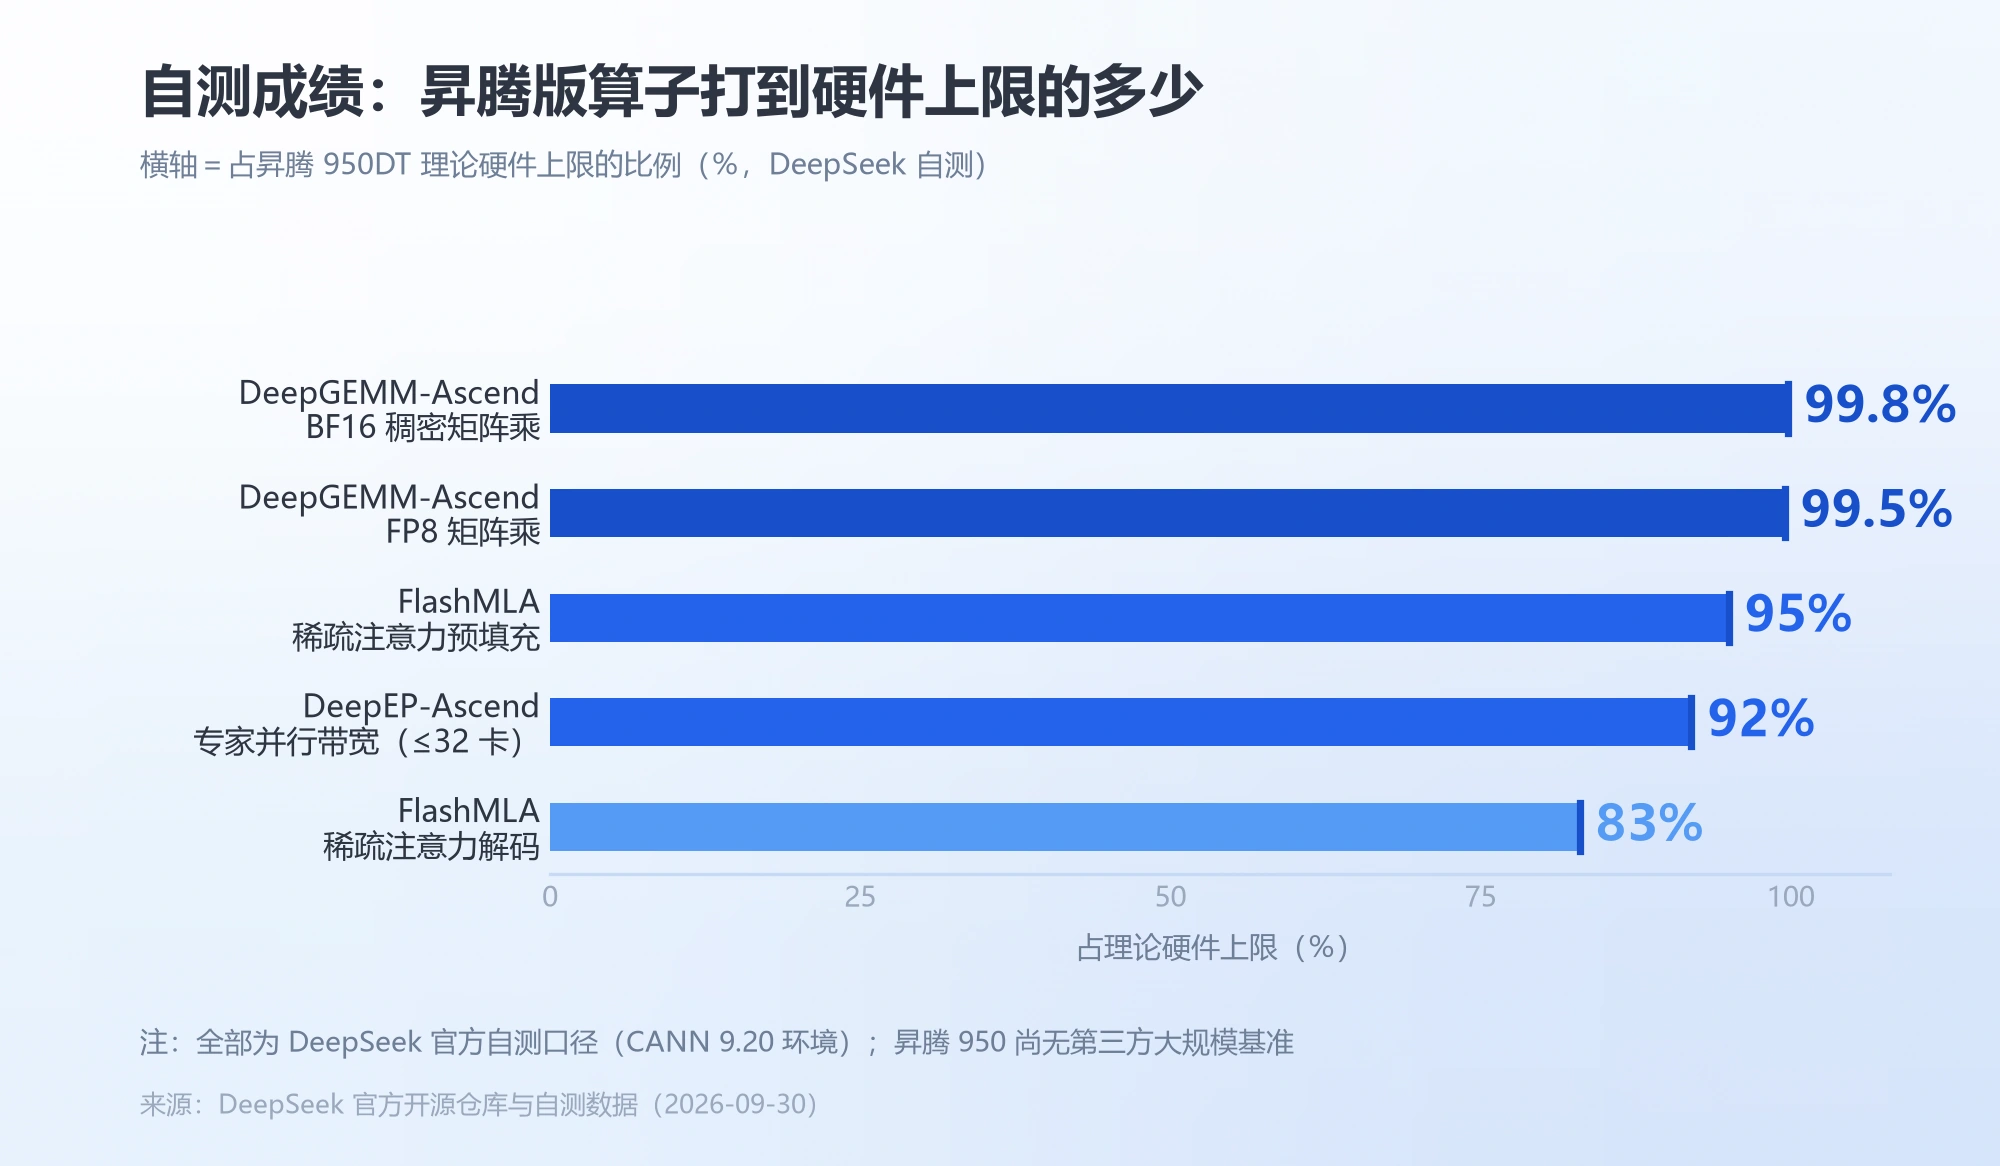
性能绕不开。数字全部来自 DeepSeek 自测(CANN 9.20 环境):昇腾版 DeepGEMM 在 950DT 的 BF16 稠密矩阵乘上打到硬件上限的 99.8%,FP8 约 99.5%;FlashMLA 预填充 410 TFLOPS、解码 360 TFLOPS。
通信那边,DeepEP 在 32 卡以内报出的带宽是物理上限的 90% 到 95%;华为公布的离线测试是,EP32、128K 上下文下 V4.1-Flash 每张卡每秒能出 2,469 个 token。
这些数字怎么读?我的看法是:很大一部分是软件的问题——”国产卡跑不动”这个说法里,本来就有一块该由软件补。这条线都收在 老高AI观察 里。
这几种人要重新对口
普通用户可以先把心放回去。这套东西是给训练和部署的人用的,短期不会改变你手机上用哪个助手。真正的变化在两三年后——训练成本降下来,调用价格才有继续下探的空间。
做 AI 工具生意的人要重算一遍。以前评估一个模型看能力和价格,现在多一栏:迁过去我的代码要改多少行。多一个选项不意味着立刻换,但供应链上多一条腿,议价底气不一样。
华为这边也在补。站内收录的 openPangu 2.0 是华为开源的超长上下文模型与智能体平台——工具链和模型两头都在长,才叫生态。
若想先感受 DeepSeek 自家的入口,可参考 DeepSeek R1T2(DeepSeek 官方对话与 API 入口)。

这些规格还没人验过
这段说点不利的。第一,所有性能数字都是厂商自测。昇腾 950 还没有第三方大规模基准,同一个算子换个模型、换套并行策略,表现能差很远——自测成绩单只能当”上限存在”的证据。
第二,这套东西没让你离开厂商栈,只是换了一家。昇腾版 DeepGEMM 仍要华为硬件和 CANN,TileKernels 底下要么是 CUDA 要么是 CANN。
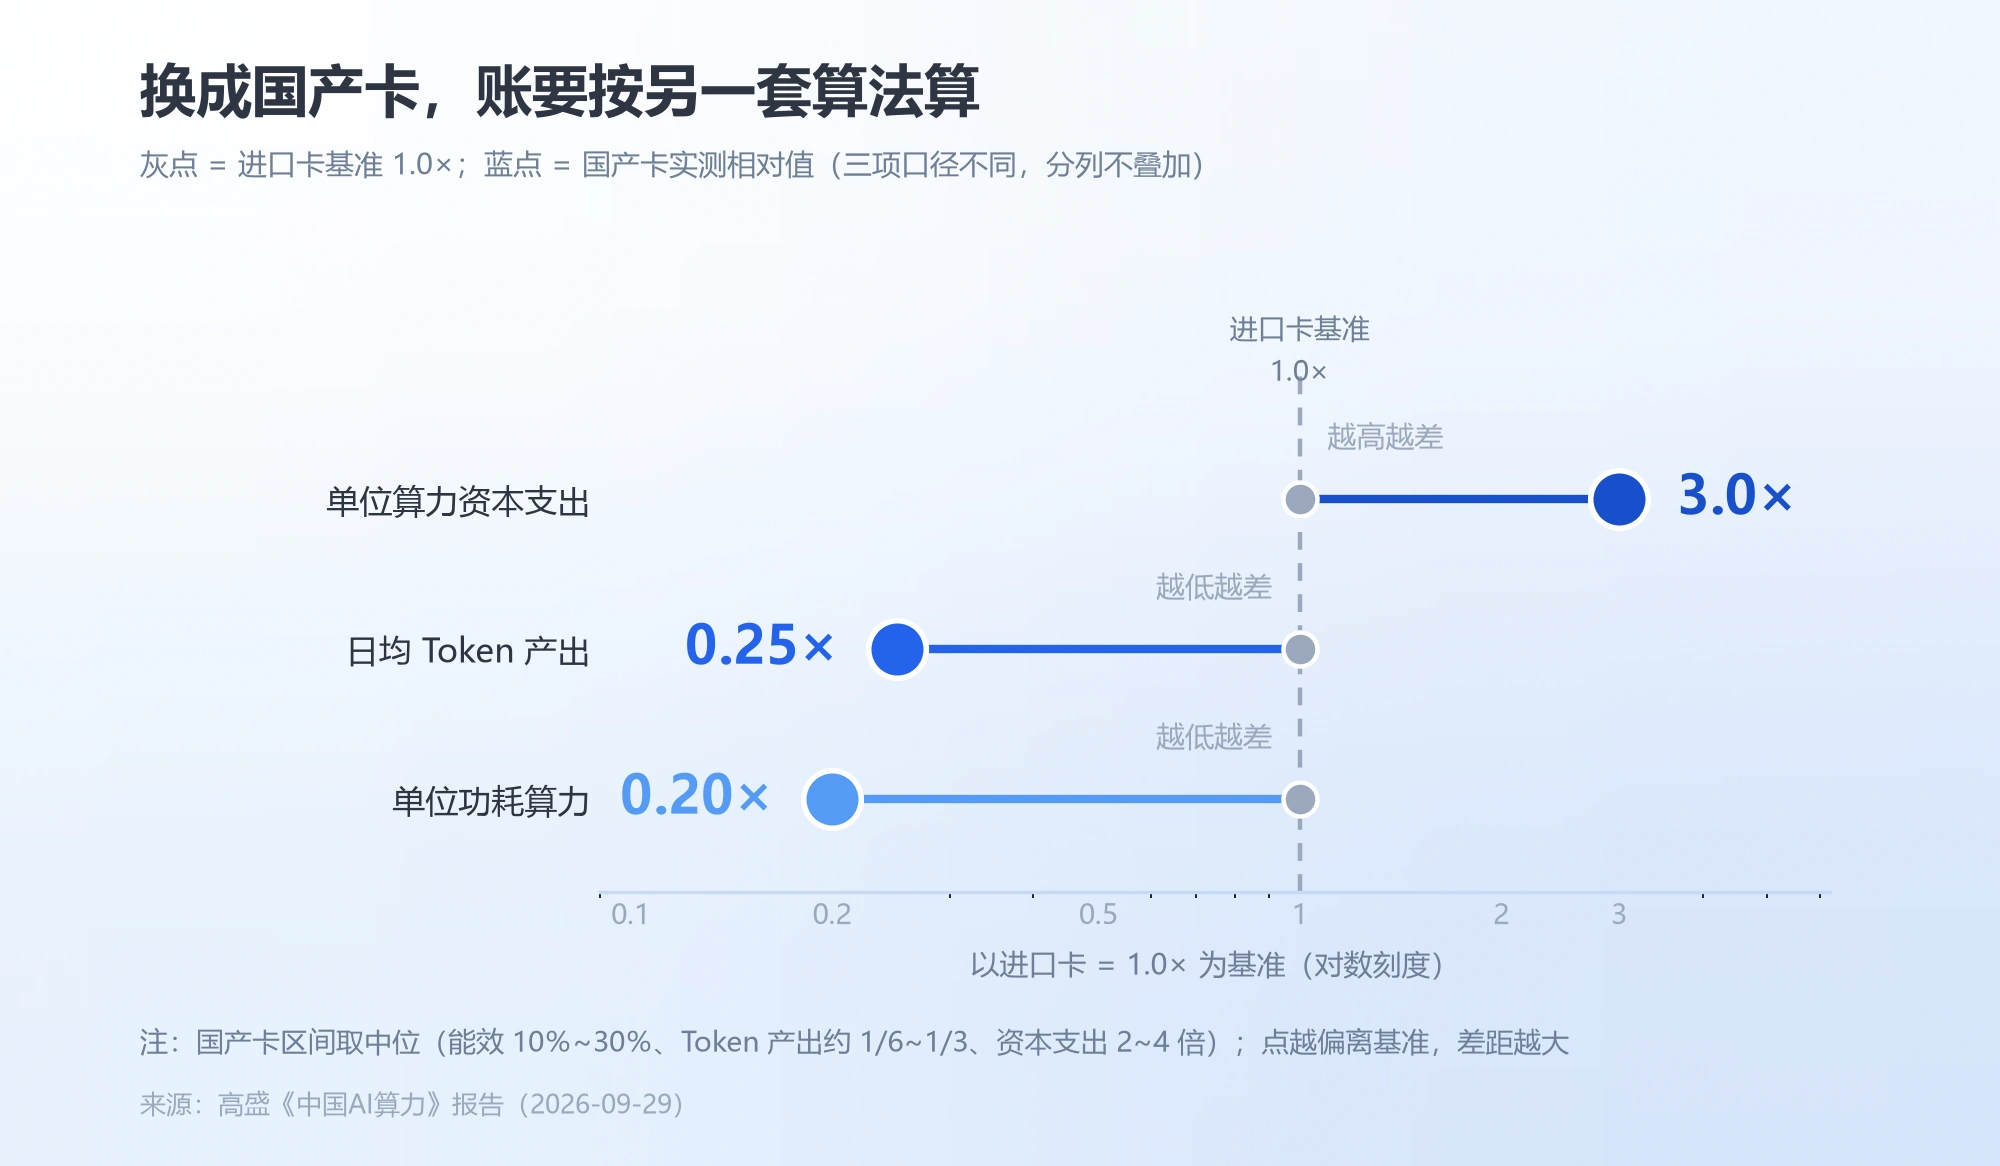
第三,硬件差距还在:高盛 9 月 29 日报告称,国产 AI 加速卡单位功耗算力只有进口芯片的 10% 到 30%,拿到同样算力要多花 2 到 4 倍的钱。站内收录的 NVIDIA PAIR 是英伟达这一侧的工具。
还有一条大背景:工信部口径,到今年 7 月全国算力设施上架率只有 71.4%——建好的卡近三成还没投产。
接下来几步怎么走
对普通用户,最实用的是别急着站队。等第三方基准出来再判断——硬件竞争以年为单位,早半年晚半年没有影响。
对做产品的人,建议先小规模试:挑一个跟主流程耦合最松的模块搬到昇腾环境,量清楚改了多少行、性能掉了多少。站内收录的 JellyToken 这类聚合调用平台,就是做对照测试的入口。
对做内容的人,值得提前改评测维度:它能不能跑在国产算力上、能不能本地部署。
若想看这套逻辑往智能体延伸的样子,可参考 DeepSeek DSec(DeepSeek 公开的大规模智能体训练沙箱平台)。
这句我想留个记号
国产算力真正缺的从来不是卡,是让卡跑起来的那一层软件——这一次补的,就是这一层。
关于这套昇腾工具链,答三点
普通用户能用上这些组件吗?
短期不能。受益的是跑训练和部署的团队与云厂商,普通用户感受到的是后续调用价格变化。
用了它就得换掉英伟达的卡吗?
不用。同一套 Python 接口可在两个后端切换,迁移按需选择。
这些组件是 DeepSeek 从零写的吗?
不全是。TileLang 最早出自北京大学团队,昇腾版此前已开源过一次。
本文资料来源
- DeepSeek 官方开源公告与 GitHub 仓库(2026-09-30):六个昇腾组件与自测性能数据
- 太平洋科技(2026-09-30):组件构成与 128 卡昇腾 950 超节点方案
- AI Industry Today(2026-10-01):达峰率与 CUDA 开发者规模
- Pandaily(2026-09-30):SuperPoD Flex 组网与 V4.1-Flash 离线数据
- InstaDataNews(2026-10-01):昇腾 910C 约 H100 六成推理性能
- 高盛《中国AI算力》报告(2026-09-29):国产卡能效与资本支出差距
- 工业和信息化部(2026-07-20):算力设施整体上架率 71.4%
我是老高,AI工具箱站长,每天盯着AI工具生态的变化。关心AI工具怎么真正用到生意里,而不只是看热闹——👉 加入AI工具箱免费社群
相关文章

 浙公网安备33010202004812号