
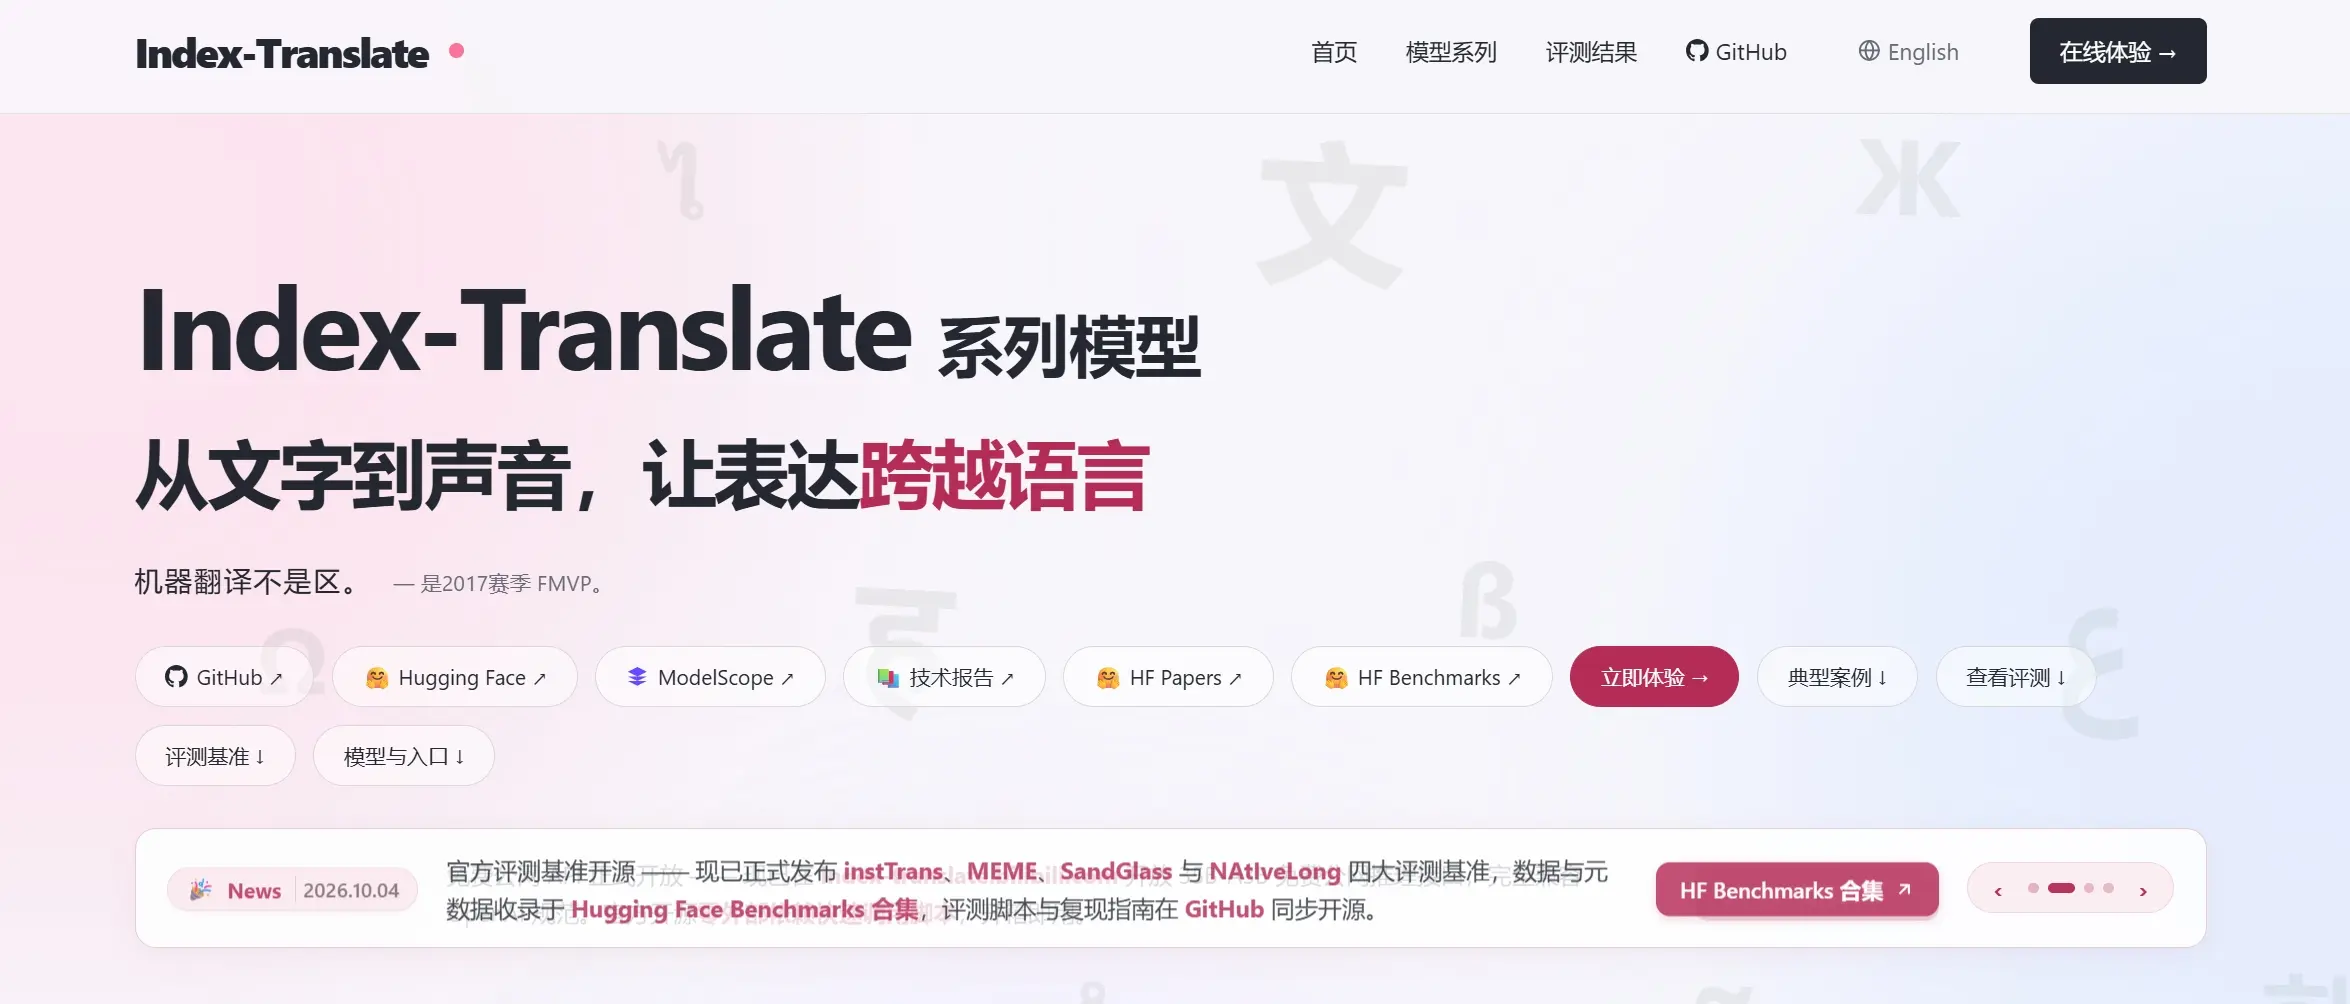
Index-Translate是一款由哔哩哔哩(B站)Index LLM 团队于2026年9月推出的开源多语言翻译模型家族,主要用于文本、语音与长文档的多语言翻译,支持 150 种语言以及术语、格式等翻译指令约束,适用于跨境电商、字幕配音与文档本地化等方向。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 开源多语言翻译模型家族 |
| 出品方 | 哔哩哔哩 Index LLM 团队 |
| 发布时间 | 2026年9月30日 |
| 支持语言 | 150 种 |
| 模型规格 | 2B / 9B / 35B-A3B(预览) |
| 开源协议 | Apache-2.0 |
| 部署方式 | 本地部署与免费在线接口 |
Index-Translate 的核心能力
Index-Translate 是哔哩哔哩 Index LLM 团队在 Qwen3.5 基础上构建的多语言翻译模型家族。文本模型覆盖 150 种语言,并可按术语、格式与内容保留等要求执行翻译指令;家族进一步延伸出语音字幕与配音、按目标音节数调整译文,以及整篇文档的一致翻译。
覆盖 150 种语言的多语言文本翻译
文本模型支持 150 种语言之间的互译,覆盖通用文本、结构化内容与网络社区用语。官方在 MEME 专项上以 3,638 条中译英案例、703 个词条与 857 个义项检验社区与文化表达的翻译质量,9B 档取得 0.7387,35B-A3B(预览)档取得 0.7405。模型同时处理 JSON、HTML 等结构化文本,翻译时保留原有的字段与标记。
面向术语与格式的指令遵循翻译
家族在训练中整合了指令遵循能力,可同时执行硬性约束与软性约束。硬性约束包括术语表强制替换与格式结构保留,官方以 instTrans 专项的 3,000 条任务、10 类约束检验该能力,9B 档的 IFscore 为 0.8209;软性约束涵盖语气风格调整与领域词义消歧,例如在工业制造语境下把 plant 译为工厂而非植物。
语音字幕与配音翻译
Index-Echo 负责语音方向:S2TT 版本把语音转为目标语言字幕,S2ST 版本在源说话人音色的条件下直接生成目标语言配音。Index-Homura 则按指定的目标音节数调整译文,官方在 SandGlass 基准上测得 9B 档有 81.92% 的结果落在目标音节数上下 10% 的区间内。
长文档全文一致翻译
Index-NativeLong 面向整篇文档,跨段落维持上下文一致。官方以约 3.2 万 token 的文档验证人名一致性,9B 档在 GuoFeng、BWB 与 Books 三项上分别取得 0.7891、0.7683 与 0.8848。相比按段切分的翻译流程,全文模式不会在段落交界处出现称呼漂移。
量化版本与本地部署
家族提供官方量化版本,GGUF 用于 llama.cpp 本地推理,FP8 与 NVFP4 用于 vLLM 服务,其中 NVFP4 面向 Blackwell 架构 GPU 优化。文本模型 2B 与 9B 的服务端上下文预设为 32,768 token,长文档模型可扩展到 20 万 token 以上。这类开源 AI 模型可直接在自有硬件上运行,也可以在官方提供的免费在线接口调用。
Index-Translate 与同类翻译模型的对比
| 对比维度 | Index-Translate | Hy-MT2-7B | Hy-MT2-30B-A3B |
|---|---|---|---|
| 出品方 | 哔哩哔哩 Index LLM 团队 | 腾讯混元 | 腾讯混元 |
| 模型规格 | 2B / 9B / 35B-A3B(预览) | 7B | 30B-A3B |
| FLORES(COMET-22) | 0.8789 | 0.8747 | 0.8787 |
| WMT26 | 75.35 | 60.51 | 66.81 |
| instTrans 质量 | 0.6771 | 0.5143 | 0.5725 |
| instTrans IFscore | 0.8209 | 0.6079 | 0.6415 |
| MEME | 0.7387 | 0.5139 | 0.5812 |
| 低资源 off-target | 4.0% | 35.7% | 14.5% |
上表 Index-Translate 一列取自哔哩哔哩 Index LLM 团队官方模型仓库,数值取其 9B 默认档;Hy-MT2 两列取自腾讯混元官方发布材料。三者的差异集中在指令遵循与社区表达两处:instTrans IFscore 上 Index-Translate 为 0.8209,高于 Hy-MT2-7B 的 0.6079 与 Hy-MT2-30B-A3B 的 0.6415;MEME 上为 0.7387,同样领先两档。低资源翻译的 off-target 率上,Index-Translate 为 4.0%,Hy-MT2-30B-A3B 为 14.5%,Hy-MT2-7B 为 35.7%。通用翻译三者接近,FLORES 均落在 0.87 上下。官方材料中另给出 DeepSeek-V4.1-Flash、GPT-5.6-Sol 与 Gemini 3.5 Flash Lite 的同表数值,三者属于通用大模型,未纳入上表。
如果任务集中在实时语音场景,可以参考 GPT-Realtime-Translate(OpenAI 推出的实时语音翻译与多语言对话模型,侧重低延迟的双向语音互译)。
Index-Translate 的应用场景与适用人群
该模型家族面向需要多语言互译且对术语与版式有要求的任务,常见场景包括:
- 跨境电商与本地化:商品标题、详情页与客服话术在 150 种语言间互译,术语表可强制统一品牌词译法。
- 字幕与配音制作:语音转字幕、配音翻译与按音节控长的改写分别由 Index-Echo 与 Index-Homura 承担。
- 长文档与出版:整篇合同、报告或小说的翻译由 Index-NativeLong 处理,人名与称谓在全文保持统一。
- 结构化内容处理:JSON、HTML 等带标记的文本在翻译时保留原有格式,适合接入自动化管线。
适用人群:需要本地化能力的产品与运营团队、以翻译模型搭建内容管线的开发者,以及处理长文档与配音字幕的制作人员。只做单次短句翻译的用户,使用通用大模型的对话界面即可满足。
Index-Translate 的使用方法
模型家族通过官方仓库发布,按以下顺序接入:
- 确认部署方式:访问 Index-Translate 官方仓库,按用途选择在线接口或本地部署。
- 调用在线接口:官方免费接口兼容 OpenAI 调用格式,端点地址为
https://index-translate.bilibili.com/v1,请求时指定 35B-A3B(预览)档模型。 - 本地部署:克隆仓库后执行
pip install -U vllm,再以vllm serve IndexTeam/Index-Translate-9B启动文本模型服务。 - 指定翻译约束:通过
--glossary参数传入术语表,或用--hard参数要求保留 JSON 等格式标记。 - 按任务切换脚本:长文档使用
doc_translate.py,语音字幕与配音分别使用s2tt.py与dub.py。
初次接入建议先用少量短句核对术语表与格式约束的生效情况,再扩展到完整文档。
Index-Translate 的价格与开源情况
Index-Translate 的权重、在线接口与配套脚本目前全部免费提供。官方于 2026 年 10 月 4 日开放了面向 35B-A3B(预览)的公共接口,调用时无需自备 GPU,也不设调用费用。
家族全部权重以 Apache-2.0 协议发布,覆盖 Hugging Face 与 ModelScope 两个平台,文本模型的 2B、9B 与 35B-A3B(预览)三档,以及量化后的 GGUF、FP8 与 NVFP4 版本均可下载。协议允许商业使用与二次分发,衍生作品需保留原始许可与署名。
Index-Translate 的常见问题
Index-Translate 支持哪些语言?
文本模型覆盖 150 种语言,可用于通用文本、结构化内容与社区表达的互译。语音与长文档部分的语言范围与文本模型不同,官方在模型表中单独列出。
Index-Translate 与 Qwen3.5 是什么关系?
整个模型家族在 Qwen3.5 基础上构建。Qwen3.5 提供基础的多语言理解与生成能力,Index-Translate 在其上做翻译方向的专项训练,并针对术语约束、语音与长文档等任务扩展出多个子模型。
Index-Translate 可以本地部署吗?
可以。官方放出 Apache-2.0 协议的全量权重与 GGUF、FP8、NVFP4 量化版本,2B 与 9B 两档可在单卡上通过 vLLM 或 llama.cpp 运行,也可以直接调用官方的免费在线接口。
相关文章

 浙公网安备33010202004812号