
老高AI观察 · 第44期|2026 年 11 月 19 日
11 月 12 日,豆包工作的模型选择页多了几行字:原来只有豆包 2.1 Lite 和 2.1 Pro,那天起接进 Kimi K3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash,倍率有高有低。值得停一下的是名字后的数字——GLM 5.3 是 0.80 倍,GLM 5.3 Flash 是 0.08 倍,DeepSeek V4 Pro 是 0.46 倍,豆包 2.1 Lite 和 DeepSeek V4.1 Flash 挂着「限时优惠」,标 0.01 倍。
老高判断:选 AI 这件事正在从「谁更聪明」变成「谁更划算」,而「划算」的标准,是平台替你写好的。
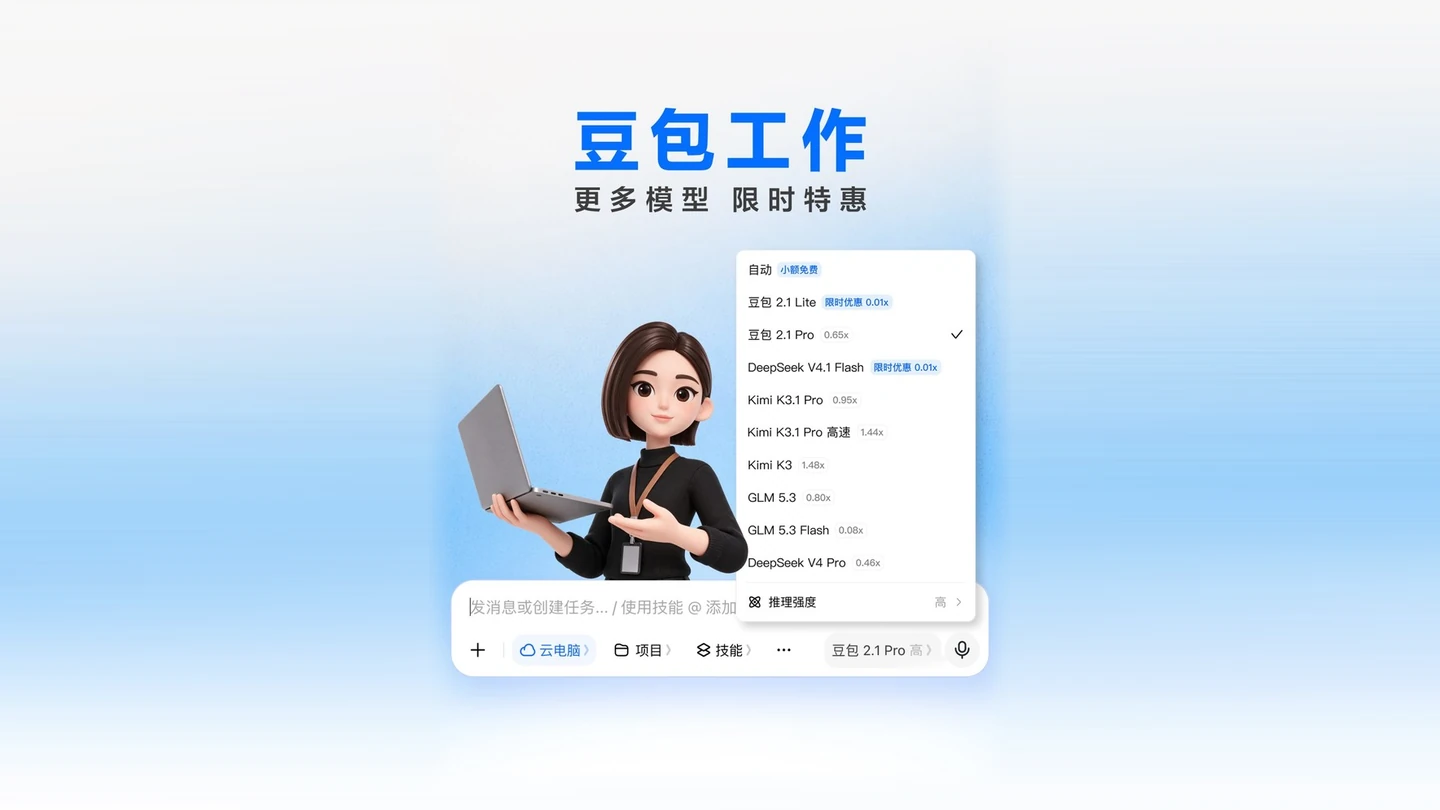
那天,页面上多了一排数
豆包工作是豆包面向生产力场景的产品,8 月 25 日发布。四川网络广播电视台 11 月 12 日的报道写到,10 月 29 日先向团队版和企业版开放三款第三方模型,默认开启,企业不用另外向厂商采购,Token 按用量从已有 AI 点数里扣。
南方+ 11 月 12 日的报道里,同样的模型向所有用户开放,同时做三件事:模型选择页标注额度消耗倍率,倍率越低、完成同一任务消耗越少;对豆包 2.1 Lite 和 DeepSeek V4.1 Flash 推限时优惠,压到 0.01 倍;宣布指定时段另有分时段优惠。
11 月 16 日「工作台」上线,首批覆盖金融、医疗、教育、创意设计等 21 个专业场景;据 IT 之家报道,金融投研工作台可通过插件接万得、同花顺、国泰海通的数据。
第一财经 11 月 18 日的报道称,豆包官方公布成绩:日活跃用户突破 800 万,企业客户年度经常性收入突破 20 亿元。产品上线至今不到三个月。
为什么敢把成本摊在明面上
10 月 29 日那次开放针对团队版和企业版。企业采购 AI 办公工具本来就要回答:这笔钱花在哪个模型上。三家模型的 Token 都从企业已有的 AI 点数里扣,企业不用分别找 Kimi、智谱、DeepSeek 谈合同,采购复杂度揽到自己身上,成本差异留在自己账上。到 11 月 12 日向个人用户开放,处理方式变了:差异不再由平台吸收,而是标成倍率摆到页面上。
为什么是现在?三个前提同时到位。模型能力在同档位拉不开差距,选谁都能干完活,用户才开始在意花多少;第三方模型的调用成本本来就和自研不同,藏不住;免费额度加低倍率是拉新最直接的工具——0.01 倍就是拉新的价格,只是不叫价格。
倍率不是价格,是一本内部账
倍率不是价格,是产品内部的计量规则。
用户充的是额度,倍率决定同一件事扣多少额度。倍率低不等于单价低——额度怎么定价是另一套东西,官方没把两者放进同一张表。看到 0.01 倍,不能据此折算价格。
但它确实做成了一件事:把成本差异从后台问题变成前台选项。以前平台只有两条路——一口价,差异自己吸收,用户看不见;分档计价,用户按需选。前者省心但要持续补贴,后者不背成本,代价是把选型的活交给用户。豆包工作选了后者,还比一般分档更彻底:不只给档位,把倍率摊在页面上。
多数产品会藏起这类数字,豆包工作反过来赌用户愿意算。
倍率两端隔着什么
倍率高低差别很大。把它读成能力差距,那就读反了。
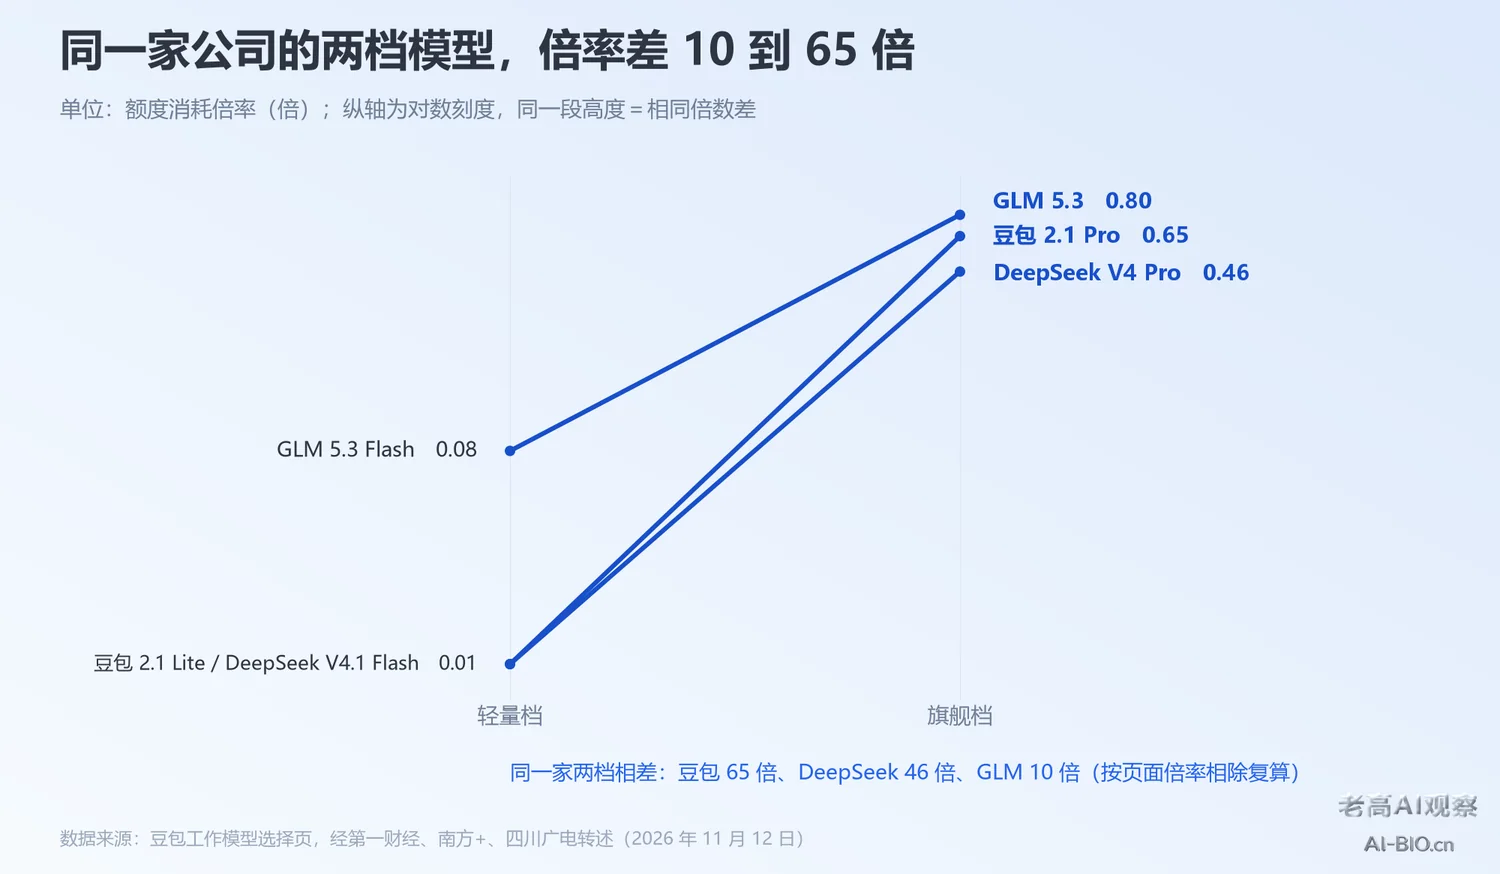
先看同门对比。GLM 5.3 是 0.80 倍,GLM 5.3 Flash 是 0.08 倍,同一厂商两个档位差 10 倍。Flash 指更轻更便宜的版本,能力上让出一部分——倍率里至少有一部分,对应「你用不用得上那份能力」。
再看跨门。DeepSeek V4 Pro 是 0.46 倍,GLM 5.3 是 0.80 倍,两家旗舰差近一倍。这是成本差异还是定价策略,官方没说,我也无法验证。
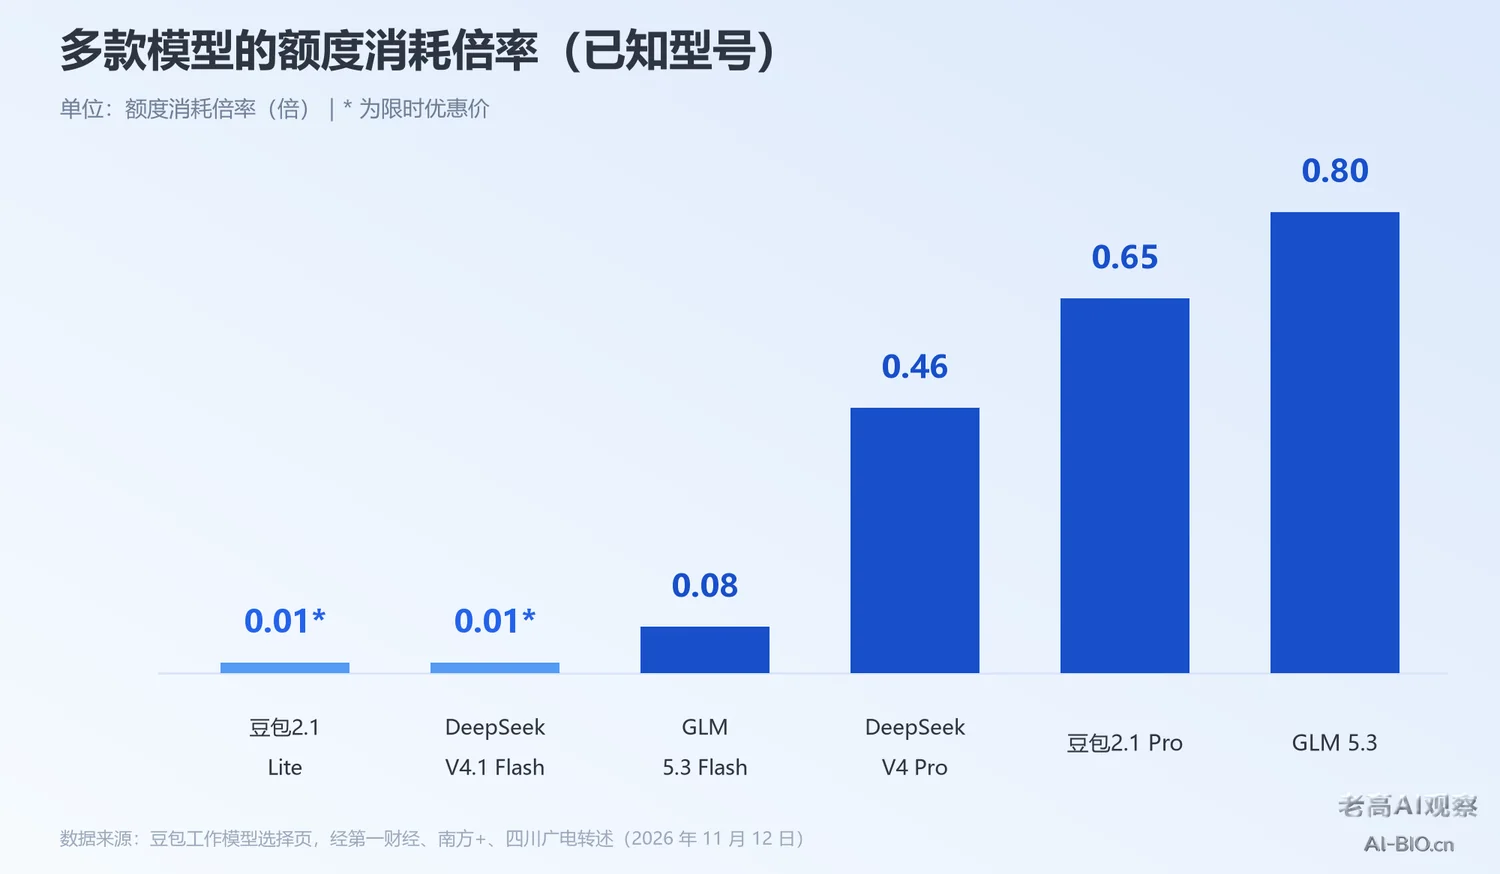
问题出在这儿:倍率把选模型变成一道算术题,但题目缺了分子。用户知道分母(花多少额度),不知道分子(干得好不好)。倍率越低越省,不等于倍率越低越合适。
现实解法不是算,是试:拿最常做的事,在两个模型上各跑一遍,看结果和额度差多少。
两拨人的感受不一样
普通用户这一层影响分档。一周用两三次、一句话能答完的几乎无感——这类落在免费和 0.01 倍这档。每天要用、改长文档、跑表格的人,才开始面对选择:同一份活,0.01 倍的模型可能要多改两遍,0.80 倍的模型可能一遍过。省下的额度,可能是用返工换的。
做 AI 工具生意的人这一层变化更实。一个入口接入四家模型,用户不必为了用 Kimi 离开豆包工作——模型从「目的地」变成货架商品。入口越合并,单个模型的名气越不值钱。反过来,会挑模型、会算额度、能说清「这个活该用哪个」的人和服务在升值。
这个逻辑不只发生在豆包工作身上。前几期写过两件事:豆包高峰限流,免费用户要排队;双11卖Token,额度被摆上货架。排队、卖额度、标倍率是同一条线——额度正从赠品变成计价单位,这条线在老高AI观察归档页里能顺着看。
有几个数,我暂时没法验
800 万日活和 20 亿元 ARR 都是官方自报,没有第三方监测背书。官方没说 800 万里个人和企业各占多少,也没公布客单价。同一周腾讯财报电话会报了 WorkBuddy 日活过千万,统计节点不同,不能直接比。
上述倍率取自媒体报道的页面信息。倍率若调整,数字就过期了。
倍率和实际花费还隔一层:额度怎么定价、免费额度给多少、超出怎么算,都没公布。看到倍率就换算成人民币,很容易算错。
现在就能做的三件事
一是把活分档。把最近一周用 AI 做的事写成三列:一句话能答完的、要改两三遍的、要读长文档或跑数据的。真正要挑模型的只有后两列。
二是轻活直接用最低倍率,重活别只看倍率。重活的成本不在额度,在返工——一次跑错,时间和额度都白花。重活上省下的倍率,常常赔在第二遍。
三是别急着买大包。先用免费额度和限时优惠把常做的三件事各跑两遍,记下每次扣多少额度、要改几次。一周后你对消耗的判断,会比任何评测都准。
想看同类工具有哪些,站内收过办公小浣熊这类产品;想弄清 GLM 从哪来,智谱的 Z.ai是官方入口。
想核对倍率,站内收过豆包工作的资料页。

判断就落在这儿
平台把选择权还给你,同时也把选错的代价还给你。以前这个代价藏在平台的定价里,现在它写在页面上。
关于豆包工作多模型,被问最多的三点
额度消耗倍率等于价格吗?
不等于。它是内部计量单位,决定同一任务扣多少额度;额度怎么定价是另一套规则,两者没有公开换算表。
倍率越低的模型,是不是能力越差?
不能这么推。Flash 档位确实让出一部分能力,但跨厂商的倍率差更多反映调用成本,官方未公布两者对应关系。
用第三方模型,需要另外向模型厂商付费吗?
不需要。企业版开放时明确无需另行向厂商采购,Token 按用量从企业账户已有的 AI 点数中扣。
依据与出处
- 《豆包工作日活突破800万,企业客户ARR突破20亿元》(第一财经,2026 年 11 月 18 日):800 万日活、20 亿元企业 ARR,8 月 25 日发布,已标注倍率。
- 《豆包工作接入更多模型,同步更新显示不同模型额度消耗倍率》(南方+,2026 年 11 月 12 日):接入三款第三方模型,倍率越低消耗越少,同步推限时特惠。
- 《豆包工作接入第三方模型,推限时额度优惠》(四川网络广播电视台,2026 年 11 月 12 日):各款模型的倍率数值,10 月 29 日企业版已开放,Token 从 AI 点数扣。
👉 我是老高,AI工具箱站长。这里记录 AI 工具的更新与实测——加入AI工具箱免费社群;微信公众号「老高的AI研究室」。
相关文章


 浙公网安备33010202004812号