
Gemini 4 Neon 是 谷歌 DeepMind 于 2026 年 11 月推出的 Gemini 4 家族均衡档模型,在 Carbon 的深度与 Hydrogen 的速度之间取中间位置:思考拆四档、上下文 100 万 token,Gemini API 标准价每百万 token 输入 3 美元、输出 15 美元,适用于长链路编码、企业知识工作与需要连续跑完的分析任务。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 兼顾深度与效率的 Gemini 4 均衡档 |
| 出品方 | 谷歌 DeepMind |
| 发布时间 | 2026 年 11 月 18 日 |
| 模型代码 | gemini-4-neon |
| 上下文窗口 | 100 万 token(输入、思考与输出共用) |
| 输出上限 | 默认 65,536 token;long decode 上限 1,048,576,须扣除已用输入 |
| 思考档位 | low、medium、high(默认)、xhigh |
| 输入类型 | 文本、图像、音频、视频、PDF、Office 文档 |
| 输出类型 | 文本(不支持图像、音频、视频生成) |
| 接入渠道 | Gemini API、AI Studio、Gemini 应用、Antigravity |
| 开源情况 | 闭源,未公开权重 |
Gemini 4 Neon 的核心能力
Gemini 4 Neon 的改动落在四处:多步任务的连续推进、四档思考配超长窗口、跨仓库的定向改动,以及一条独立的安全交付线。
把多步任务一次跑完
官方把它放在长链路智能体流程上:既能单独跑一个任务,也能在 Google Antigravity 里当调度者,把活儿拆给并行的 Gemini 4 Hydrogen 子智能体。为此做了三处收敛——减少重复读文件、边跑边汇报进度、长会话里压缩上下文。
四档思考配 100 万 token 统一窗口
思考分 low 到 xhigh 四档,默认 high,不同档位给出的推理预算不同,延迟与花销随之变化。上下文是 1,048,576 token 的统一额度,输入、思考与输出共用一个池子;同步调用默认 65,536 token,long decode 上限 1,048,576,实际额度要扣掉已占用的输入。
跨仓库的定向改动与长解码输出
它做的是定点改动:多文件调试与重构落在具体位置,不必整段重写。SWE-sweep 上,mini-SWE 框架里是 12.8%,换到 Antigravity 框架抬到 39.0%,同一个模型换个外壳差出三倍,说明这类活儿与工具链绑得紧。
安全线的漏洞发现、验证与修补
Gemini 4 Neon for Cyber 是另一条交付线:SEC-bench Pro 90.5%,ExploitGym 上用 Carbon 一半 token 达到同级,CWE-bench v2 70.7%、比 Carbon 高 3.4 个百分点,AutoBaxBench 困难档 76%。该版本不随普通接口放量,只给 Fairwind Program 受邀防御方。
Gemini 4 Neon 与同门三款的对比
下表把 Gemini 4 家族四款并排,从产品定位、思考档位与综合智能等维度做横向对照。
| 对比维度 | Gemini 4 Neon | Gemini 4 Carbon | Gemini 4 Argon | Gemini 4 Hydrogen |
|---|---|---|---|---|
| 产品定位 | 兼顾深度与效率的均衡档 | 最难的长周期项目 | 复杂软件工程与知识工作的前沿推理模型 | 快速日常执行的执行档 |
| 规格(窗口/输出/模态) | 100 万窗口/输出 65,536(long decode 1,048,576)/文本·图像·音频·视频·PDF | 100 万窗口/输出 65,536(long decode 1,048,576)/文本·图像·音频·视频·PDF | 100 万窗口/输出 65,536(long decode 1,048,576)/文本·图像·音频·视频·PDF | 100 万窗口/输出 65,536(long decode 1,048,576)/文本·图像·音频·视频·PDF |
| 思考档位 | low、medium、high(默认)、xhigh 四档 | low、medium、high 三档 | low、medium、high 三档 | low、medium、high(默认)、xhigh 四档 |
| 综合智能(Vals Index v2.2) | 70.9% | 70.4% | 69.2% | 未公布 |
| 编码(Terminal-Bench) | 65.2%(4.1 版) | 65.2%(4.0 版) | 57.1%(4.0 版) | 57.0%(4.1 版) |
| 智能体执行(Agents’ Last Exam v1.1) | 75.8% | 77.4% | 69.0% | 71.6% |
| 图表与文档理解(Chartography) | 73.5% | 72.5% | 71.6% | 66.6% |
| 输入价格 | 每百万 3 美元 | 每百万 2 美元,12 月 1 日起 4 美元 | 每百万 2 美元,12 月 1 日起 4 美元 | 每百万 1.50 美元 |
| 输出价格 | 每百万 15 美元,含思考 token | 每百万 10 美元,12 月 1 日起 20 美元 | 每百万 10 美元,12 月 1 日起 20 美元 | 每百万 7.50 美元,含思考 token |
| 免费档 | 不开放 | 不开放 | 不开放 | 可调用 |
- 表格内数据来源:规格与思考档位取 Gemini API 模型规格页,四款同源;其余基准取谷歌 DeepMind 官方模型页的分型号评测表,Gemini 4 Neon、Gemini 4 Carbon、Gemini 4 Argon 与 Gemini 4 Hydrogen 各对应一个页签;Hydrogen 未在该页公布综合智能成绩,标注为未公布。
- 产品对比简述:Gemini 4 Neon 的综合智能 70.9% 与图表理解 73.5% 高于 Gemini 4 Carbon 的 70.4% 与 72.5%,编码与智能体执行两项则略低于 Carbon;与 Gemini 4 Hydrogen 相比,Neon 在三项可比的基准上全部领先,输入价格也从 1.50 美元抬到 3 美元。
同家族上一款在站内有完整记录:Carbon 把重心压在网络安全与连续数天的长程任务上,是 Gemini 4 的旗舰档。
Gemini 4 Neon 的应用场景与适用人群
需要把长链路任务整段交出去的环节,四类最直接:
- 高频复杂编码:多文件调试、跨仓库重构与回归验证,改动定点落地。
- 企业知识工作:表格、PDF 与 Office 文档投进 100 万 token 窗口。
- 分析与科学计算:按难度抬思考档,最高档留给最难的推导。
- 安全防护:漏洞发现、验证与补丁生成串起来,接在 Fairwind Program 授权环境。
适用人群:适合把编码、分析与知识工作批量交给模型执行的技术团队和知识工作者;只要单轮问答或短文本改写,用 Hydrogen 更省。
Gemini 4 Neon 的使用方法
官方给出的 3 条路径按入口区分:①开发者经 Gemini API 接入,②在 AI Studio 网页端试跑,③在 Gemini 手机 App 里切换模型。
经 Gemini API 接入
- 在 Gemini API 模型规格页确认模型代码
gemini-4-neon,按付费层申请密钥。 - 先用同一段提示词跑 high 档,记下耗时与 token 消耗。
- 要长输出时走 long decode:同步默认 65,536 token,抬到 1,048,576 须扣掉已用输入。
- 批量与低优先级任务走 Batch 或 Flex,单价是标准价一半;也能在 Android Studio 选到该型号,企业走 Gemini for business 的 API 或模型菜单。
在 AI Studio 网页端试跑
- 打开 Google AI Studio,模型选择器里切到 Gemini 4 Neon,用 Pro 或 Ultra 订阅账号登录,或走 API 付费层。
- 把表格、PDF 或截图拖进对话,先跑一轮看输出结构。
- 要并行多步子任务时,转到 Google Antigravity 接同一模型,让它当调度者、Hydrogen 当执行者。
在 Gemini 手机 App 里切换
- 确认账号是 Google AI Pro 或 Ultra 订阅。
- 在 Gemini 应用的模型下拉菜单选到 Gemini 4 Neon。
- 把账单、截图与长文档传进去,让它转成报告。
两点记下:免费档不开放,所有 token 都计费,思考 token 与接地工具的系统指令一并算在内;Gemini 4 Neon for Cyber 另走 Fairwind Program 受邀名单,不在上面三条公开路径里。
Gemini 4 Neon 的项目地址
- Gemini 官方模型页:https://deepmind.google/models/gemini/
- Gemini API 模型规格(gemini-4-neon):https://ai.google.dev/gemini-api/docs/models/gemini-4-neon
- 官方发布公告(Google 博客,2026 年 11 月 18 日):https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon/
Gemini 4 Neon 的价格与开源情况
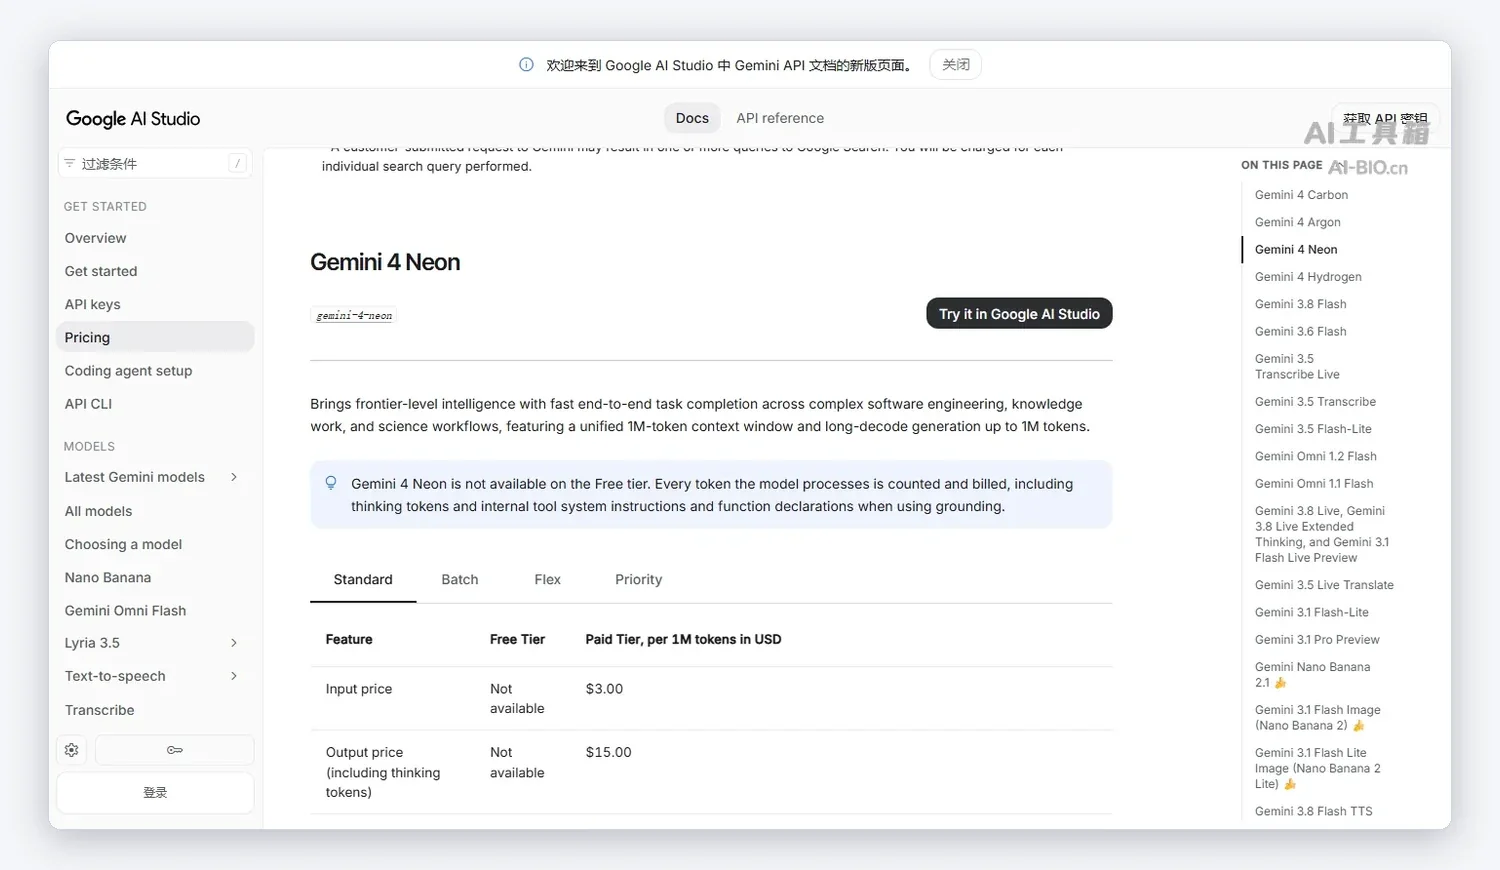
它按每百万 token 付费,分标准、批处理、Flex 与 Priority 四条计价通道,免费档不开放。
- 标准价:输入 3 美元、输出 15 美元(每百万 token,含思考 token)。
- 缓存 0.15 美元(仅隐式);Batch 与 Flex 1.50/7.50;Priority 5.40/27.00。
- 搜索接地:每月 5,000 次免费(Gemini 3 及以后共用),超出每 1,000 次 14 美元。
- 免费档:Neon 不在免费档,全部按量计费。
开源情况:闭源商用模型,未公开权重,也无本地部署方案,只能经 Gemini API、AI Studio、Gemini 应用与 Antigravity 在线调用。
Gemini 4 Neon 的常见问题
免费额度能用吗
不能。官方写明 Neon 不在免费档,所有 token 都计费,包括思考 token 与接地工具指令。
四档思考怎么选
low 到 high 覆盖多数请求,默认 high;xhigh 留给最难的多步推理。官方称 high 档单任务成本比 Carbon 低 32%。
和 Carbon、Hydrogen 怎么分工
Carbon 接最难的长周期项目,Hydrogen 管日常执行,Neon 落在中间,做要前沿推理又要控成本的任务。
100 万 token 是所有输出都能到吗
不是。输入、思考与输出共用一个池子,同步默认最多 65,536 token,long decode 才往上放,且要扣掉已用输入。
开源吗,能自己部署吗
不开源。未公开权重,只能经 Gemini API 与各订阅渠道在线调用。
相关文章


 浙公网安备33010202004812号