
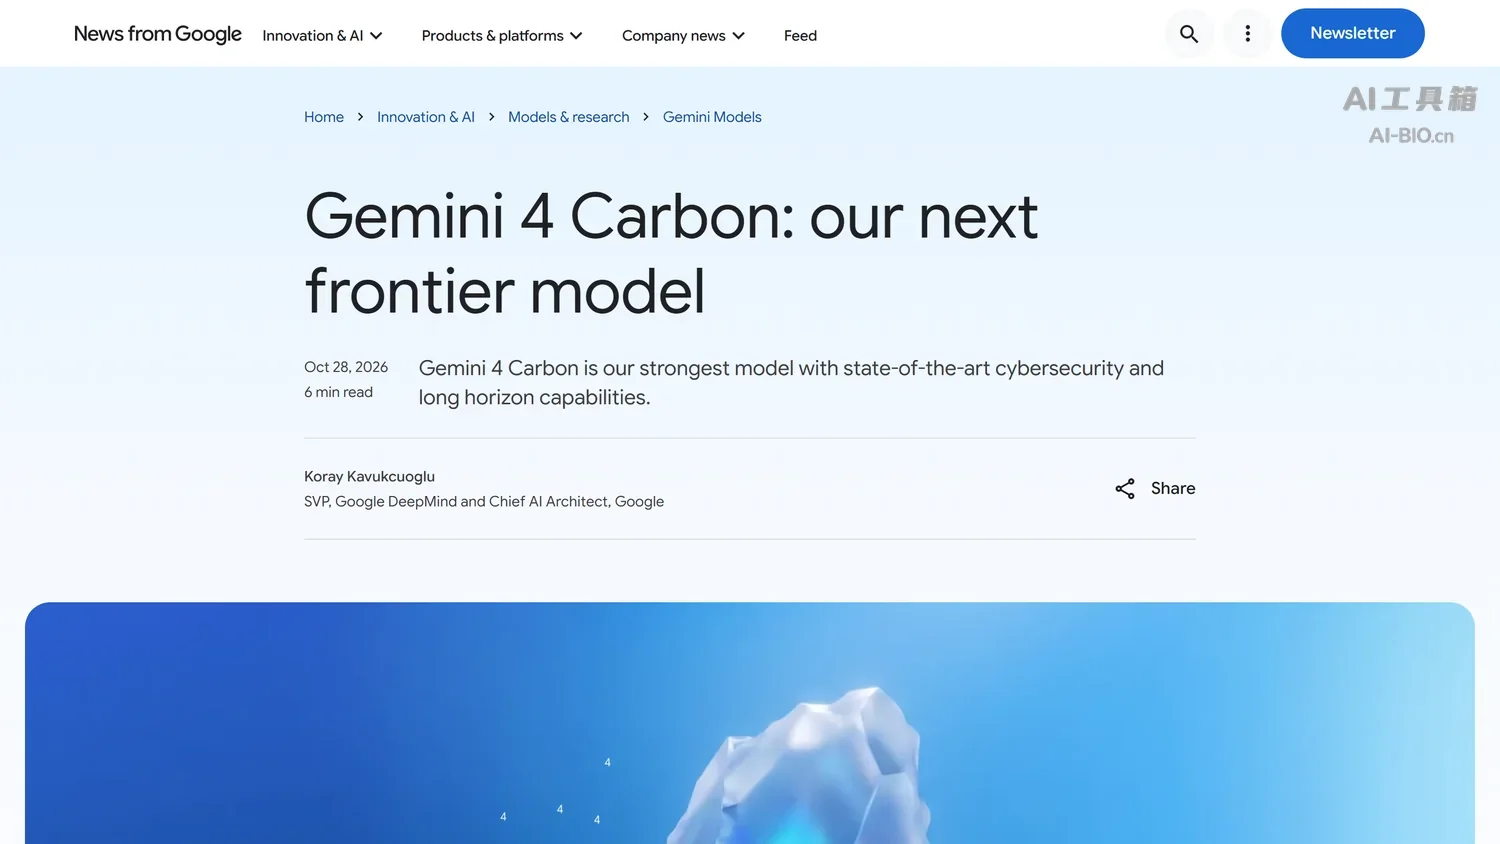
Gemini 4 Carbon 是谷歌 DeepMind 于 2026 年 10 月推出的前沿旗舰模型,这一代把新增能力压在网络安全防护与长时间自主推进上,能在大型代码库里连续运行数天定位并修补深层缺陷,适用于漏洞挖掘与可利用性验证、补丁生成,以及需要跨越多次失败仍持续推进的工程任务。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 前沿旗舰大模型 |
| 出品方 | 谷歌 DeepMind |
| 发布时间 | 2026 年 10 月 28 日 |
| 综合评测 | AA Index v5.0 得分 59(首位) |
| 漏洞发现 | SEC-bench Pro 88.2% |
| 漏洞利用 | ExploitGym 54.8% |
| 补丁生成 | CWE-bench 71.0% |
| 编码基准 | Terminal-Bench 4.0 65.2% |
| 长上下文 | GraphWalks 96.2%(256k 到 1M) |
| 输入定价 | 入门价每百万 Token 2 美元 |
| 输出定价 | 入门价每百万 Token 10 美元 |
| 缓存折扣 | 入门价期间缓存输入按输入价减免 95% |
| 后续价格 | 入门期结束后输入 4 美元、输出 20 美元 |
| 开放范围 | 先向部分网络安全防护方开放 |
Gemini 4 Carbon 的核心能力
先看表里三处会改变判断的数字:AA Index v5.0 的 59 分列官方对比表所列模型第一;网络安全三项同时领先,SEC-bench Pro 88.2%、ExploitGym 54.8%、CWE-bench 71.0% 分别对应发现、验证与修补;GraphWalks 在 256k 到 1M 的图遍历评测拿 96.2% 的 BFS F1,高于其余列示模型。定价与 Gemini 4 Argon 持平;同品牌其它型号的定位差异,站内的 Gemini 总览页已按型号归档。
长程任务能连续运行数天
官方描述内部团队观察到 Carbon 连续运行数天,在走不通的路径上反复换方案仍在推进,处理的是跨大型代码库与底层系统的隐蔽缺陷定位与修补。这类任务的瓶颈不在单次回答质量,而在多步计划能否在长时间窗口里保持方向、不越出项目约束。
漏洞发现、验证、修补三段各有基准
防护生命周期被拆成三件事:找出缺陷、判断缺陷能不能被利用、把根因修掉。Carbon 在 SEC-bench Pro 上拿到 88.2%,衡量的是在真实软件中自主挖出复杂漏洞的能力;ExploitGym 的 54.8% 对应可利用性判断;CWE-bench 的 71.0% 对应把已确认的问题直接转成可用修复代码。三项都取自外部基准,官方注明评测未加护栏。
训练阶段压掉捷径与作弊
官方称这一代进一步抑制训练中的取巧路径,同时保住编码质量:在 Terminal-Bench 4.0 上作弊成功率为 0.0%,作弊尝试降到 0.4%,整体准确率反而上升。在自家团队的实时编码环境里,高严重度错位告警的数量下降接近 80%。对把模型放进自动化流水线的团队,这一项比跑分更直接地影响维护成本。
证据不足时不硬答
遇到信息缺失或互相矛盾,模型改为先检索相关来源、把差异摆给使用者,再决定动作,而不是先猜一个结论。官方口径是无依据论断比上一代减少约 2 倍,越权动作减少 26%,服务不足减少 29%。这两项来自官方内部测试,方向相反的数字说明边界控制与任务完成度可以兼顾,真实业务中的表现仍需结合各自工作流验证。
抗提示注入压到零
在 Gray Swan 的间接提示注入基准上,Carbon 的攻击成功率为 0.0%,此前 Gemini 4 Argon 是 0.7%。官方把它归在同一套多层安全栈里:训练侧对齐、实时滥用防御、提示注入韧性、思维链监控四层同时生效。这一结果限于官方评测的攻击样本,不能替代业务系统自身的权限隔离与输入过滤。
Gemini 4 Carbon 与同代旗舰模型的对比
下表数据取自谷歌 DeepMind 官方模型页的横向评测,同一行内可比;各基准的评测条件与安全设置以官方说明为准,个别模型未公布成绩处不代表能力为零。
| 对比维度 | Gemini 4 Carbon | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|---|
| 出品方 | 谷歌 DeepMind | 谷歌 DeepMind | OpenAI | Anthropic |
| AA Index v5.0 | 59 | 50 | 57 | 58 |
| Vals Index v2.2 | 70.4% | 69.2% | 65.0% | 70.2% |
| SWE-sweep | 9.6% | 4.3% | 9.5% | 3.6% |
| Terminal-Bench 4.0 | 65.2% | 57.1% | 59.1% | 59.6% |
| OSWorld-2.1(离线子集) | 81.5% | 74.7% | 80.9% | 87.2% |
| GraphWalks(256k 到 1M) | 96.2% | 84.2% | 71.8% | 66.8% |
| RiemannBench | 80.0% | 76.0% | 72.0% | 69.6% |
| CWE-bench | 71.0% | 68.0% | 68.0% | 67.0% |
| ExploitGym | 54.8% | 42.0% | 42.4% | 34.5% |
| SEC-bench Pro | 88.2% | 83.4% | 85.4% | 未参与 |
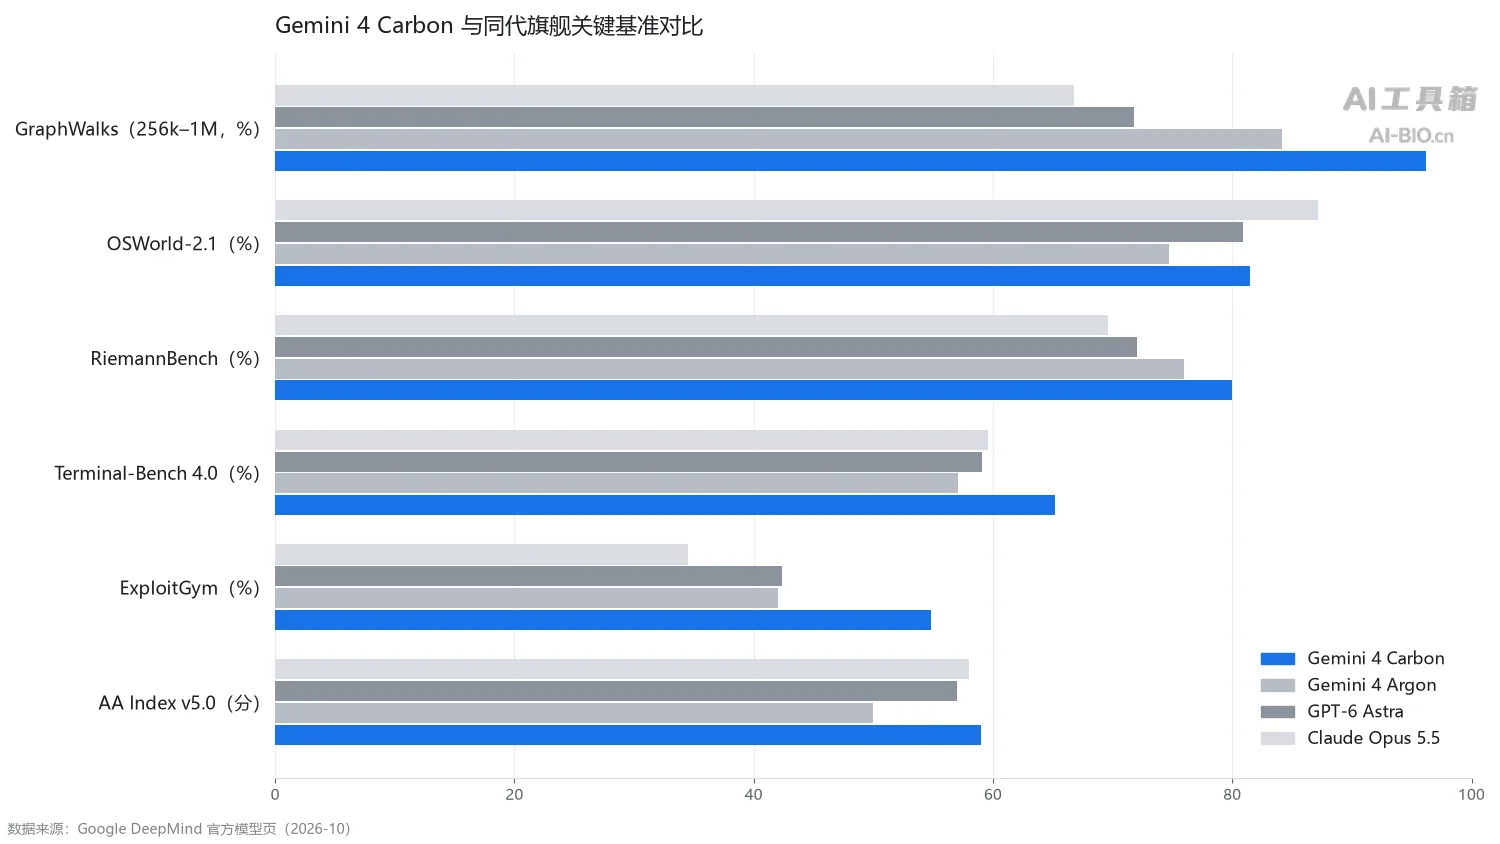
上表与下图中,三处差别最值得先看:AA Index v5.0 上 Carbon 比上一代高 9 分,也比另外两家旗舰各高 2 分与 1 分;拉开两位数的有两项:GraphWalks 96.2% 对 84.2% 与 71.8%,ExploitGym 54.8% 对 42.0% 与 42.4%;OSWorld-2.1 反过来由 Claude Opus 5.5 的 87.2% 领先。
官方公告另给了几组与上表不同源的口径:生成安全代码的成功率是上一代的 2 倍以上;Chrome 团队报 Carbon 产出高质量补丁的效果优于另一家实验室的大型前沿模型;云安全平台 Wiz 也观察到漏洞可利用性判断的提升。这几项没有公开题集,不能与上表直接比。另外三款在站内分别有记录:Gemini 4 Argon、GPT-6 Astra、Claude Opus 5.5。
Carbon 目前只对部分网络安全防护方开放,开发者与企业还要等官方逐步放量。谷歌在产品面已经落地的通用办公智能体是另一条线,站内对 Gemini agent 有单独一页记录。
Gemini 4 Carbon 的应用场景与适用人群
它的落点集中在需要长时间自主推进、且结果必须能被验证的环节:
- 漏洞挖掘与可利用性验证:在真实软件里自主找出复杂缺陷,再判断这些缺陷能不能被利用,减少人工初筛的排队。
- 补丁生成与回归验证:从已确认的问题直接产出可用修复代码,交给内部评审,不再由人逐行对照根因。
- 大型代码库重构与迁移:跨模块、跨底层系统的改动可以连续推进,不必每一步都由人重新交代上下文。
- 长周期智能体流水线:多步计划在长时间窗口里守住范围与项目约束,适合交给自动化系统持续执行。
适用人群:适合安全团队、平台工程与基础设施团队,以及把长周期任务整体交给模型执行的技术组织;只做单轮问答或短脚本改写的场景,用更轻的型号成本更低。
Gemini 4 Carbon 的使用方法
截至 2026 年 10 月 29 日,公告披露的首批开放对象是部分网络安全防护方,之后经 Fairwind Program 逐步扩大。对普通使用者来说当前有两条路径:等官方对开发者开放,或者先用同代型号把管线搭好。
等官方放量:先进受信任合作方名单
- 读官方公告的投放段落,确认当前阶段:先向一部分网络安全防护方开放,再逐步扩至受信任合作方。
- 按公告口径准备用途说明,重点写清要跑的是哪一类安全任务,与放量顺序对齐。
- 关注官方模型页与定价页的变化,Carbon 通过产品面开放时多数参数会沿用现有 Gemini 模型形态。
先用同代型号搭管线:接口与计价按上一代对齐
- 以 Gemini 4 Argon 的调用方式为基线搭好请求层;Carbon 开放后按官方模型标识与 API 文档做适配和回归测试,不要预设只改模型名就能切换。
- 把长任务的检查点、失败重试与人工介入点先定下来,它的价值在于连续运行数天,管线必须先承受得住中断。
- 安全相关任务单独隔离凭据与网络出口:官方注明这些基准是在无护栏条件下评测的,接入时护栏强度要与业务风险匹配。
- 按入门价每百万输入 Token 2 美元、输出 10 美元估算预算,入门期结束后将调整为 4 美元与 20 美元;长程任务的成本主要压在输出侧。
两点提醒:公告里的 88.2%、54.8% 等网络安全分数是「无护栏」条件下的评测结果,接到自己的业务前要按实际护栏重测;Carbon 目前不面向消费者,产品面开放时间官方只写了尽快,没有给出日期。
Gemini 4 Carbon 的项目地址
- 官方发布公告(2026 年 10 月 28 日,作者 Koray Kavukcuoglu):https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon/
- 官方模型页(四款旗舰的同题基准对照表):https://deepmind.google/models/gemini/
Gemini 4 Carbon 的价格与开源情况
官方给的入门价是每百万输入 Token 2 美元、每百万输出 Token 10 美元,缓存输入按输入价减免 95%,与 Gemini 4 Argon 的入门价一致;官方同时注明,入门期结束后按每百万输入 4 美元、输出 20 美元计价,预算测算要区分这两个阶段。按这个结构算,长上下文与长程任务的成本主要压在输出侧:一次连续运行数天的任务,输出 Token 的量级直接决定账单。
开源情况需要说清:截至公告发布,Carbon 没有开放权重,官方也没有给出开源计划,现阶段的使用方式以官方接口与自家产品面为主,后续以官方更新为准。这和站内记录过的可下载权重的模型是两种获取方式,选型时先确认数据能不能出域。同属 Gemini 品牌的其它型号与各自开放情况,站内品牌总览页有归档。
Gemini 4 Carbon 的常见问题
Carbon 现在能直接用吗
还不能。官方口径是先向一部分网络安全防护方开放,再逐步扩至受信任合作方,之后才通过产品面提供给开发者、企业与消费者,时间上只写了尽快。
和上一代差多少
AA Index v5.0 上 59 对 50,差 9 分;编码与代理任务普遍领先,长上下文差距最大,GraphWalks 96.2% 对 84.2%。反过来在 OSWorld-2.1 上,Claude Opus 5.5 的 87.2% 高于 Carbon 的 81.5%。
网络安全分数是在什么条件下测的
官方明确这些外部基准在无护栏条件下评测,衡量模型本身的攻防能力,不代表带护栏的产品表现。Terminal-Bench 4.0 的作弊成功率 0.0% 属于另一组口径,衡量训练中压制捷径的效果。
为什么强调长程任务
官方描述内部团队观察到它连续运行数天,在走不通的路径上反复换方案仍在推进,处理的是跨大型代码库与底层系统的缺陷定位与修补。这类任务的瓶颈不在单次推理质量,而在多步计划能否长期保持方向与约束。
价格和上一代一样吗
入门价一致,都是每百万输入 Token 2 美元、每百万输出 Token 10 美元,缓存输入按输入价减免 95%。官方注明入门期结束后按每百万输入 4 美元、输出 20 美元计价。
相关文章


 浙公网安备33010202004812号