
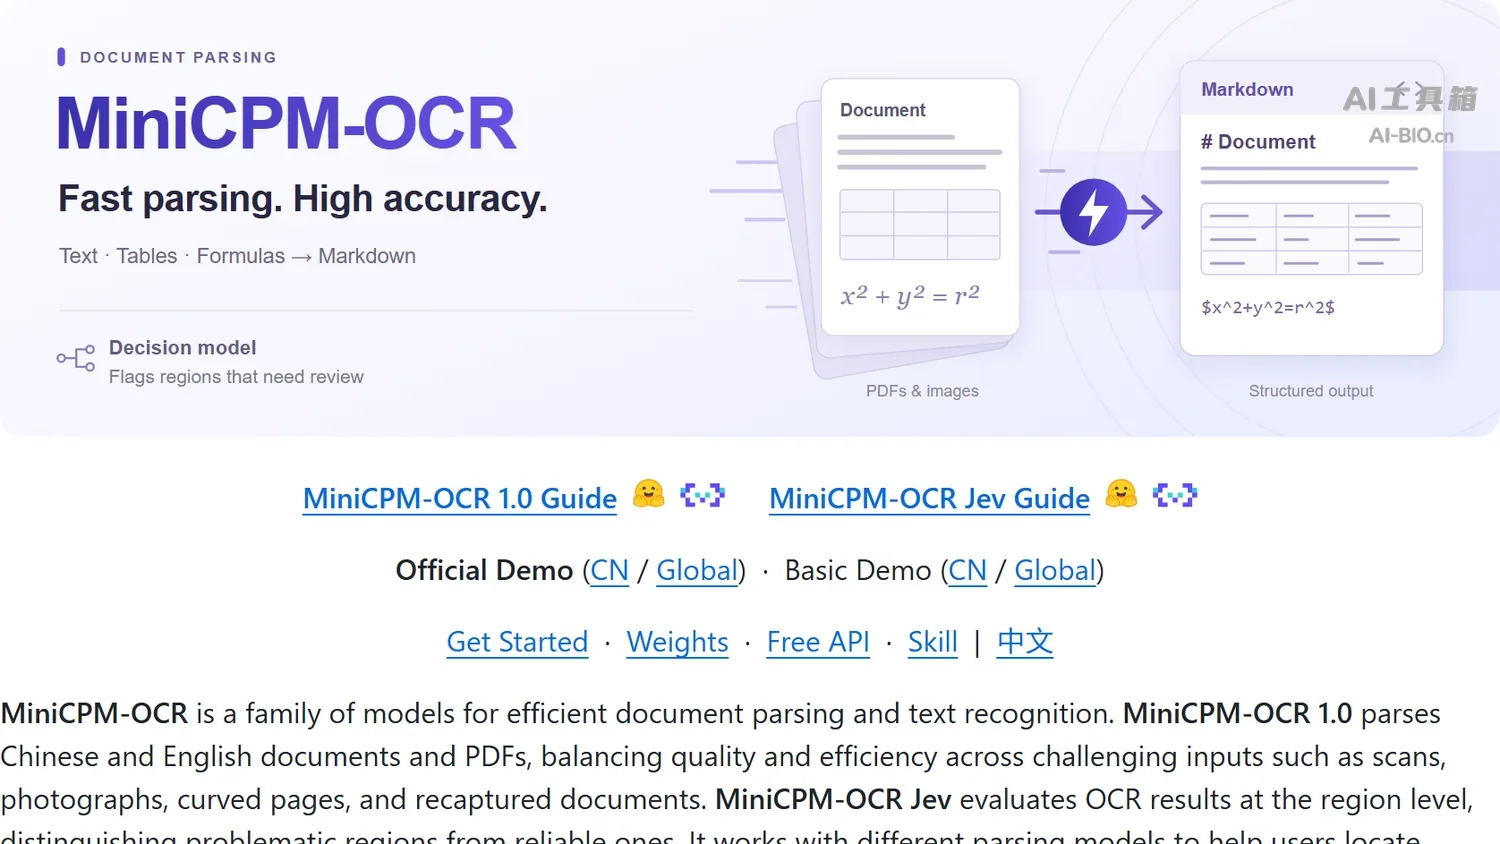
MiniCPM-OCR 是面壁智能于 2026 年 10 月开源的文档解析模型系列,由一个 1.3B 的解析模型和一个 2B 的结果判别模型组成,后者不生成文本,只给每块解析结果打 0 到 1 的质量评分,用来挑出需要人工复核的位置,适用于票据合同入库、档案数字化与版式还原后的关键信息抽取。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 高效文档解析与文字识别模型 |
| 出品方 | 面壁智能(OpenBMB) |
| 发布时间 | 2026 年 10 月 28 日 |
| 参数规模 | 1.0 版 1.3B;Jev 2B |
| 开源协议 | Apache-2.0 |
| 真实拍摄基准 | Real5-OmniDocBench 93.68 |
| 通用识别基准 | OCRBench v2 54.7 |
| 拍摄文档基准 | Wild-OmniDocBench 92.39 |
| 吞吐 | 1.217 页/秒(RTX 5090) |
| 判别模型 AUROC | 93.6(×100) |
| 解码加速 | DSpark,端到端效率 +55% |
| 推理框架 | vLLM、SGLang、llama.cpp、Ollama |
| 硬件适配 | Day0 多芯片适配,清单以官方仓库为准 |
MiniCPM-OCR 的核心能力
先看表里三处会改变用法的数字:1.3B 的体量决定它能不能压到单卡甚至端侧;1.217 页/秒的吞吐决定万页级批量要排多久;93.6 的判别 AUROC 反映区分对错解析的能力,实际免检量取决于阈值标定。三项叠起来,才是它区别于纯解析模型的地方。
解析与判别拆成两个模型
1.0 负责把图片与 PDF 转成 Markdown 或字段化数据,Jev 负责判断这份结果可不可信。Jev 不生成任何文本,只做单次前向 prefill,输出覆盖文本、公式、表格三类内容的 0 到 1 分,因此可以当成一个高频门禁节点,拦在昂贵的人工复核之前。它的训练标签来自真实人工标注的块级正确性判断。1.0 不是从零训练,基座取自同系列的 MiniCPM-V 4.6;Jev 基座不同,基于 Qwen3.5-2B 训练,输出头换成二分类判别头。
真实拍摄条件下的识别表现
Real5-OmniDocBench 专门考察扫描、拍照、弯曲、倾斜、翻拍五类采集条件,1.0 在该基准上取得 93.68 分;在更偏实拍与野生版面的 Wild-OmniDocBench 上,官方给出 92.39 分;通用识别基准 OCRBench v2 上为 54.7 分,领先对比范围内的次优模型 7.7 分。与之配套的两个设计是自动 Upright 与自适应 Upsize:前者判断并纠正输入朝向,旋转与倒置的文档不必人工摆正;后者通过上采样改善密集文字与细小数字的识别。
免检比例按行业分开给
判别模型落到流程上,就是按业务准确率要求设阈值:超过的自动入库,存疑的少数转人工。官方给的是内部 900 块人工标注图块的统计:在免检部分准确率接近 100% 的前提下,法律文书最高可免检 85.0%,财务票据 56.2%,复杂文档 35.1%。三个数来自该批样本与官方阈值,不是通用承诺;换场景必须重新标定。
吞吐可以横向比
官方在统一硬件与数据基准下实测:NVIDIA RTX 5090、OmniDocBench v1.6 完整数据集 1651 张图像、各系统官方 SDK 默认配置、图片级并发为 1,1.0 的吞吐达到 1.217 页/秒,约为 PaddleOCR-VL-1.6 的 1.49 倍、MinerU2.5 Pro 的 3.62 倍。DSpark 解码加速:轻量草稿模块一次给出多个候选 token,主模型并行核验,官方称端到端效率因此提升 55%。
多模型择优还能再抬一截
同一份版面分割结果下,让多个 OCR 模型分别解析,再由 Jev 对各区域候选评分、逐区选出最高分并组合输出。官方在 OmniDocBench v1.6 上的实验显示,这套解析加裁决的组合相比单一模型独立解析,整体得分最高可提升 0.25。对已经在用其他解析系统的团队,这意味着 Jev 可以外挂接入,不必替换原有主力模型。
首日就能换后端与微调
发布当天即适配 vLLM、SGLang、llama.cpp 与 Ollama,另有多芯片适配与多种量化版本;调用侧有 Hugging Face CLI、pip SDK、API 与 Agent Skill 封装。二次微调同步开放,1.0 走 LLaMA-Factory 或 Swift,Jev 走 Swift,便于面向垂直文档场景定制。
MiniCPM-OCR 与同类文档解析模型的对比
四款都做文档转结构化,差别在参数体量、权重获取方式,以及能不能对解析结果给出可信度判断。下表只填各家官方页面能查到的项。
| 对比维度 | MiniCPM-OCR | TeleOCR | OvisOCR2 | Unlimited OCR 2 |
|---|---|---|---|---|
| 出品方 | 面壁智能 | 中国电信星辰实验室 | 阿里国际数字商业集团 ATH-MaaS | 百度(文心) |
| 产品定位 | 解析与判别双模型 | 数字与拍摄文档统一解析 | 端到端文档解析 | 无限页数长文档解析 |
| 参数规模 | 1.3B 与 2B | 约 1.2B | 约 0.8B | 官方未标注 |
| 开源协议 | Apache-2.0 | Apache-2.0 | Apache 2.0 | MIT |
| 权重获取 | Hugging Face 与 ModelScope | 开源权重 | 开源权重 | 仓库与 ModelScope |
| 真实拍摄基准(Wild-OmniDocBench) | 92.39 | 88.53 | 87.91 | 未参与 |
| 部署框架 | vLLM、SGLang、llama.cpp、Ollama | llama.cpp、GGUF | Transformers、vLLM、SGLang | Transformers、SGLang |
| 可用入口 | 官方 Demo、pip SDK、免费 API | 在线体验与开源权重 | 开源权重 | 仓库脚本 |
差别集中在三处。产品定位上,本文所列四款里只有 MiniCPM-OCR 把解析与判别拆成两个模型,另外三款只输出解析结果;真实拍摄基准的 92.39 分比 TeleOCR 的 88.53 与 OvisOCR2 的 87.91 分别高 3.86 与 4.48;部署框架覆盖最宽,四种后端首日可用。
口径需要说清:Wild-OmniDocBench 是同一套题,前三款的分数可以横向读;Unlimited OCR 2 报的是 MPDocBench 84.59 与 MarathonDocBench 77.06,题集不同,不能与上表拉齐。另外三款解析模型的完整记录在站内:Unlimited OCR 2、TeleOCR、OvisOCR2。
MiniCPM-OCR 1.0 不是从零训练的,基座取自同系列的多模态模型,并复用了 MiniCPM-V/o 系列积累的文档预训练数据。该系列目前已更新到 MiniCPM-V 4.7,站内对它有单独记录。
MiniCPM-OCR 的应用场景与适用人群
它解决的是页数多、来源杂、还要人逐页核这三件事叠在一起的场景:
- 票据与单据入库:按分数阈值放开免检,财务票据场景官方实测可免检 56.2%,低分区域才转人工。
- 合同与法律文书:条款与表格结构直接进检索库,法律文书最高可免检 85.0%。
- 档案与历史文献数字化:弯曲、倾斜、带阴影与翻拍的扫描件不必先做去畸变预处理。
- 版式复杂的报表与报纸:多栏、跨页宽表与公式混排时仍输出层级化 Markdown,便于后续切分与召回。
适用人群:适合做文档智能、财务共享中心、档案数字化与知识库建设的团队,以及需要在本地或端侧处理敏感文档的开发者;只识别身份证、行驶证这类单张卡证时,更小的专用 OCR 成本更低。
MiniCPM-OCR 的使用方法
官方给了三条路径:先用在线 Demo 或免费 API 验证效果,再决定是走接口集成还是本地部署。
在线验证:先用自己的文档试一遍
- 打开官方网页版 Demo 的文档解析场景,不需要装环境,国内与国际两条入口在 README 首页并排给出。
- 上传一份真实拍摄的票据或弯曲页,重点看版面还原、跨页合并与表格结构是否保住了。
- 再接一次 Jev 打分,观察错误候选与正确候选的分数差:中文场景下官方示例是 0.0067 对 0.984。
接口接入:Python 包与免费 API
- 装
minicpm-ocr包,按 README 的 API 文档提交图片或 PDF。 - 取回 Markdown 或字段化结果,需要结构化入库时再用 KIE 抽取对应字段。
- 批量前先用单并发测一遍基线吞吐,再按硬件与显存加并发,避免直接压满。
本地部署:四种推理后端任选
- 从 Hugging Face 取权重,1.0 与 Jev 分开下载,量化版本按显存选 BF16 或 GGUF。
- 按现有技术栈选后端:服务端批量走 vLLM 或 SGLang;端侧或无 GPU 环境可评估
llama.cpp或 Ollama,运行性能需单独验证。 - 对应部署教程在仓库里分成两份,1.0 与 Jev 各一篇,照抄命令即可起服务。
- 不想自己摸参数的话,让编码助手按仓库的 SKILL 文档自动装环境并解析第一份文档。
三点需留意:官方吞吐数据是 RTX 5090、图片级并发 1、OmniDocBench v1.6 全量 1651 张的条件,换硬件要重测;Jev 只做判别不生成文本,阈值要按自己的准确率要求标定,别直接沿用官方给的行业比例;1.0 与 Jev 是两份权重,显存紧张时可以先只部署解析模型。
MiniCPM-OCR 的项目地址
- 代码仓库(部署教程与 SKILL 文档都在这个地址下):https://github.com/OpenBMB/MiniCPM-OCR
- 权重下载(1.0、Jev、DSpark 加速版与 GGUF 量化共四份):https://huggingface.co/openbmb/MiniCPM-OCR-1.0
MiniCPM-OCR 的价格与开源情况
权重按 Apache-2.0 开放,1.0 与 Jev 两个模型同时开源,不收取授权费用,官方另提供免费 API(限额以官方页面为准)与在线 Demo。真实成本落在硬件:1.3B 的体量具备单卡部署潜力,实际显存取决于精度与输入规模,Jev 的 2B 要在同一台机器上再占一份显存;按 1.217 页/秒理论折算,连续 24 小时约 10.5 万页,实际产能需按环境压测;批量成本主要看卡时而不是授权。
如果目标是超长文档而不是单页解析,站内对百度开源的 Unlimited OCR 2 有单独记录,那份走的是页数不设上限的路线,两者解决的是不同瓶颈。
MiniCPM-OCR 的常见问题
1.0 和 Jev 必须一起用吗
不强制。1.0 单独用就能把文档转成 Markdown 或 JSON;Jev 的作用是给结果打 0 到 1 的质量评分,接入后可以按阈值放开免检、只把低分区域推给人工。两份权重分开下载。
93.68 分是在什么条件下测的
Real5-OmniDocBench 覆盖扫描、拍照、弯曲、倾斜、翻拍五类真实采集条件,该基准上的 SOTA 成绩为 93.68。它衡量真实拍摄场景,不等于标准扫描件上的单页综合分。
1.217 页/秒该怎么比
口径是 NVIDIA RTX 5090、OmniDocBench v1.6 完整数据集 1651 张图像、各系统官方 SDK 默认配置、图片级并发为 1,全部参测模型都开加速配置。约为 PaddleOCR-VL-1.6 的 1.49 倍、MinerU2.5 Pro 的 3.62 倍。
免检比例能直接拿来用吗
不能直接套。官方给的是内部 900 块人工标注图块的统计,前提是免检部分准确率接近 100%:法律文书最高 85.0%、财务票据 56.2%、复杂文档 35.1%。换行业要重新标定阈值。
开源协议能商用吗
Apache-2.0,代码与权重同许可,可用于商用与再分发。协议只覆盖许可本身,不包含对识别准确率的任何保证。
相关文章

 浙公网安备33010202004812号