
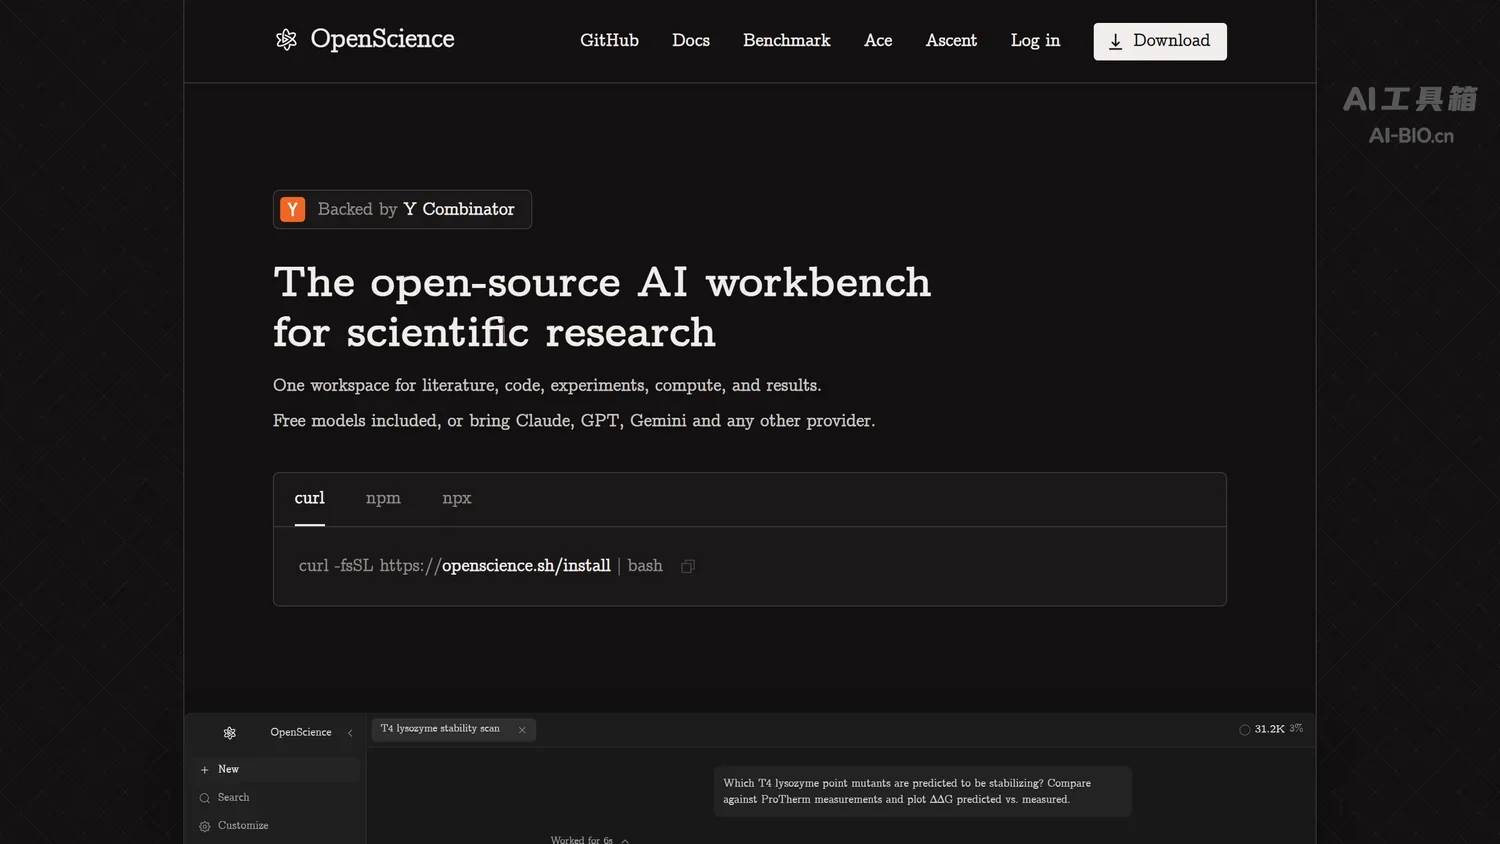
OpenScience 是一款由 Synthetic Sciences 于 2026 年 7 月开源的AI 科研工作台,主要用于把文献调研、代码编写、实验执行与结果整理串成一条可回看的链路,支持桌面端、浏览器与命令行三种形态,适用于文献综述整理、实验参数扫描与论文数据核对等场景。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 面向科研流程的 AI 工作台 |
| 出品方 | Synthetic Sciences |
| 发布时间 | 2026 年 7 月 3 日 |
| 开源协议 | Apache-2.0 |
| 开发语言 | TypeScript |
| 运行形态 | 桌面应用、浏览器工作区、命令行 |
| 执行环境 | Shell、Python 与 R 内核、Notebook |
| 文件权限 | 显式授权读写,可限定目录 |
| 数据连接 | PubMed、arXiv、ChEMBL、UniProt |
| 远程算力 | 可接自有远端机器 |
OpenScience 的核心能力
科研里真正耗时的部分不是那一个想法,而是取数、清洗、复现、扫参数这些细活。同类的 Claude Science 也做科研工作台,思路可以并着看。
三种形态共用一套工作区
桌面应用适合在本机文件上直接干活,浏览器工作区省掉装环境,命令行方便接进已有脚本。三者读写同一套工作区结构,换形态不必重新组织项目,实验记录也不会因为换端而断掉。
每步都留痕的执行过程
一个回合会被记成「想过什么、搜了什么、跑了什么、写了什么」,最后才给结论。跑过的命令与产物都能回看,出问题时能定位到具体一步,而不是只看到一个看起来合理的结论。
真实内核与文件授权
执行侧给的是真实的 Shell、Python 与 R 内核,以及 Notebook 环境,不是模拟执行。文件读写按显式授权放行,可以只放开项目目录,减少误删与越界读取的风险。
科研数据源连接
内置 PubMed、arXiv、ChEMBL、UniProt 等数据库连接器,检索文献与化合物、蛋白信息不必自己写爬虫。数据来源是官方库,引用时能追到条目,而不是转述二手摘要。
内置学科技能包
官方打包了覆盖生物学、化学、物理学、机器学习与数据工程的技能集,按学科调用。做法上更像给研究流程准备的模板库,具体到某个课题仍要自己写判定与验证逻辑。
子任务分派
主智能体可以把边界清楚的工作交出去,并行跑几段互不依赖的分析,再汇总结果。站内的 InternAgentS 是另一种科研智能体组织方式,可以对照两者在任务拆解上的差别。
OpenScience 与 Claude Science 的对比
两者都把文献、代码、计算与成稿收进同一个工作台,差别在开源可改还是订阅即用。下表按可核实的结构项并列。
| 对比维度 | OpenScience | Claude Science |
|---|---|---|
| 出品方 | Synthetic Sciences | Anthropic |
| 开源与授权 | Apache-2.0,代码与技能都能改 | 闭源客户端,目前为 beta |
| 模型选择 | 自带密钥、本地模型或托管服务 | Claude 系列 |
| 运行位置 | 自有基础设施,可接远端机器 | 本机、Linux 服务器或 HPC 登录节点 |
| 计算与内核 | Shell、Python 与 R 内核 | 持久 Python 与 R 内核,可经 SSH 提交作业 |
| 科学数据库 | PubMed、arXiv、ChEMBL、UniProt 等连接器 | 官方称可查询 60 余个科学数据库 |
| 扩展方式 | 数百个内置技能,可改可加 | 流水线可存为技能,或接连接器 |
| 成本 | 软件免费,模型调用费用自理 | 含在 Claude 订阅内,学术与非营利机构可免费开始 |
两者的差别集中在三处。开源与授权:OpenScience 以 Apache-2.0 发布,代码与技能都能改;Claude Science 是闭源客户端,目前仍是 beta。模型选择:前者可接自带密钥、本地模型或托管服务,后者限定在 Claude 系列。成本:前者软件本身免费,模型调用费用自理;后者含在 Claude 订阅内。
还有一点在落地时才会显现:开源形态省掉的是订阅与服务绑定,代价是模型账单和运行环境要自己管;订阅形态省掉的是配置与运维,代价是模型选择被限定。两条路并不互斥,经费允许时先用订阅版跑顺流程,再把固定下来的环节搬到自建环境,是常见的过渡方式。
如果目标是把核对过的材料写成长文,站内的 SciVolume(AI 写书工作台,引用文献真实可查)接着做的是后半段。
OpenScience 的应用场景与适用人群
这套工具的价值集中在「要反复取数与复现」的环节;查文献这一步还有更轻的做法,可参考 MedCite 的检索路径:
- 文献综述:按主题批量检索并整理来源,把引用条目留在记录里。
- 实验复现:把论文里的步骤拆成可执行脚本,逐步核对中间结果。
- 参数扫描:批量跑同一套流程的不同参数,结果汇总成一张对照表。
- 方法段落起草:先跑出数据与结论,再据此起草方法与结果部分。
- 数据核对:对照原始条目检查引用、单位与统计口径是否一致。
适用人群:适合需要长期做数据复现的研究生与课题组,以及要把分析流程固化成脚本的数据团队;只查一两篇文献、或不需要跑代码的场合,用现成的检索与阅读工具更快。
OpenScience 的使用方法
官方给了三条路:桌面应用、浏览器工作区、命令行,三种形态共用同一套工作区。安装与快速开始见 官方文档。
桌面应用:在本机文件上跑分析
- 从官网下载对应系统的安装包,首次启动后选定一个项目目录。
- 在设置里授权该目录的读写权限,确认工作区能列出已有数据文件。
- 用一句话描述任务,观察它拆出的步骤与要执行的命令。
- 在关键步骤前暂停,检查取数口径与统计方式,再让它继续。
浏览器工作区:免装环境先试一轮
- 按官网 Quickstart 进入工作区,先跑官方示例任务熟悉界面。
- 把要核对的材料上传或指向已有文件,确认能读到。
- 跑完后逐条回看执行记录,把可复用的步骤存成脚本。
命令行:接进自有算力与流水线
- 安装仓库发布的 npm 包,在项目目录初始化配置。
- 配置模型服务地址与密钥,以及远端机器的连接信息。
- 用命令触发一次任务,把输出目录纳入版本管理,便于比对不同参数的结果。
需要提前想清楚两件事:模型服务要自己准备,长任务会持续消耗调用额度;执行侧有真实 Shell 权限,授权目录之外的路径不要放开。文献阅读类任务可以先参考站内的 长文 PDF 拆读方法,把要问的问题准备得具体一些。
OpenScience 的项目地址
- 项目官网:https://openscience.sh
- GitHub 主仓库:https://github.com/synthetic-sciences/openscience
OpenScience 的价格方案
代码按 Apache-2.0 分发,安装与使用不收费,也没有订阅档位。商用与改造允许,保留许可与版权声明即可,改动部分不强制开源。
真实开销在模型与算力两侧:工作台的每次规划与代码生成都要调用模型,长任务按 token 累计;跑实验的机器可以是本机,也可以是自备远端算力,两种方式都不产生软件授权费用。
OpenScience 的常见问题
需要自己准备模型接口吗
需要。工作台只负责编排与执行,模型服务要按文档填入地址与密钥,本地部署的模型只要接口兼容也能接。
会不会动到项目之外的文件
默认按显式授权放行读写,只放开项目目录即可;执行侧有真实 Shell 权限,授权范围建议按最小必要来设。
和 Claude Science 有什么不同
Claude Science 是 Anthropic 的闭源科研客户端,模型限定在 Claude 系列;OpenScience 以 Apache-2.0 开源,代码和技能都能改,可接自带密钥、本地模型或托管服务。
支持哪些学科
内置技能覆盖生物学、化学、物理学、机器学习与数据工程,具体能力以文档里的技能清单为准。
相关文章


 浙公网安备33010202004812号