
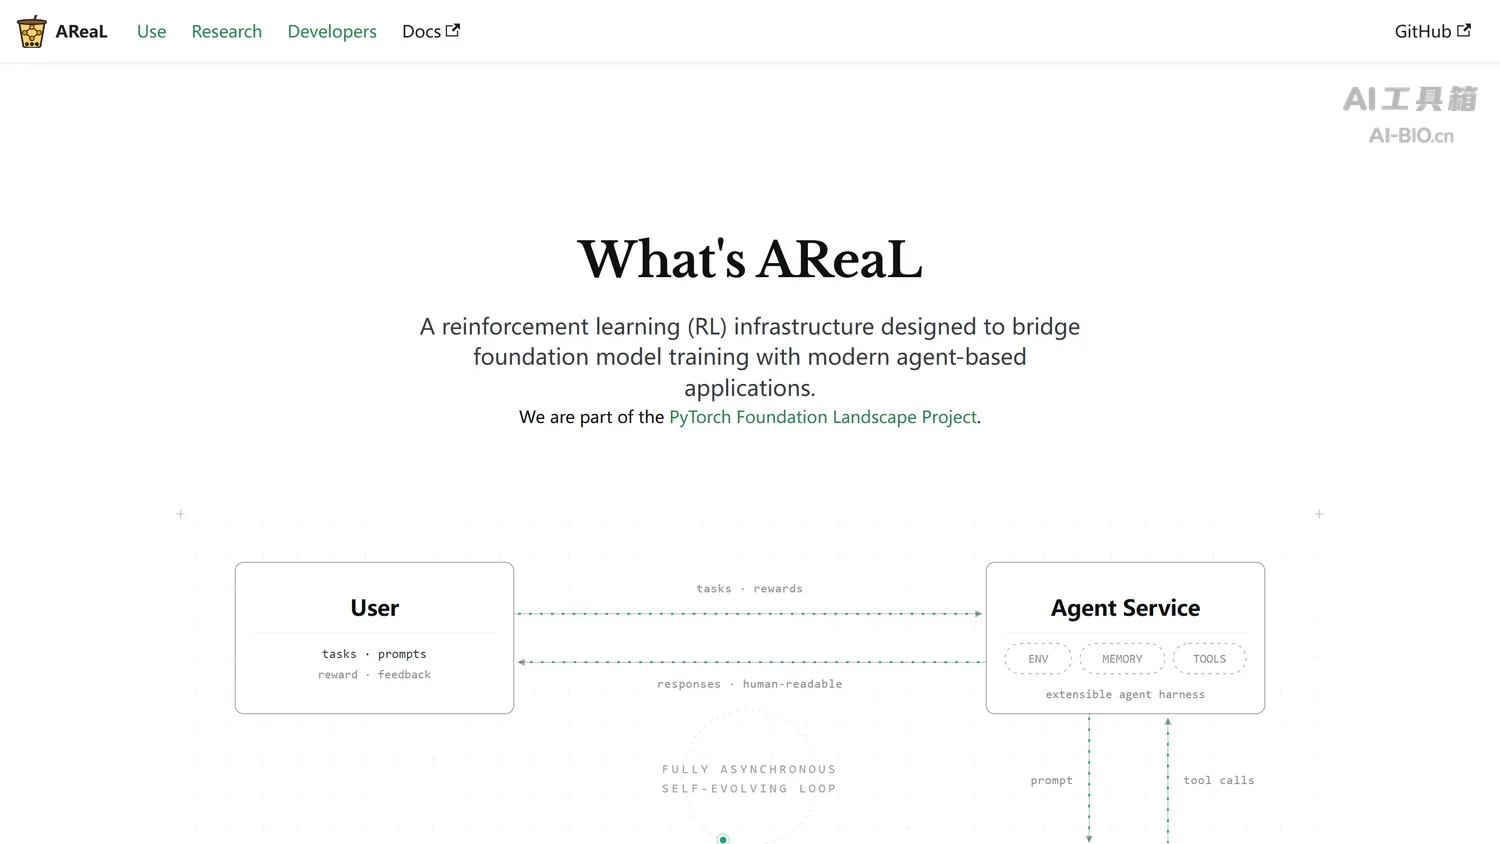
AReaL 2.0 是一款由蚂蚁集团 AReaL 团队与清华大学于 2026 年 7 月开源的异步强化学习训练系统,主要用于训练推理模型与智能体,支持训练、推理、智能体执行与权重更新四类服务分别扩缩容,适用于智能体在线训练、代码任务强化学习与多机集群训练等场景。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 异步强化学习训练系统 |
| 出品方 | 蚂蚁集团 AReaL 团队与清华大学 |
| 发布时间 | 2026 年 7 月 1 日 |
| 开源协议 | Apache-2.0 |
| 开发语言 | Python |
| 架构形态 | 训练、推理、智能体、权重更新四类微服务 |
| 在线训练 | 内置 Hermes 在线 RL 循环 |
| 配套示例 | 端到端 SWE 强化学习训练示例 |
| 部署方式 | 自建集群,按需扩缩容 |
| 文档情况 | 官方文档站,含中文版 |
| 最新版本 | v2.1.0(2026 年 8 月 25 日) |
AReaL 2.0 的核心能力
强化学习训练最费机器的部分从来不是算梯度,而是让「生成轨迹的智能体」和「算奖励的训练进程」跑得不互相等待。站内同类路线可对照 WorkForge,它解决的是训练环境怎么造。
训练与推理拆成独立服务
2.0 把系统重构成四类独立服务:训练、推理、智能体执行、权重更新,各自有接口与进程边界。哪一环吃紧就单独扩哪一环,不必为了一次吞吐提升把整个作业按同一比例放大。
全异步训练流水
生成轨迹与参数更新在时间上错开,推理侧边产数据、训练侧边消费,权重更新单独通道回灌。异步带来的版本落差由系统内部处理,使用方按配置文件调并发与步长即可。
在线 RL 循环
仓库内置 Hermes 在线训练循环示例,用于让已部署的智能体在真实交互里持续更新。与离线批次训练相比,这条链路更贴近线上分布,代价是对采样质量与奖励函数的要求更高。
端到端代码任务示例
官方给出 SWE 任务的端到端训练示例,从环境准备、轨迹采集到奖励计算串成一条可直接跑的脚本。想做代码智能体强化学习,可以照这套示例改数据与奖励,而不是从空目录搭流程。
接口替换即可接入自有智能体
官方示例演示了把自建智能体的 base_url 与 api_key 指向 AReaL 的 RL 服务,不改代码就能把已有 agent 拉进训练回路。这一条降低了「已有编排层再补训练」的改造成本,站内的 QwenGyre 提供的是另一套在线 RL 框架口径。
文档、技术报告与社区
2.0 配有技术报告与文档站,中文版同步维护;社区按双周例会推进,会议材料公开在仓库资产目录。训练框架踩坑多,能否查到同版本的行为说明,往往比多一个算法选项更实用。
AReaL 2.0 与 verl 的对比
两者都是开源的强化学习训练框架,差别在系统怎么切分、异步做到什么程度。下表按可核实的结构项并列。
| 对比维度 | AReaL 2.0 | verl |
|---|---|---|
| 出品方 | 蚂蚁集团 AReaL 团队与清华大学 | 字节跳动火山引擎团队 |
| 开源协议 | Apache-2.0 | Apache-2.0 |
| 开发语言 | Python | Python |
| 架构形态 | 训练、推理、智能体、权重更新四类微服务 | 以控制器调度多角色训练进程 |
| 异步程度 | 全异步流水,轨迹与更新错峰 | 以同步与异步混合调度为主 |
| 在线训练 | 内置 Hermes 在线 RL 循环 | 以离线批次训练脚本组织 |
| 代码任务示例 | 端到端 SWE 训练示例 | 提供智能体 RL 训练示例 |
| 首次开源 | 2026 年 7 月(2.0 版本) | 2024 年 10 月 |
最影响落地的是三处。架构形态:AReaL 2.0 把四类能力拆成独立服务,适合已经按微服务运维的团队;verl 用控制器调度多角色进程,单机起步更轻。在线训练:AReaL 2.0 自带在线循环,verl 更多以批次脚本组织。首次开源:verl 2024 年 10 月入场、生态铺得更早,AReaL 2.0 到 2026 年 7 月才开源,晚近两年。
还有一处容易被忽略的差异在版本节奏上:AReaL 2.0 属于重大重构版本,2.0 与 1.0 的接口不兼容,照旧版教程操作会踩空;verl 的版本线相对连续,历史脚本迁移成本更低。选型前先确认手头教程对应哪个大版本。
如果瓶颈在推理吞吐而不是训练框架,站内的 AngelSpec(腾讯混元推出的大模型推测解码训练与部署框架)是另一个切面。
AReaL 2.0 的应用场景与适用人群
这套系统解决的问题集中在「模型要在真实交互里变强」的地方;要准备训练环境与沙箱,可对照 DeepSeek DSec 的做法:
- 代码智能体训练:用真实仓库任务做轨迹采集,按测试通过率给奖励。
- 在线服务迭代:把线上智能体的交互回流进训练回路,缩短版本迭代周期。
- 多机集群实验:训练与推理分别扩缩容,做算法对比时能压住等待时间。
- 智能体能力评测:同一套服务既跑训练也跑评测,减少环境差异带来的偏差。
- 教学与复现:按官方示例走完一条完整链路,用于团队内部方法复现。
适用人群:适合有 GPU 集群、要自建强化学习流水线的算法团队,以及已有智能体产品、想把线上反馈接回训练的工程团队;只做单卡微调、或没有稳定奖励信号的场合,直接上通用微调脚本更划算。
AReaL 2.0 的使用方法
官方给了三条路:按文档验证通过在线训练、把已有智能体接进回路、单独用推理服务。安装与配置见 官方文档。
源码部署:验证通过一条在线训练链路
- 按文档安装依赖,准备训练与推理两侧的模型权重与并行配置。
- 起训练、推理、智能体、权重更新四类服务,先确认服务间健康检查通过。
- 用 Hermes 示例跑一个小规模循环,观察轨迹产出与奖励计算的时序。
- 确认单机验证通过后再按节点扩缩容,避免一上手就排集群问题。
接入已有智能体:只改接口地址
- 在自有智能体侧找到模型服务地址与密钥的配置项。
- 把
base_url与api_key指向 AReaL 的 RL 服务,保持其余调用逻辑不动。 - 跑一次小样本,核对轨迹是否被正确记录、奖励是否按预期回传。
只接推理服务:先做并发压测
- 单独部署
inference_service,接上已有权重。 - 按线上峰值并发做一次压测,记录首 token 时延与吞吐。
- 把结果与现有推理栈对比,再决定是否整体迁移。
入场成本主要在三处:集群要能同时容纳训练与推理两类负载、奖励函数要写成可自动判定的形式、版本落差要在文档里查得到。已有调度框架的团队还要处理端口与存储挂载;站内的 EAPO 这类长上下文推理框架也会碰到同一批工程问题。
AReaL 2.0 的项目地址
- 项目官网:https://areal-ai.io
- GitHub 主仓库:https://github.com/areal-project/AReaL
- arXiv技术论文:https://arxiv.org/pdf/2607.01120
AReaL 2.0 的价格方案
代码按 Apache-2.0 分发,不收费,也没有企业版或按席位计价这一层。商用、改造、内网部署都允许,需要保留许可与版权声明,改动部分不必强制开源。
真实成本在算力与人力:训练与推理两类集群同时在线,卡时开销按各家云价计;奖励函数与数据管线的工程投入通常高于框架本身的接入成本。小规模验证建议先租按量实例,跑顺再谈长期集群。
AReaL 2.0 的常见问题
从 1.0 升级要注意什么
2.0 是重构版本,接口与目录结构都与 1.0 不同,旧脚本不能直接迁移;建议按 2.0 文档重跑示例,再逐段替换自研逻辑。
必须准备大规模集群吗
不必。可以先在单机或少量节点上验证通过 Hermes 示例,确认链路与时序没问题,再按训练与推理的瓶颈分别扩缩容。
训练数据要什么格式
官方示例按轨迹与奖励组织数据,代码任务场景的奖励通常由测试是否通过来判定;自建任务需要把判定逻辑写成可自动执行的形式。
和 verl 怎么选
要微服务化部署、需要内置在线循环选 AReaL 2.0;希望沿用更早的社区脚本与生态、单机起步更轻,verl 更省心。
支持哪些模型
仓库示例覆盖主流开源模型与代码任务模型,具体版本的并行与切分配置以官方文档对应章节为准。
相关文章

 浙公网安备33010202004812号