
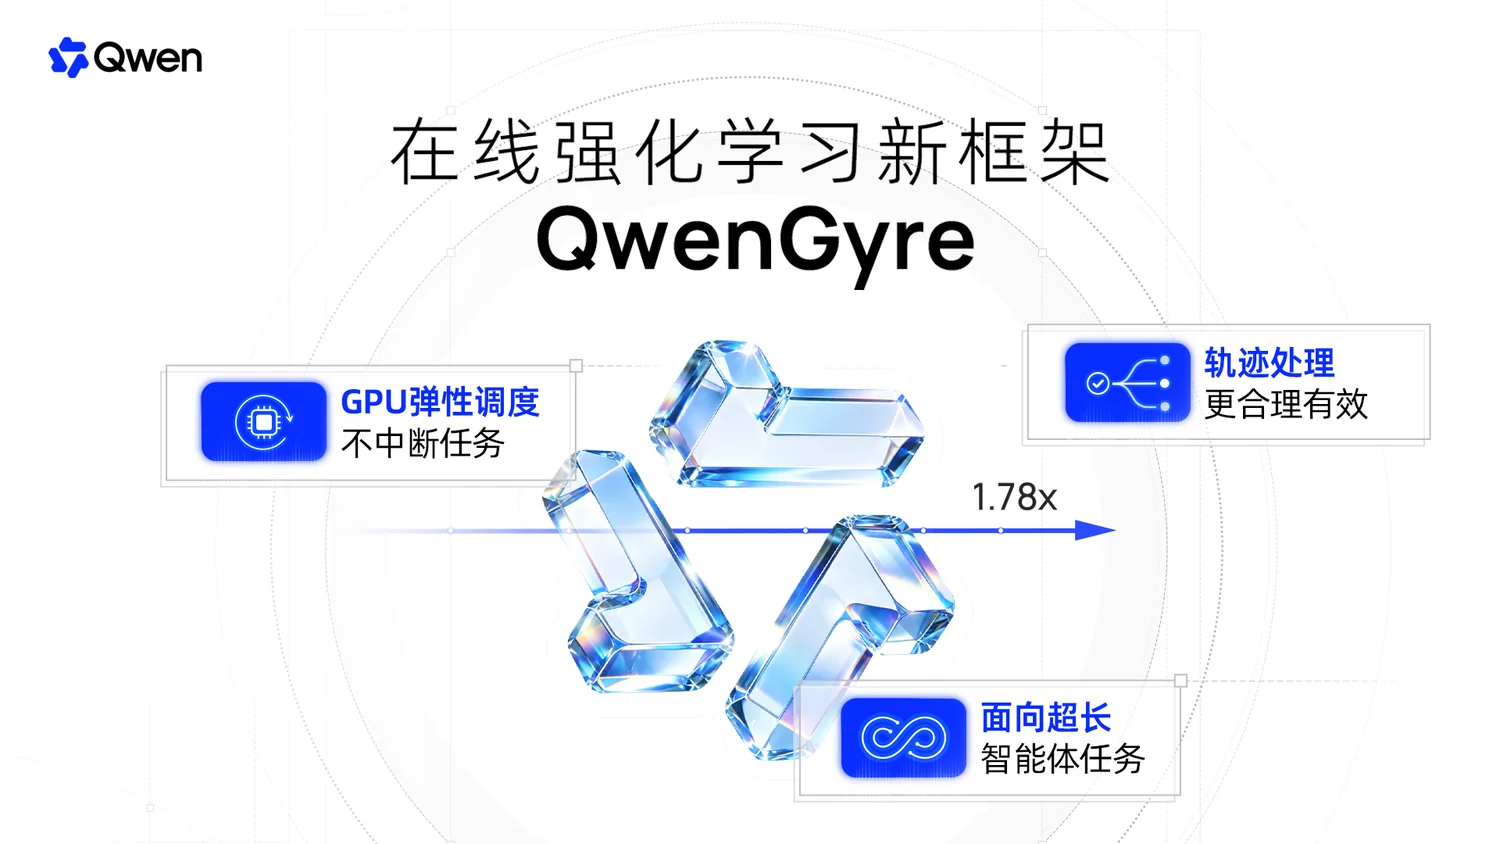
QwenGyre是阿里千问于 2026 年 10 月推出的在线强化学习框架,面向超长程智能体任务,主要用于把持续数小时、累计可达百万级 token 的智能体执行转化为可训练样本,支持任务不中断的弹性 GPU 调度与轨迹处理,适用于代码仓库生成、长程软件工程与终端自动化等需要连续执行的场景。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 超长程智能体在线强化学习框架 |
| 出品方 | 阿里千问(Qwen) |
| 发布时间 | 2026年10月12日 |
| 核心能力 | 弹性 GPU 调度、轨迹处理 |
| 训练后端 | Megatron |
| 采样引擎 | SGLang |
| 实验模型 | Qwen3.8-2.4T、Qwen3.6-122B |
| 开放情况 | 论文形式发布,暂未开源 |
QwenGyre 的核心能力
QwenGyre 是阿里千问提出的在线强化学习框架,它要处理的对象是 AI智能体 的超长程执行:一次任务可能持续数小时,与环境发生数百轮相互依赖的交互,累计处理接近百万级的 token。官方把这类任务称为 xLong-horizon。它们此前很难直接用于强化学习训练——采样与训练争抢同一批 GPU,执行时间的长尾分布让算力大量空转;而历史压缩、子智能体委派与重试又会让一次执行分叉出多条上下文路径,反复处理共享前缀。QwenGyre 的两项设计分别针对这两个问题。
在 2.4T 旗舰模型上完成 48 步在线强化学习
官方把 QwenGyre 用于千问的 2.4T 旗舰模型 Qwen 3.8-Max,在每次 rollout 约 70 万 token 的任务上开展在线强化学习。经过 48 步训练,模型在 NL2RepoBench 上的通过率从 52.48% 提升至 58.54%,提高 6.06 个百分点。官方说明,QwenGyre 与 Async、Colocate 两种调度方式的训练分数接近,差别集中在训练效率,训练过程中模型的任务完成能力确实随步数上升。
不中断任务的弹性 GPU 调度
QwenGyre 把 GPU 划分为若干计算单元,每个单元采用相同的训练并行配置,既能提供采样服务,也能承载完整的模型副本参与训练。调度器持续跟踪仍在运行的任务:只要剩余采样容量足以支撑这些任务,且已有足够数据持续供给训练,就把部分计算单元切换过去;随着任务逐步结束,更多单元随之加入。切换时智能体继续运行,工作区与工具状态全部保留,代理负责把模型请求转到新的推理引擎并重试未完成的请求,KV cache 通过 RDMA 迁移,减少重复计算,后端进程与通信组无需重建。
轨迹处理保住长程任务的有效信号
针对分叉执行带来的重复计算,QwenGyre 记录每次模型调用的精确输入与输出 token,再按共享前缀组织成轨迹树,只为选中的路径生成训练样本,使早期输出始终对应其生成时的上下文。框架为每次执行设置轨迹预算,优先保留主智能体及其摘要路径,共享前缀里的同一段输出只计一次损失。对超时未完成的任务,则按任务规则评估已产出的部分成果,让部分完成也能用于训练;若在总时间预算内始终拿不到有效评估,这次执行才会被丢弃。
相同 GPU 预算下的端到端提速
效率对比采用相同的 GPU 预算,并匹配平均调度陈旧度。完成相同的 48 步训练,QwenGyre 把总耗时从 Async 的 134.55 小时缩短至 75.42 小时,端到端加速 1.78 倍,节省约 44% 的训练时间;官方论文给出的数据还显示,其对 Colocate 的加速最高可达 1.85 倍。在 Qwen3.6-122B 上的跨任务验证中,NL2RepoBench 按 48 步统计,DeepSWE 与 TerminalBench 按 24 步统计,三类任务都取得了端到端提速。此外,轨迹预算最多保留五条轨迹时,训练分数与梯度范数接近全量轨迹,平均每步前向与反向计算时间减少 25.2%。
QwenGyre 与同类强化学习框架的对比
| 对比维度 | QwenGyre | verl | SkyRL |
|---|---|---|---|
| 出品方 | 阿里千问 | 字节跳动 Seed 团队与 verl 社区 | 加州大学伯克利分校 NovaSky-AI |
| 产品定位 | 超长程智能体在线强化学习框架 | 通用大语言模型强化学习训练库 | 模块化全栈大语言模型强化学习库 |
| 首发时间 | 2026 年 10 月 | 2024 年 | 2025 年 6 月 |
| 开源许可 | 暂未开源 | Apache-2.0 | Apache-2.0 |
| 训练后端 | Megatron | FSDP、Megatron-LM | FSDP、Megatron |
| 推理引擎 | SGLang | vLLM、SGLang | vLLM、SGLang |
上表 QwenGyre 一列取自千问官方公众号与技术论文,verl 一列取自 verl 官方仓库说明与开源许可证,SkyRL 一列取自 SkyRL 官方仓库说明与开源许可证。三者面向的任务形态并不相同:需要把小时级连续执行直接转为训练样本的,可以看 QwenGyre 的调度与轨迹设计;需要在既有集群上自行改动采样与训练流程的,verl 与 SkyRL 都提供了可直接修改的代码。
QwenGyre 目前以技术论文形式公开,代码与安装包尚未开放。如果想先了解千问团队在智能体训练方向上已经开源的配套工作,可以参考 Qwen-AgentWorld(阿里巴巴千问团队推出的智能体世界模型,采用 Apache 2.0 协议开源,提供智能体训练与评测所需的环境支持)。
QwenGyre 的应用场景与适用人群
该框架面向需要在真实环境中连续执行数小时的智能体任务,常见场景包括:
- 自然语言生成完整代码仓库:按一份规格说明从零构建多包软件仓库,单次执行累计处理接近百万 token。
- 已有代码库的长程工程改造:在现有仓库中完成功能开发、缺陷修复与跨文件改动,需要连续规划与反复验证。
- 多轮终端自动化操作:智能体在命令行环境中连续执行数百轮工具调用,完成系统配置与运维任务。
- 多智能体协作任务:主智能体委派子智能体的层级执行,轨迹处理可利用分叉结构控制子任务的训练成本。
适用人群:需要为智能体训练搭建强化学习基础设施的模型团队、研究超长程任务的高校与实验室,以及希望把长时间连续执行的智能体轨迹转化为训练数据的工程团队。
QwenGyre 的使用方法
QwenGyre 目前以技术论文形式公开,尚未提供安装包,可按以下顺序了解与评估:
- 阅读官方技术论文:调度算法、轨迹处理的完整设计与实验设置,可在 QwenGyre 官方技术论文(2026 年 9 月提交)中查看。
- 对照硬件与后端条件:论文实验采用 Megatron 训练后端与 SGLang 采样引擎,并把 GPU 划分为同构计算单元,部署前需要按该组合准备集群。
- 评估调度改造收益:如果现有流程使用 Async 或 Colocate 式调度,可以对照论文给出的调度消融实验,判断改造成弹性调度后的耗时变化。
- 关注开放进展:官方暂未公开代码与安装包,后续的开放安排以千问大模型官方渠道的说明为准。
论文中的效果来自 2.4T 与 122B 两个规模的模型,并依赖长时间连续执行的真实任务数据;在更小的模型或更短的任务上,弹性调度带来的收益会相应收窄。
QwenGyre 的价格方案
QwenGyre 由阿里千问以技术论文形式公开,官方未公布商业化定价与计费方案,目前也没有面向外部的付费入口或接口调用价格。框架的成本主要落在训练侧:官方实验在 Qwen3.8-2.4T 上完成 48 步训练,相同 GPU 预算下的总耗时从 Async 的 134.55 小时降至 75.42 小时。
QwenGyre 的代码与安装包暂未开放,官方也未说明后续的开源安排,因此当前无法直接下载或本地部署。需要立刻落地的团队,可以先在已有开源方案上完成流程搭建,再对照论文判断是否需要迁移。
QwenGyre 的常见问题
QwenGyre 是什么?
QwenGyre 是阿里千问于 2026 年 10 月推出的在线强化学习框架,面向超长程智能体任务。它通过弹性调度把空闲 GPU 转入训练而不中断正在执行的任务,并通过轨迹处理压缩分叉执行的重复计算,让持续数小时、累计接近百万 token 的智能体执行成为有效的训练来源。
QwenGyre 是开源的吗?
目前不是。QwenGyre 以技术论文形式公开,官方尚未提供代码仓库与安装包,也未说明后续的开源安排,因此暂时无法直接下载或本地部署。
QwenGyre 相比 Async 与 Colocate 有哪些改进?
官方在相同 GPU 预算下对比了三种调度方式。完成相同的 48 步训练,QwenGyre 把总耗时从 Async 的 134.55 小时缩短至 75.42 小时,端到端加速 1.78 倍,节省约 44% 的训练时间;论文给出的数据还显示其对 Colocate 的加速最高可达 1.85 倍,三者的训练分数则保持接近。
相关文章


 浙公网安备33010202004812号