
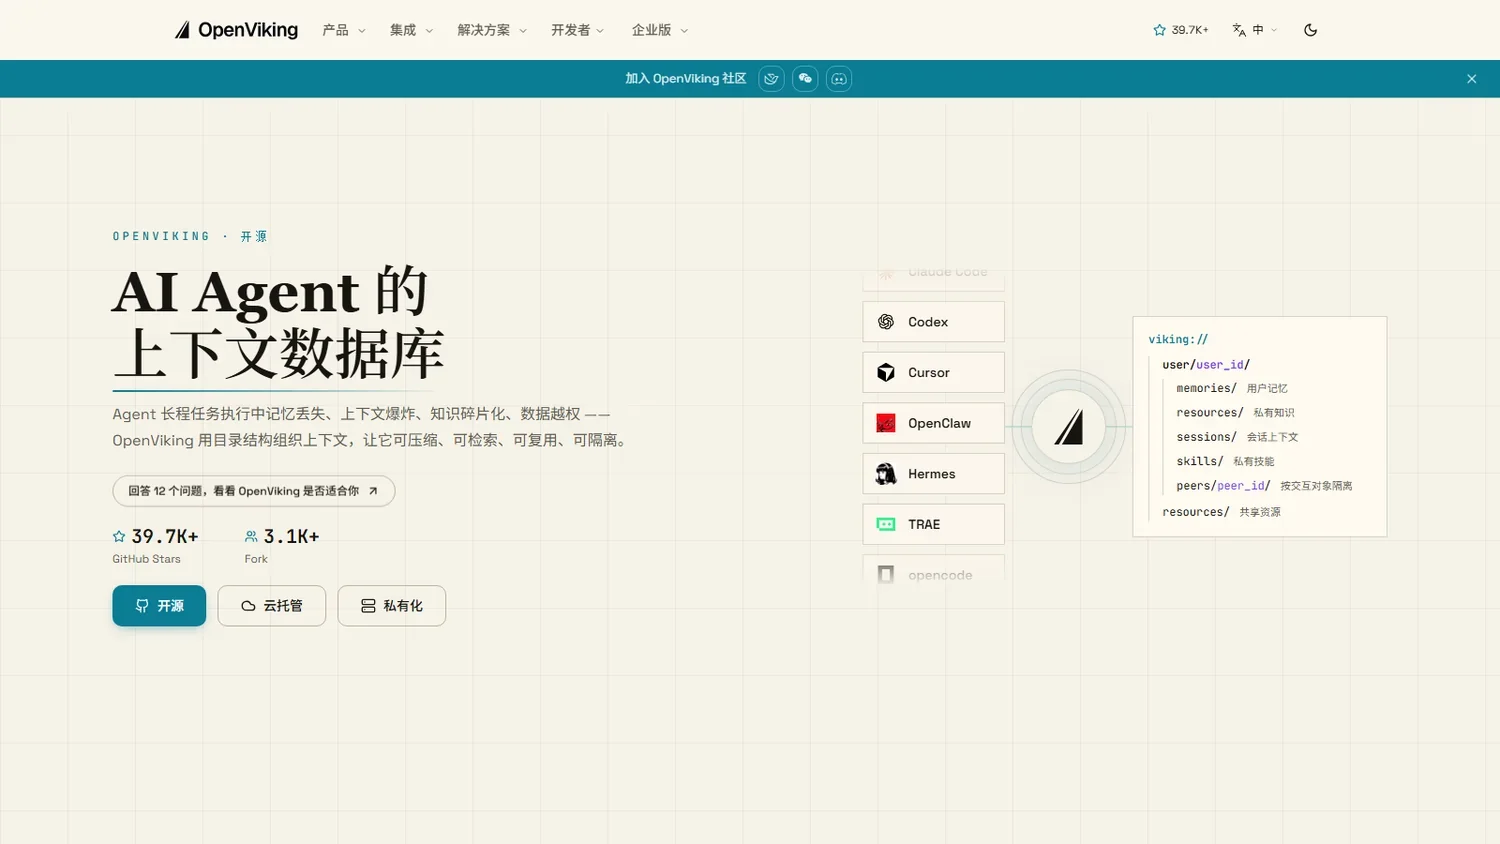
OpenViking是一款由字节跳动火山引擎于2026年1月开源的AI Agent 上下文数据库,主要用于把智能体的记忆、知识资源与技能统一组织到虚拟文件系统并支持按目录检索,适用于智能编程助手、多 Agent 协作与长程任务记忆等方向。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | AI Agent 上下文数据库 |
| 出品方 | 字节跳动火山引擎 Viking 团队 |
| 发布时间 | 2026年1月5日开源 |
| 组织方式 | viking:// 虚拟文件系统 |
| 加载机制 | 摘要、概览、详情三层渐进 |
| 检索方式 | 目录级语义检索与文本匹配 |
| 接入方式 | MCP、标准插件与多语言 SDK |
| 开源许可 | 主项目 AGPL-3.0 |
OpenViking 的核心能力
长程任务里,智能体的记忆问题往往不是「记不住」,而是上下文被无差别地写进窗口:早期信息被反复重读,token 消耗随会话持续上涨,模型反而在被稀释的上下文里变钝。OpenViking 把这类内容当作数据库来管理,让检索先看摘要、再按需展开。理解这层定位,可以先了解 AI 智能体 的执行方式。
统一上下文文件系统
OpenViking 用自定义的 viking:// 协议把记忆、知识资源与技能统一组织成虚拟文件,智能体可以像操作本地文件一样浏览、检索与编辑这些内容。每类内容各占一个目录,边界清晰,打开目录就能看清智能体究竟掌握了哪些信息,不再是输入文本、输出向量的黑盒。
三层渐进加载
每个目录会自动生成摘要、概览与完整内容三层表示:智能体先读摘要判断相关性,确认需要后再向下加载详情,从而避免把整库内容一次性塞进上下文。官方在 LoCoMo 评测中给出的输入 token 降幅为 34% 至 91%,延迟降低约 58% 至 66%。
目录级语义检索
检索支持语义查找与文本匹配两种方式,可以把范围限定在某个项目或某段记忆子树内,而不是每次都对全库做扫描。范围收敛之后,返回内容与当前任务的贴合度更高,噪声减少,这也是 token 能显著下降的原因之一。
会话沉淀与记忆提取
提交会话后,OpenViking 会自动归档对话并把其中的记忆提取成可检查、可编辑的 Markdown 文件,而不是写进一个不可见的向量库。配套的 VikingBot 还能把素材编译成 wiki、知识图谱或报告。
多 Agent 接入
项目原生集成了 Claude Code、Codex、Cursor 与 OpenClaw 等多款编程智能体,同时提供 MCP、Agent Plugin 1.0 标准插件以及 Python、Go 与 TypeScript 三套 SDK。已经在使用某款智能体的团队,通常不需要更换工具就能接上这层记忆能力。
可视化与权限隔离
浏览器端的 OpenViking Studio 可以直观浏览上下文结构并在线试玩语义搜索;服务端支持多账号、用户级隔离与可选的资源访问控制,便于团队共享同一份上下文基础设施。
效果与生态位置
官方给出的对比数据显示,接入这层上下文后,Claude Code、Hermes 与 OpenClaw 三个底座在长期记忆任务上的准确率从 24% 至 57% 拉升至 80% 以上。项目由火山引擎 Viking 团队发起,该团队此前长期维护 VikingDB 向量数据库与相关知识库产品。
OpenViking 与上下文方案的对比
下表从数据组织、加载方式与检索机制等维度,对比三款常被放在一起评估的上下文管理方案。
| 对比维度 | OpenViking | MemOS | Graphiti |
|---|---|---|---|
| 产品定位 | AI Agent 上下文数据库 | 智能体记忆系统 | 时序知识图谱引擎 |
| 数据组织 | viking:// 虚拟文件系统与目录树 | 结构化记忆图与空间隔离 | 以实体与关系构成的时序图谱 |
| 上下文加载 | 摘要、概览、详情三层渐进加载 | 记忆节点异步重组补充关系 | 按图谱关系逐步展开 |
| 检索机制 | 目录级语义检索搭配文本匹配 | 图检索与向量检索并行召回 | 图谱遍历结合语义检索 |
| 检索范围 | 可限定到指定目录或子树 | 通过记忆空间隔离收敛范围 | 按实体与关系收敛范围 |
| 冲突处理 | 会话归档后记忆可编辑合并 | 由模型判断冲突与冗余后合并 | 以时间版本记录事实变化 |
| Agent 接入 | 原生集成多款编程智能体 | 以插件与接口接入 | 以服务与接口接入 |
| 可视化 | 提供浏览器端浏览与检索界面 | 提供管理界面 | 以接口与配套工具为主 |
上表 OpenViking 一列取自字节火山引擎官方项目说明与仓库文档,MemOS 一列取自其官方介绍,Graphiti 一列取自其开源仓库说明。三者的差别在于对上下文的建模方式:OpenViking 用文件系统的目录结构组织记忆、知识与技能,MemOS 把记忆切成可隔离的空间,Graphiti 以时序知识图谱承载实体与关系的演化。需要把检索范围按目录精准收敛时,前者的边界最直观;需要追踪某个事实随时间的变化时,图谱式的组织方式更贴合。
如果更关心接入侧的智能体形态,可以参考 Hermes Agent(开源的智能体项目,OpenViking 原生集成的对象之一,两者分别处在「记忆层」与「执行层」的位置)。

OpenViking 的应用场景与适用人群
把上下文当作可浏览、可编辑的文件系统之后,常见用途包括:
- 智能编程助手:把代码仓库与文档导入资源目录,智能体按目录检索并记住开发者的编码习惯,跨会话持续跟进项目。
- 多 Agent 协作:通过 peers 目录隔离不同交互对象的上下文,共享资源目录沉淀团队知识,多个智能体协同工作。
- 销售与客户服务:在用户记忆目录中沉淀客户偏好与历史沟通记录,销售智能体跨会话召回信息,提升多轮业务任务的成功率。
- 内容与视频创作:把分镜脚本、素材库与品牌规范组织为上下文资源,智能体按项目检索素材并记住创作者风格,支撑长期连贯创作。
- 推荐与诊断:导入策略文档、badcase 记录与实验日志,诊断智能体按目录范围检索证据链,用更少的 token 定位问题。
适用人群:需要为智能体搭建长期记忆与知识底座的技术团队,以及已经在使用 Claude Code、Codex 或 Cursor 等编程智能体、希望把上下文交给独立一层管理的开发者。由于主项目采用 AGPL-3.0 许可,计划内嵌到闭源商业产品时,应提前确认协议条款。
OpenViking 的使用方法
OpenViking 以开源项目形式发布,从获取代码到启动服务可按以下步骤操作:
- 获取项目:访问 OpenViking 项目官网 了解整体设计,代码托管在
github.com/volcengine/OpenViking仓库。 - 安装主包:执行
pip install openviking --upgrade安装主程序。 - 初始化配置:运行
openviking-server init配置模型供应商。 - 检查环境:运行
openviking-server doctor验证配置与模型连通性。 - 启动服务:运行
openviking-server启动本地服务端。 - 导入资源:用
ov add-resource导入代码仓库或文档,再用ov task status等待索引完成。 - 浏览与检索:用
ov ls与ov tree浏览目录结构,用ov find做语义检索,用ov grep做文本匹配。 - 体验对话:执行
pip install openviking[bot]后运行openviking-server --with-bot,再用ov chat与内置智能体对话。
建议先在本地用一份规模较小的代码仓库验证索引与检索效果,确认召回质量与消耗符合预期后再接入生产项目;团队部署时还应提前规划账号隔离与访问控制。
OpenViking 的价格方案
OpenViking 以开源方式发布,主项目采用 AGPL-3.0 许可,不按调用量收费,支出主要来自自行部署所需的算力与运维;对已有 GPU 资源的团队,边际成本集中在电费与人力。
除自托管之外,官方也提供火山引擎上的托管服务与面向个人的试用版本。需要把上下文数据留在自有环境时,自托管是更可控的选择,具体服务范围与费用以官方页面为准。
OpenViking 的常见问题
OpenViking 和向量数据库有什么不同?
常规做法是把文档切成扁平分块存入向量库、按相似度取回;OpenViking 把上下文按目录组织成虚拟文件系统,先由摘要判断相关性再按需加载,并允许把检索范围限定在某个目录或子树内。
OpenViking 支持哪些智能体?
官方说明原生支持 Claude Code、Codex、Cursor、OpenClaw、Hermes 等多款智能体,同时提供 MCP、Agent Plugin 1.0 标准插件以及 Python、Go 与 TypeScript 三套 SDK。
OpenViking 可以商用吗?
项目以开源方式发布,主项目为 AGPL-3.0 许可,命令行工具与示例为 Apache 2.0。计划内嵌到闭源商业产品时,应提前确认 AGPL 的网络交互条款。
相关文章


 浙公网安备33010202004812号