
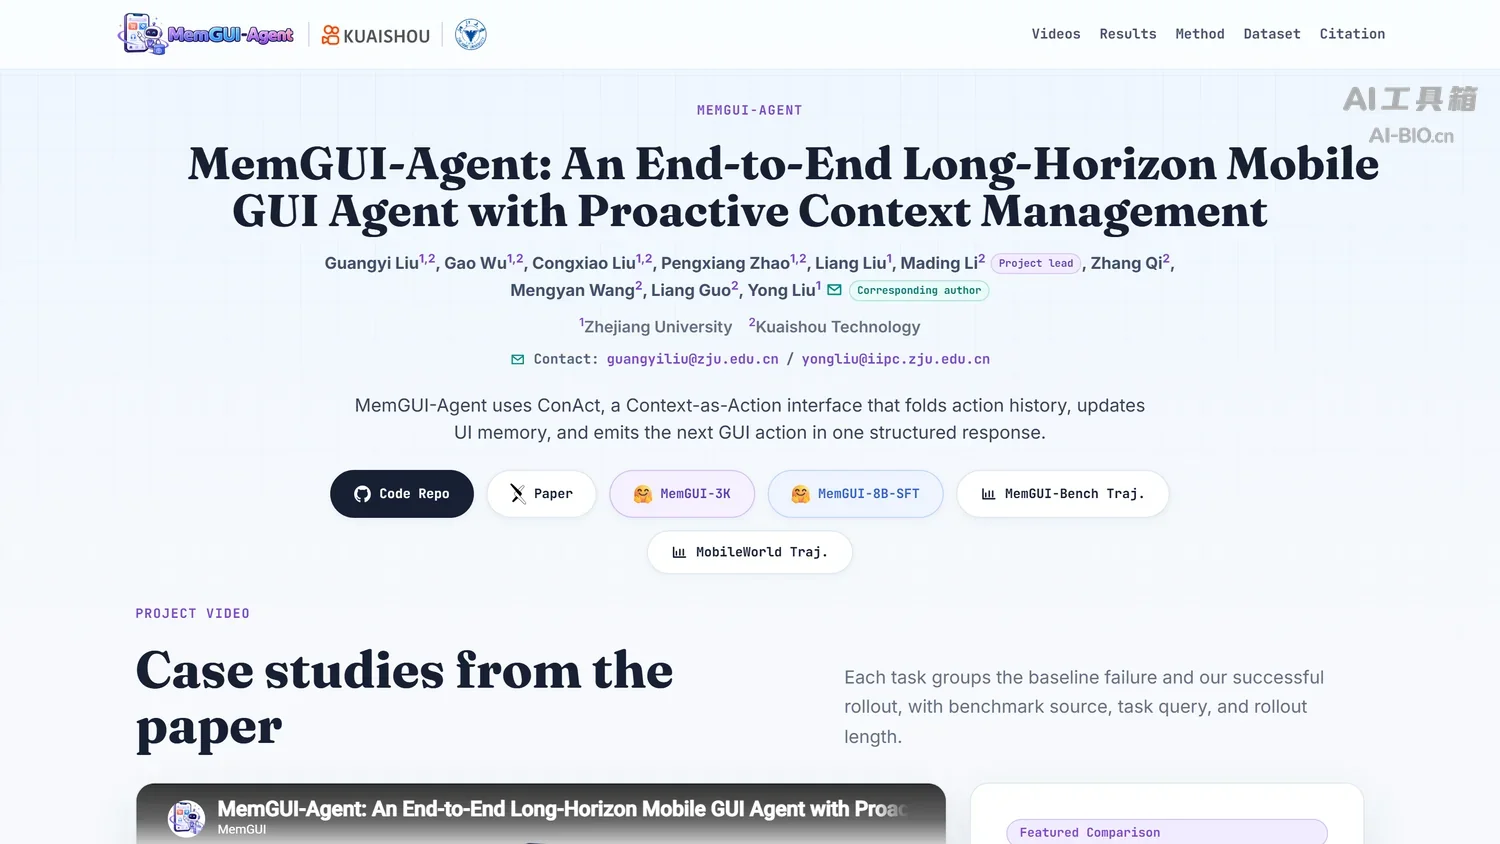
MemGUI-Agent 是由浙江大学与快手联合研发、于 2026 年 6 月开源的长程手机 GUI 智能体,主要用于在手机上按自然语言指令完成多步操作,支持主动上下文管理与长程任务训练,适用于跨应用流程代办、手机端自动化测试与界面操作评测等场景。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 长程手机 GUI 智能体 |
| 出品方 | 浙江大学、快手(联合研发) |
| 发布时间 | 2026 年 6 月 23 日 |
| 开源协议 | Apache-2.0 |
| 开发语言 | Python |
| 核心机制 | 主动上下文管理,压缩历史界面与操作 |
| 配套数据 | MemGUI-3K 数据集 |
| 开放权重 | MemGUI-8B-SFT |
| 基准表现(MemGUI-Bench) | 235B 62.5%、8B-SFT 23.4% |
| 第三方基准(MobileWorld) | 235B 29.1%、8B-SFT 17.9% |
MemGUI-Agent 的核心能力
手机上的长任务最容易出问题的不是单步识别,而是走到第十几步时把前面看过的界面忘掉。同类问题站内的 Hy-Memory 2.0 从记忆框架一侧给出解法,MemGUI-Agent 把记忆做进了智能体本身。
主动上下文管理
智能体在每一步判断哪些界面信息值得留下、哪些可以压成一句摘要,历史不是整段堆进上下文。长任务的上下文长度因此可控,走到几十步时仍能记得最初的目标与已经完成的环节。
界面记忆的压缩与复用
同类页面结构会被归并成可复用的描述,下次遇到相似界面直接调用,不必重新识别一遍。这一层省下的既是上下文窗口,也是推理时间,对手机端算力尤其关键。
端到端任务执行
从收到指令到点完最后一步由模型统一决策,中间不做人工拆解。任务跨度可以覆盖跨应用的多段流程,比如先查信息再填表提交,这类流程在单步模型上很难串起来。
训练流程可改
仓库给出训练与评测的完整实现,不只是推理脚本。要换数据或改奖励逻辑,可以从训练入口改起,评测部分按基准题集组织,复现时能对齐同一套口径。
公开权重可复现
同步放出 MemGUI-3K 数据集与 8B 微调权重,小规模验证不必从采集数据开始。数据与权重都按公开渠道分发,做对比实验时能固定住变量,减少自己造数据带来的偏差。
基准与横向对照
配套的 MemGUI-Bench 用于衡量长程任务完成度,README 给出 235B 版本 62.5% Pass@3 与 8B 微调版本 23.4% Pass@1。更能说明泛化能力的是第三方基准 MobileWorld:在它 GUI-Only 的 117 个任务上,235B 版本 Pass@1 成功率 29.1%,8B 微调版本 17.9%,比同骨干的 Qwen3-VL 基线分别高出 14.6 与 8.5 个百分点,两项数据在 MobileWorld 官方页面上都能逐条核对。想做手机端自动化评测,可对照站内 PhoneBuddy 这类训练框架的数据组织方式。复现前还要对齐数据口径:MemGUI-3K 收录 2956 条成功轨迹、覆盖 26 个应用,平均每条 28.8 步,长程样本密度直接决定微调后的表现。8B 微调版本在 8 张 80GB 显卡上训练约 535 分钟,做同规模实验前先按这个量级估机时。
MemGUI-Agent 与 OpenMobile-8B 的对比
两者都是用开源数据训练的手机 GUI 智能体,在 MobileWorld 上分数接近,走的却不是同一条路:一个把上下文管理做进策略,一个用合成数据把训练轨迹铺开。下表按可核实项并列。
| 对比维度 | MemGUI-8B-SFT | OpenMobile-8B |
|---|---|---|
| 出品方 | 浙江大学、快手(联合研发) | 南洋理工、上海人工智能实验室、南京大学等多机构 |
| 模型规模 | 8B(Qwen3-VL-8B 微调) | 8B(Qwen3-VL 微调) |
| 上下文机制 | ConAct 主动管理:折叠历史+记忆动作 | 追加式历史,无独立记忆动作 |
| MobileWorld SR(GUI-Only·Pass@1) | 17.9% | 17.7% |
| 训练数据来源 | 2956 条真机轨迹,平均 28.8 步 | 合成任务与轨迹(环境探索+策略切换) |
| 开放产物 | 代码、数据集与 8B 权重 | 代码、数据集与模型(Apache-2.0) |
| 主要评测基准 | MemGUI-Bench、MobileWorld | AndroidWorld(Qwen3-VL 版 64.7%) |
两者在 MobileWorld GUI-Only 上只差 0.2 个百分点,路径却不同。上下文机制:MemGUI-8B-SFT 由策略决定压缩与记忆,OpenMobile-8B 沿用追加式历史,靠合成数据铺场景。训练数据:前者是 2956 条真机长程轨迹,后者由任务合成自动生成。规模放大:同一套 ConAct 用在 235B 骨干上是 29.1%,比同骨干基线高 14.6 个百分点。
还有一个不在表里的差异是出发点:OpenMobile 先解决开源训练数据从哪来,覆盖的功能面更广,适合拿来做数据基座;MemGUI-Agent 解决长程任务里上下文怎么管,适合改机制、做对照实验。两者都依赖真机或模拟器环境,评测成本不在模型侧而在设备侧。
如果要的是跨手机、电脑与浏览器的统一基座,站内的 Qwen-UI-Agent(阿里巴巴通义实验室推出的 GUI 智能体基座模型)是另一个方向的参照。
MemGUI-Agent 的应用场景与适用人群
记忆机制带来的收益集中在「步骤多、界面反复出现」的流程;要做跨设备的统一操作,可对照 Qwen Intelligence 的全栈方案:
- 跨应用代办:从聊天里取信息,切到另一个应用填表提交,中途不丢目标。
- 自动化测试:按脚本走完关键路径,检查界面元素与提交流程是否仍然可用。
- 评测与打榜:用 MemGUI-Bench 对齐口径,比较不同模型在长程任务上的通过率。
- 课题复现:以开放数据集与权重为基线,改动记忆机制后做对照实验。
- 流程梳理:把客服或运营反复手点的操作录成任务,评估哪些环节可交给智能体。
适用人群:适合做手机端智能体研究的团队与实验室,以及需要评估界面自动化可行性的测试团队;只处理单页操作、或对真机环境没有掌控力的场合,用成熟的自动化脚本更直接。
MemGUI-Agent 的使用方法
官方给了两条路:直接拉权重做推理验证,或用仓库代码复现训练与评测。安装与环境说明见 官方仓库。
拉权重做推理:先在少数任务上看表现
- 按项目页说明准备好安卓设备或模拟器,确认能通过调试接口截图与点击。
- 下载开放的 8B 微调权重,按文档配置推理服务地址。
- 挑三到五条长程任务跑一遍,记录步数、失败位置与耗时。
- 把失败样本按「记忆缺失」「识别错误」「点击偏移」分类,再决定是否改机制。
复现训练与评测:从数据集开始
- 拉取 MemGUI-3K 数据集,核对字段与仓库脚本的读取路径。
- 按训练入口配置并行与环境,先用小样本验证一轮训练能启动。
- 用 MemGUI-Bench 跑评测,和 README 里的通过率对齐,确认复现链路没问题。
- 改动记忆策略后再跑同一套评测,比较通过率与平均步数的变化。
入场成本主要在设备侧:真机或模拟器的稳定性决定实验能不能重复,截图与点击接口的延迟也会影响步数统计。站内的 LongCat-2.5 Preview 从模型侧解决长程推理,可与记忆机制对照着评估。
MemGUI-Agent 的项目地址
- 项目主页:https://memgui-agent.github.io/
- GitHub 主仓库:https://github.com/kwai/MemGUI-Agent
MemGUI-Agent 的价格与开源情况
代码与权重按 Apache-2.0 分发,不收费,也没有商业授权档位。训练与推理的开销全在自己这侧,GPU 与真机环境需要自备,商用允许,保留许可与版权声明即可。
数据集与基准同样公开,复现时不产生授权费用。需要注意的是评测成本并不低:真机农场或模拟器集群的机时,往往比训练本身更贵,做长期实验前先把设备预算算清楚。
MemGUI-Agent 的常见问题
和普通 GUI 智能体差别在哪
差别在上下文管理。它把历史界面与操作压缩成可复用记忆,长任务里不容易丢失最初目标,也不至于把窗口塞满。
需要什么样的设备环境
需要安卓真机或模拟器,并能通过调试接口完成截图与点击;设备稳定性直接影响评测结果能否复现。
能直接商用吗
代码与权重按 Apache-2.0 分发,允许商用与改造,保留许可与版权声明即可,训练与算力成本自行承担。
开放的 8B 权重够用吗
README 给出的 8B 微调版本通过率明显低于 235B 版本,适合做基线与机制验证,正式场景仍要看更大模型或自有数据微调。
相关文章


 浙公网安备33010202004812号