

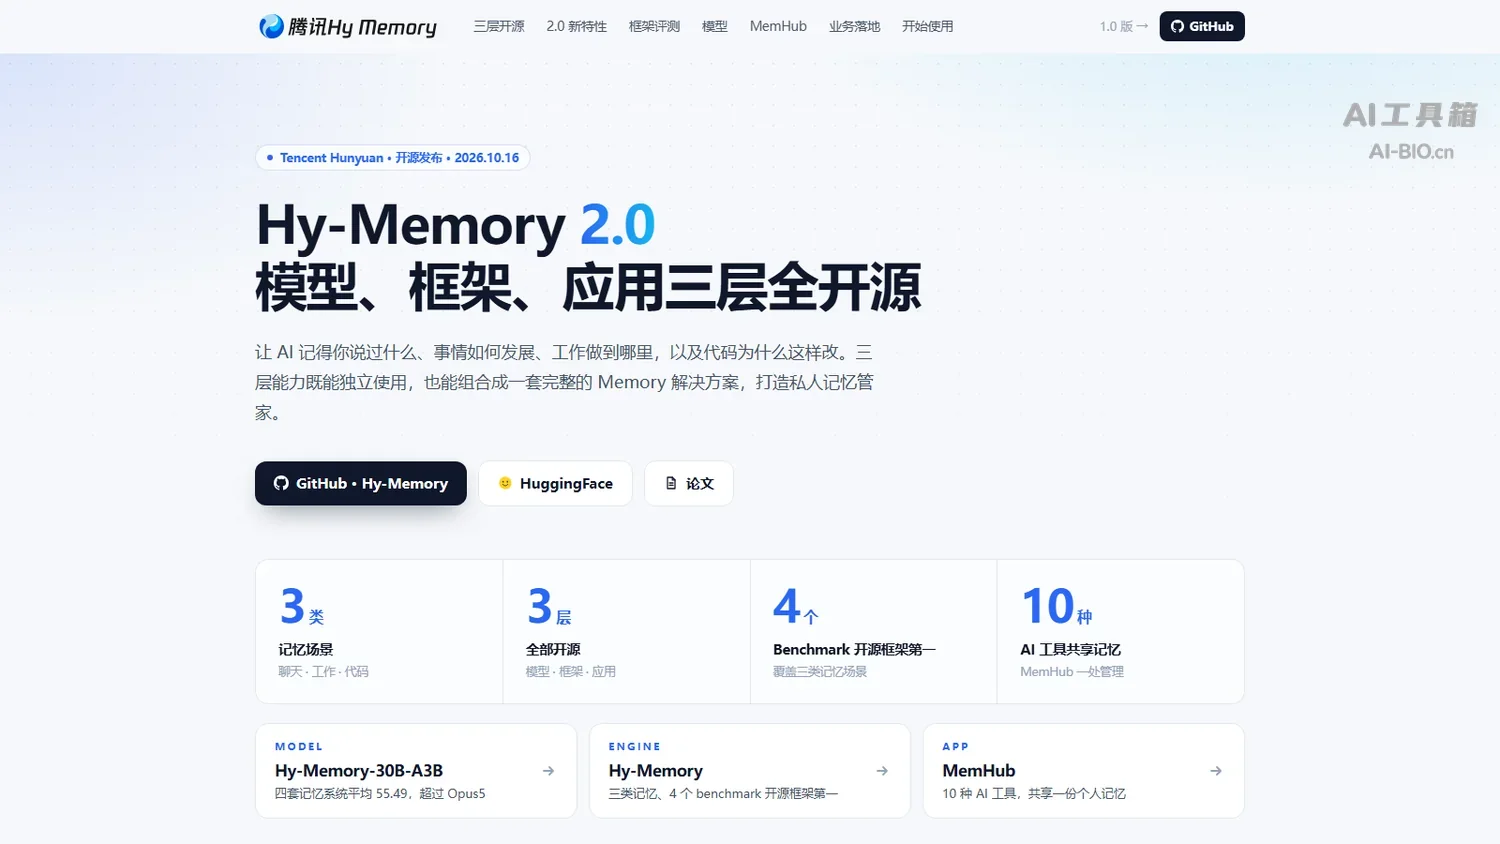
Hy-Memory 2.0是腾讯混元于2026年10月推出的面向 AI 智能体的三层记忆框架,由专用记忆模型、记忆框架与 MemHub 本地应用组成,支持聊天、工作、代码三类记忆的写入与检索,适用于长期偏好延续、跨会话任务接续与代码版本回溯等场景。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 面向 AI 智能体的三层记忆方案 |
| 出品方 | 腾讯混元 |
| 发布时间 | 2026年10月16日 |
| 三层构成 | 模型、框架与 MemHub 应用 |
| 记忆场景 | 聊天、工作、代码 |
| 运行模式 | lite、pro、ultra |
| 开源许可 | Apache-2.0 |
| 计费方式 | 开源免费,成本来自模型调用 |
| 存储后端 | ChromaDB、Qdrant、FAISS、Kuzu |
| 接入方式 | Python SDK、MCP 插件、桌面端 |
Hy-Memory 2.0 的核心能力
Hy Memory 按任务类型拆出三条记忆流水线,写入与检索先经场景路由再进入对应管线,管线之上还有由 evolve() 触发的 System 2 演化层,与 AI智能体 的上下文管理直接相关。
聊天记忆按八层组织
聊天记忆从原始对话逐层抽象,官方层级为 L0 基础信息、L1 原始对话(只追加)、L2 原子事实(带版本、不可改)、L3 会话摘要、L6 心智模型与 L7 前瞻意图,L4 与 L5 为预留位。原子事实独立版本化后新旧说法不会互相覆盖;前瞻意图带过期时间,过期即降级为普通事实。
多跳问答时,框架先合并重复信息、剥离前后冲突,再把整理后的记忆交给模型。
工作记忆拆成事实与经验两层
工作场景按会话产出两层记忆:事实层每次会话固定写 1 条,记录任务、做法与结果,含陈述、主体、涉及文件;经验层写 0 到 N 条,只有通过价值阈值的方法才留下,含检索键、解法、适用环境与置信度。
两层双向关联:事实记下 derived_experience_ids,经验回指 source_fact_ids;被推翻的旧事实经 fact_chain_summary 保留可追溯记录。复用经验前会先判断当前环境是否落在适用条件内。
代码记忆附带版本演进链
代码场景与工作场景共用同一套双层管线,差别有三处:抽取规范换成软件工程口径,记录文件、函数、分支等坐标而不粘贴代码;数据写入独立的 coding_memory_cv.db,与工作记忆隔离;额外挂一条版本演进链。
演进链补的是摘要必然丢失的信息:某次改动被回滚后,该版本既不在事实里,也不在工作树或 HEAD 上。链条把每个版本的 diff 原样存下且不消耗大模型调用;它不是检索器而是装饰器,只在每条事实下挂出该代码的全部修订。来源支持本地 Git diff(设置 MEMORY_CODING_CHAIN_REPO_ROOT)或轨迹中的确定性替换。
三种运行模式与多后端存储
运行模式决定调用成本:lite 只做原始向量的写入与检索,不调用大模型,场景与层级参数被忽略,等价于常规 RAG;pro 增加抽取与冲突合并,为默认档;ultra 再加 schema 归纳与跨领域扫描,图谱存储常开。
存储可替换:向量库默认 ChromaDB,另支持 Qdrant 与 FAISS;图存储默认 Kuzu,可换 Neo4j。接入只需一个兼容 OpenAI 协议的模型端点与一个 embedding 端点,两者可分别指定。
Hy-Memory 2.0 与同类记忆框架的对比
记忆框架已出现多条实现路线,把 Hy-Memory 2.0 与官方列为对照对象的两个项目并列,可以看清形态差异。
| 对比维度 | Hy-Memory 2.0 | Mem0 | MemOS |
|---|---|---|---|
| 产品定位 | 三层开源记忆方案 | AI Agent 的记忆层 | 自进化记忆操作系统 |
| 交付构成 | SDK、记忆模型与桌面应用 | 记忆层 SDK 与托管服务 | 记忆操作系统与云服务 |
| 代码任务解决率 | 28.3% | 25.3% | 25.3% |
| 开源许可 | Apache-2.0 | Apache-2.0 | Apache-2.0 |
| 接入方式 | Python SDK 与 MCP 插件 | REST API 与多语言 SDK | SDK 与云平台 |
| GitHub 星标 | 923 | 67,441 | 11,934 |
上表数值取自腾讯混元官方发布页与 Mem0、MemOS 各自仓库页,核查于 2026 年 10 月 19 日。产品定位上,两个对照项目都是可嵌入的记忆层组件,Hy-Memory 2.0 是含模型、框架与桌面端的三层方案。交付构成决定落地成本:多出的本地应用让不写代码的用户也能直接用,另两家需要自行搭服务端。接入方式上,三者都以 SDK 起步,它额外提供一个跨工具的桌面入口。
字节火山引擎开源的 OpenViking 走另一条路线:把 Agent 上下文按数据库组织与检索,适合已有自建框架、只补一层上下文管理的团队。
Hy-Memory 2.0 的应用场景与适用人群
三类记忆各自对应一批明确的日常任务,下面按场景说明它能解决什么。
- 长期个人助手:跨天跨会话记住关注方向与分析习惯,方向调整后旧偏好归档但可追溯,助手不会把已放弃的板块推回来。
- 生产力任务接续:把文档处理与调研过程记成事实与经验,同类任务再来时先取回可复用做法。
- 代码协作与回溯:在 Cursor 这类编辑器里记录改动涉及的文件与函数坐标,并保留被回滚版本的 diff,排查回归时能读到当时真实改动。
适用人群:需要为自研 Agent 补长期记忆的开发者、同时使用多个 AI 编程与办公工具的工程师,以及希望在本地统一管理会话记忆的重度用户。
Hy-Memory 2.0 的使用方法
产品提供两条使用路径:不想写代码的用户直接用 MemHub 桌面端与命令行,开发者通过 Python SDK 把记忆能力接进自己的 Agent。
普通用户入口
MemHub 是本地优先的记忆管理应用,桌面端与命令行共用同一运行时与数据目录。
- 获取安装包:从 Hy Memory 官网 下载 macOS 签名版,或以
memhub-cli在 Linux 装运行时。 - 启动服务:执行
memhub install下载受管运行时,再用memhub start启动。 - 授权并汇总:逐个授权 AI 工具,历史会话导入为本地记忆,新会话此后实时汇入同一份记忆。
开发者接入
SDK 以 pip 包分发,核心依赖已含 ChromaDB 与 Kuzu,其他后端按需加装。
- 安装依赖:执行
pip install hy-memory==2.0.3,换向量库改用对应 extras,例如hy-memory[qdrant]。 - 配置端点:设置
MEMORY_LLM_BASE_URL、MEMORY_LLM_MODEL与 embedding 变量,兼容 OpenAI 协议即可。 - 创建客户端:调用
HyMemoryClient(mode="pro"),按需切换 lite 或 ultra。 - 写入与检索:用
client.add()写入,工作与代码场景需附工具轨迹并指定 scene;用client.search()取回事实、经验与代码链块。 - 触发演化:ultra 模式下调用
client.evolve()执行 schema 归纳。
Hy-Memory 2.0 的项目地址
- 项目官网:https://memory.hunyuan.tencent.com/
- GitHub 主仓库:https://github.com/Tencent-Hunyuan/Hy-Memory
Hy-Memory 2.0 的价格方案
Hy-Memory 2.0 的软件与模型权重都不收费:框架与 MemHub 以 Apache-2.0 开源,SDK 通过 PyPI 发布,专用模型 Hy-Memory-30B-A3B 在 Hugging Face 以同一协议开放下载,无订阅档位。
支出集中在外部依赖:抽取调用所配置的大模型,写入与检索调用 embedding 服务,各按服务商刊例计费;本地向量库与 SQLite 不产生费用。成本敏感时把模式切到 lite,该模式不发起大模型调用。
Hy-Memory 2.0 的常见问题
Hy-Memory 2.0 要花钱吗
不收费。框架、MemHub 与模型权重均为 Apache-2.0 开源,费用只来自你自行接入的大模型与 embedding 服务。
不接大模型能用吗
可以。轻量模式只做向量写入与检索,不发起任何大模型调用,等价于常规的向量检索方案,只是不再自动抽取事实与经验。
MemHub 能接哪些 AI 工具
官方给出的清单覆盖 Cursor、Codex、Qwen Code、OpenCode、Claude Code 等 10 种工具,会话导入后统一存进本地数据目录。
代码记忆会存整段源码吗
不会。事实层记录文件、函数、分支等坐标,代码内容由版本演进链以 diff 形式保存,避免把源码整段写进记忆条目。
相关文章


 浙公网安备33010202004812号