
SkillOpt 是微软研究院于 2026 年 5 月推出的文本空间技能优化器,主要用于把 Agent 的技能文档训练成稳定可复现的版本,支持轨迹驱动的有界改写与验证集门控,适用于技能文档反复返工、跨模型迁移技能与多执行环境统一配置等场景。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | Agent 技能文档优化器 |
| 出品方 | 微软研究院 |
| 发布时间 | 2026 年 5 月 8 日 |
| 首个发行版 | v0.1.0(2026 年 6 月 2 日) |
| 开源协议 | MIT |
| 运行方式 | 命令行 + 可选 WebUI |
| 支持后端 | OpenAI、Azure、Qwen、MiniMax |
| Claude 接入 | Claude Code CLI,非 API 直连 |
| 内置基准 | 六个 |
| 部署产物 | best_skill.md(约 300–2,000 tokens) |
| 推理开销 | 部署后零额外模型调用 |
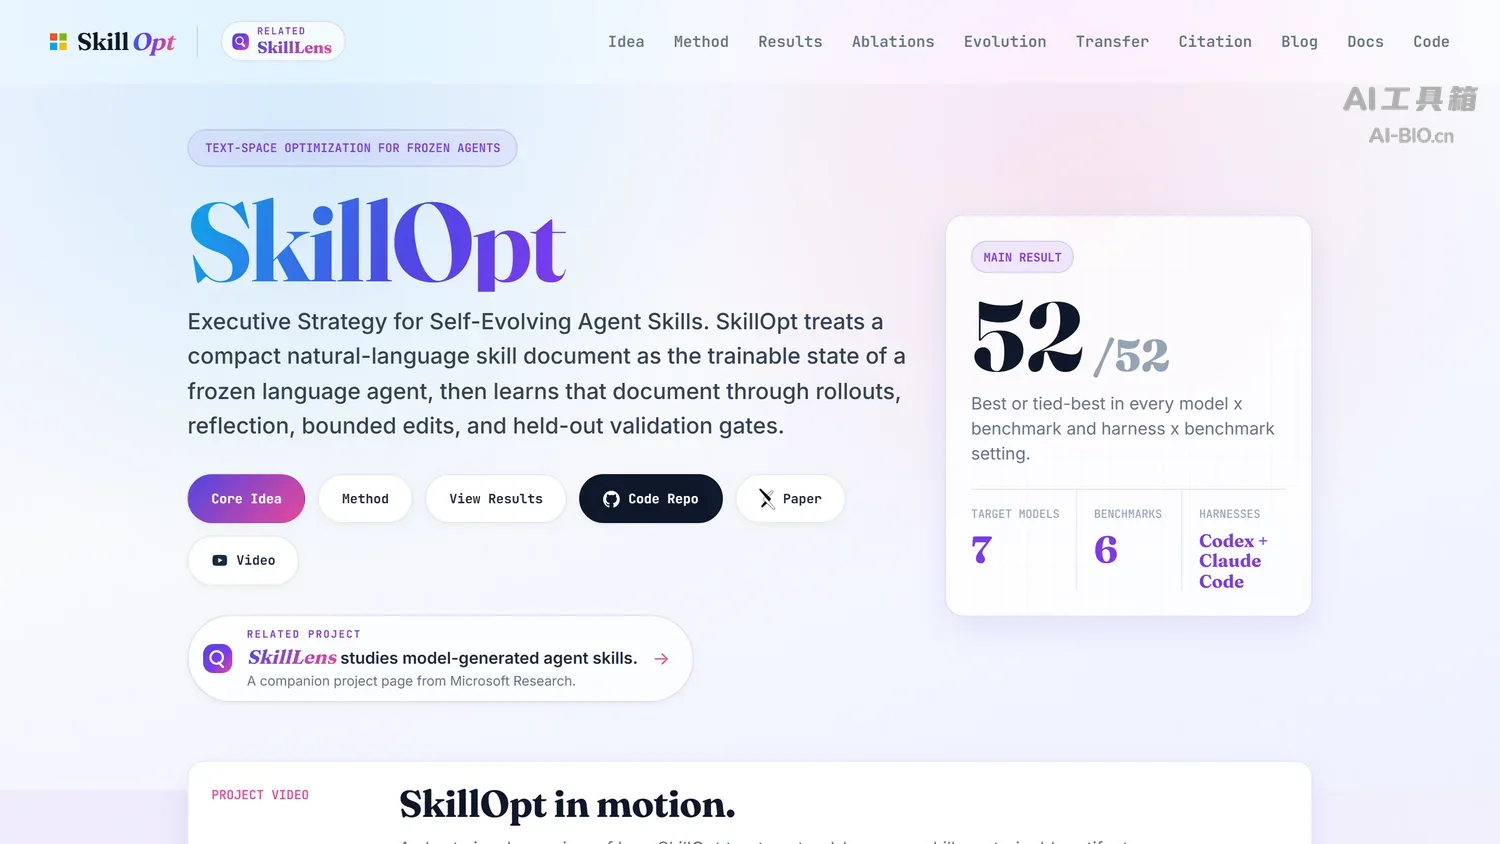
SkillOpt 的核心能力
它要解决的是「技能文档写完就没人敢动」:改一个字有没有用,过去只能靠感觉。站内的 ffmpeg-skill 是典型技能包,正是它的处理对象。
把技能文档当可训练状态
整份 skill.md 是训练对象,目标模型全程冻结,调的不是权重而是那段自然语言;轮次、批大小、学习率这套纪律随之搬到了文本上。
轨迹驱动的有界改写
先把带评分的执行轨迹收集起来,由独立的优化器模型转成「增、删、改」三类编辑;每次编辑有幅度上限,对应文本学习率,避免一次改写推翻整份文档。
验证集门控与拒改缓冲
默认研究配置下,候选编辑只有在留出验证集上严格变好才会被接受,被拒的进缓冲区,避免同一处来回改;门控关掉则强制接受。这是把「调提示词」变成可复现流程的关键一步。
轮次间的慢更新
除了单步编辑,每轮结束还有慢更新与元更新,把跨轮次稳定的经验沉淀下来。官方另配 cosine、linear、constant 三种学习率调度,控制跨轮改动幅度,降低反复改写的退化。
部署零推理开销
训完交出的是一份压缩技能文件,跑在原模型上,推理时不多一次模型调用,也不需要额外的检索或路由层;成本集中在离线训练,线上链路不变。想横向对比推理侧框架的部署开销,站内的 DeepInfer 可作对照。
跨模型与跨环境迁移
官方实验显示,优化后的技能在跨模型规模、Codex 与 Claude Code 两套执行环境、相近基准上都能不重新优化继续生效;但效果取决于目标模型与任务。对同时维护多个 Agent 的团队,省的是重复劳动。
SkillOpt 与 DSPy 的对比
SkillOpt 只改文本,目标模型全程冻结;DSPy 优化程序里的提示、示例与执行策略,部分优化器还能微调权重。下表按可核实的结构项并列。
| 对比维度 | SkillOpt | DSPy |
|---|---|---|
| 出品方 | 微软研究院 | 斯坦福 NLP 团队 |
| 优化对象 | Agent 技能文档(skill.md) | 程序的提示、示例与执行策略 |
| 优化信号 | 带评分的执行轨迹 | 用户定义的指标与训练样例 |
| 改写约束 | 文本学习率限定改动幅度 | 由优化器自动搜索组合 |
| 验证机制 | 留出验证集门控,严格变好才接受 | 按指标挑最优程序 |
| 部署产物 | 单份 best_skill.md | 编译后的程序与提示 |
| 开源协议 | MIT | MIT |
| 推理开销 | 零额外模型调用 | 取决于编译出的程序结构 |
差别在三处。优化对象:SkillOpt 只管一份技能文档,改动面小,适合已有 Agent 提稳定性;DSPy 改整段程序的提示与示例,表达力更强,接入成本更高。验证机制:两边都靠数据挑结果,SkillOpt 多一道「不如原来就不改」的硬门。部署产物:一份 markdown 与一段编译程序,前者便于人审,后者便于流水线复用。
另外:技能文档写给人也看,SkillOpt 产物天然可读;提示程序可读性次要,指标优先。两者能叠着用,先用 DSPy 定骨架,再用 SkillOpt 打磨那段技能说明。
站内的 ffmpeg-skill(给 AI 编程助手装上视频剪辑能力的开源技能)就是一份典型的技能文档。
SkillOpt 的应用场景与适用人群
它的价值出现在「技能文档要长期维护」的地方;一次性任务、写完不再动的场景,训练成本收不回来。想把技能落到网页端,站内的 Page Agent 是另一类载体;想跑在终端里,站内的 Pi 是配套执行环境:
- 技能文档反复返工:改一版掉一批用例,靠它把每次改动变成可验证实验。
- 多模型共用一套技能:同一份文档要给不同模型用,用它做迁移与对齐。
- 跨执行环境统一:Codex 与 Claude Code 两边跑同一套流程,减少分叉维护。
- 团队交接:技能版本带验证记录,交接时能说清哪一版在什么条件下更稳。
- 基准化对比:换模型、换框架时用它当控制变量,判断提升来自模型还是文档。
适用人群:适合在生产环境维护 Agent 技能、手里有可评分任务集的团队,也适合做 Agent 平台、要给用户交付稳定技能包的厂商;只有一两个脚本、没有评测集的,先手工写清文档更划算。
SkillOpt 的使用方法
四条路:pip 装命令行最快,WebUI 看训练曲线直观,接自有后端与基准用于落地,取用 best_skill.md 最轻。文档见 官方文档。
命令行:装好后完成一轮完整训练回路
- 执行
pip install skillopt安装包,Python 需 3.10 以上。 - 准备初始技能文档与可评分任务集,按官方格式拆训练与验证两部分。
- 配好目标模型与优化器模型的后端与密钥,跑
python scripts/train.py --config configs/searchqa/default.yaml完成一轮,看评分是否上升。 - 训练后取
best_skill.md,在未参与训练的题目上复核成绩。
WebUI:看训练过程与拒改记录
- 先克隆仓库并 cd 进目录,再执行
pip install -e ".[webui]"——-e指向当前目录,在别处执行会失败。 - 执行
python -m skillopt_webui.app启动界面,导入技能文档与任务集。 - 在面板里看评分曲线与被拒编辑,判断学习率是否设得过大。
接自有后端与自有基准
- 服务若兼容 OpenAI Chat Completions,直接用
openai_compatible(v0.2.0后提供)填地址与密钥,不必写适配层;否则按 README 示例实现。 - 按基准接口实现评分函数,保证同一批任务的判分脚本固定不变。
- 先用内置基准对齐结果,再换到自有任务上,避免把适配错误误判成效果差异。
最轻用法:只取优化好的技能文件
- 在官方仓库找与自家场景接近的
best_skill.md。 - 读一遍再落地,重点看它删掉了哪些多余步骤。
- 在自己的任务集上跑对照实验,确认提升真实存在。
两点注意:训练集与验证集必须分开,既训又验,分数会失真;技能文档是给人也看的,自动改动后建议人工过一遍。另有一条路是「让 Agent 自己改自己」,站内的 Prime Agent 就是自我改进型长周期智能体的做法。
SkillOpt 的项目地址
- 项目主页:https://microsoft.github.io/SkillOpt/
- GitHub 主仓库:https://github.com/microsoft/SkillOpt
SkillOpt 的价格方案
代码按 MIT 开源,PyPI 包与 WebUI 不收费,官方目前也没列出订阅与企业版。商用与二次开发都允许,改动后不强制开源,保留版权声明即可。
实际支出在训练阶段:每一轮都要跑 rollout,目标模型与优化器模型两边都按 token 计费;验证阶段的调用量取决于任务集大小。用本地模型或开源后端能把成本压得很低,用商业 API 要先估一轮调用量再定轮次。这类「改了但没变好」的投入产出问题,站内《AI 让代码多了三成,交付却没多》有更细的观察。
SkillOpt 的常见问题
SkillOpt 会改我的模型吗
不会。目标模型全程冻结,训练对象是那份技能文档,最后交付的是一份 markdown 文件。
部署后会不会变慢
不额外增加调用。技能文档只是提示的一部分,原有流程不变;但文档变长会占上下文,耗时仍看模型与长度。
需要准备多少数据
官方没给固定门槛,但需要有可评分的任务集,并留出一部分做验证。数据量不足时,验证门控会频繁拒改,训练收益有限。
支持哪些模型后端
OpenAI、Azure、Qwen、MiniMax 走原生接口,Claude 走 Claude Code CLI,兼容服务用 openai_compatible。
优化出来的技能能跨模型用吗
官方实验显示可以,跨模型规模与 Codex、Claude Code 两套环境都能迁移,但换模型后建议在自有任务集复核。
相关文章

 浙公网安备33010202004812号