
老高AI观察 · 第29期|2026 年 10 月 14 日
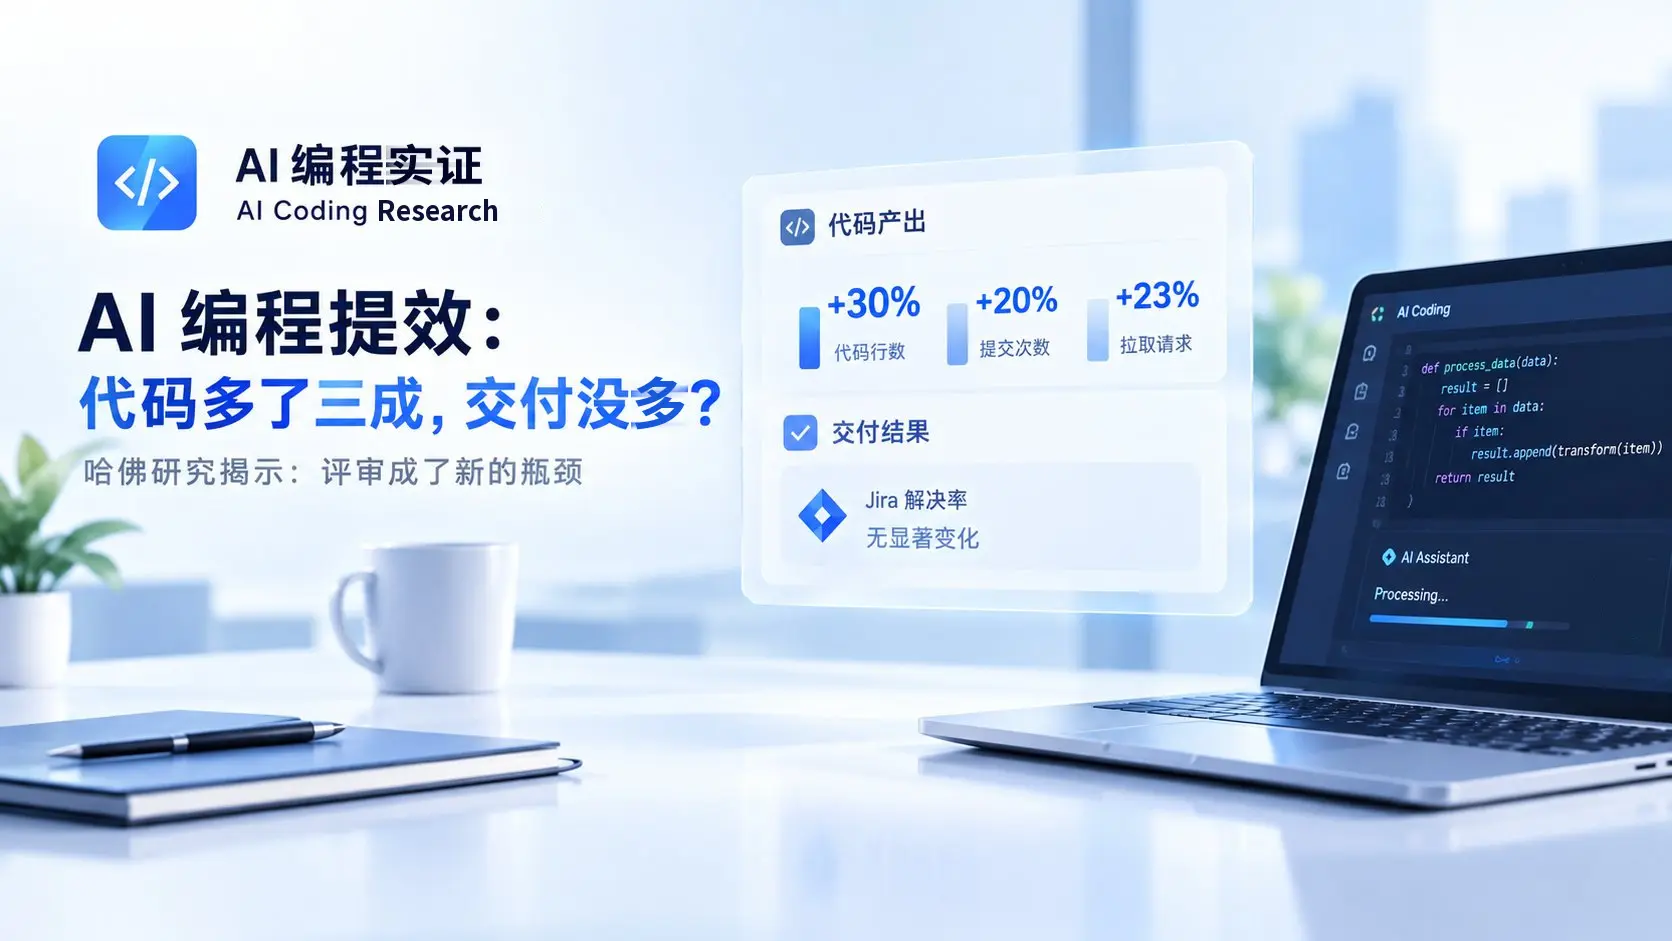
过去两年,关于 AI 编程的讨论几乎都在比同一件事:谁写得更快。但 10 月上旬被广泛转引的一份哈佛工作论文,把镜头往后挪了一格——它看的不是代码怎么写出来,而是代码交出去以后,变成了多少软件。结论有点拧巴:用上 AI 编程智能体之后,代码行数多了三成,提交和拉取请求也跟着涨,可 Jira 里问题和 EPIC 的解决率,没有出现统计上说得清的变化。多出来的产出没有消失,它堆在了下一道人工闸门上。这件事的价值,在于它换了个问法:你拿哪个数字当效率,决定了这笔账算得对不对。
718 家公司,多写了三成代码
论文由哈佛的 Fiona Chen 与 James Stratton 完成,当前版本定于 2026 年 8 月 4 日,初版是今年 1 月(论文全文)。数据来自工程效能平台 Jellyfish 的聚合记录:覆盖 718 家软件公司、70 万多名员工、约 3 亿条工作事件,时间从 2021 年 1 月到 2026 年 3 月。
记录里包含 GitHub 的代码活动、Jira 的任务进度、日历里的时间分配。研究者用交错双重差分,拿不同公司采用 AI 的时间点做对照,把「本来就在变快」和「因为 AI 才变快」尽量分开。
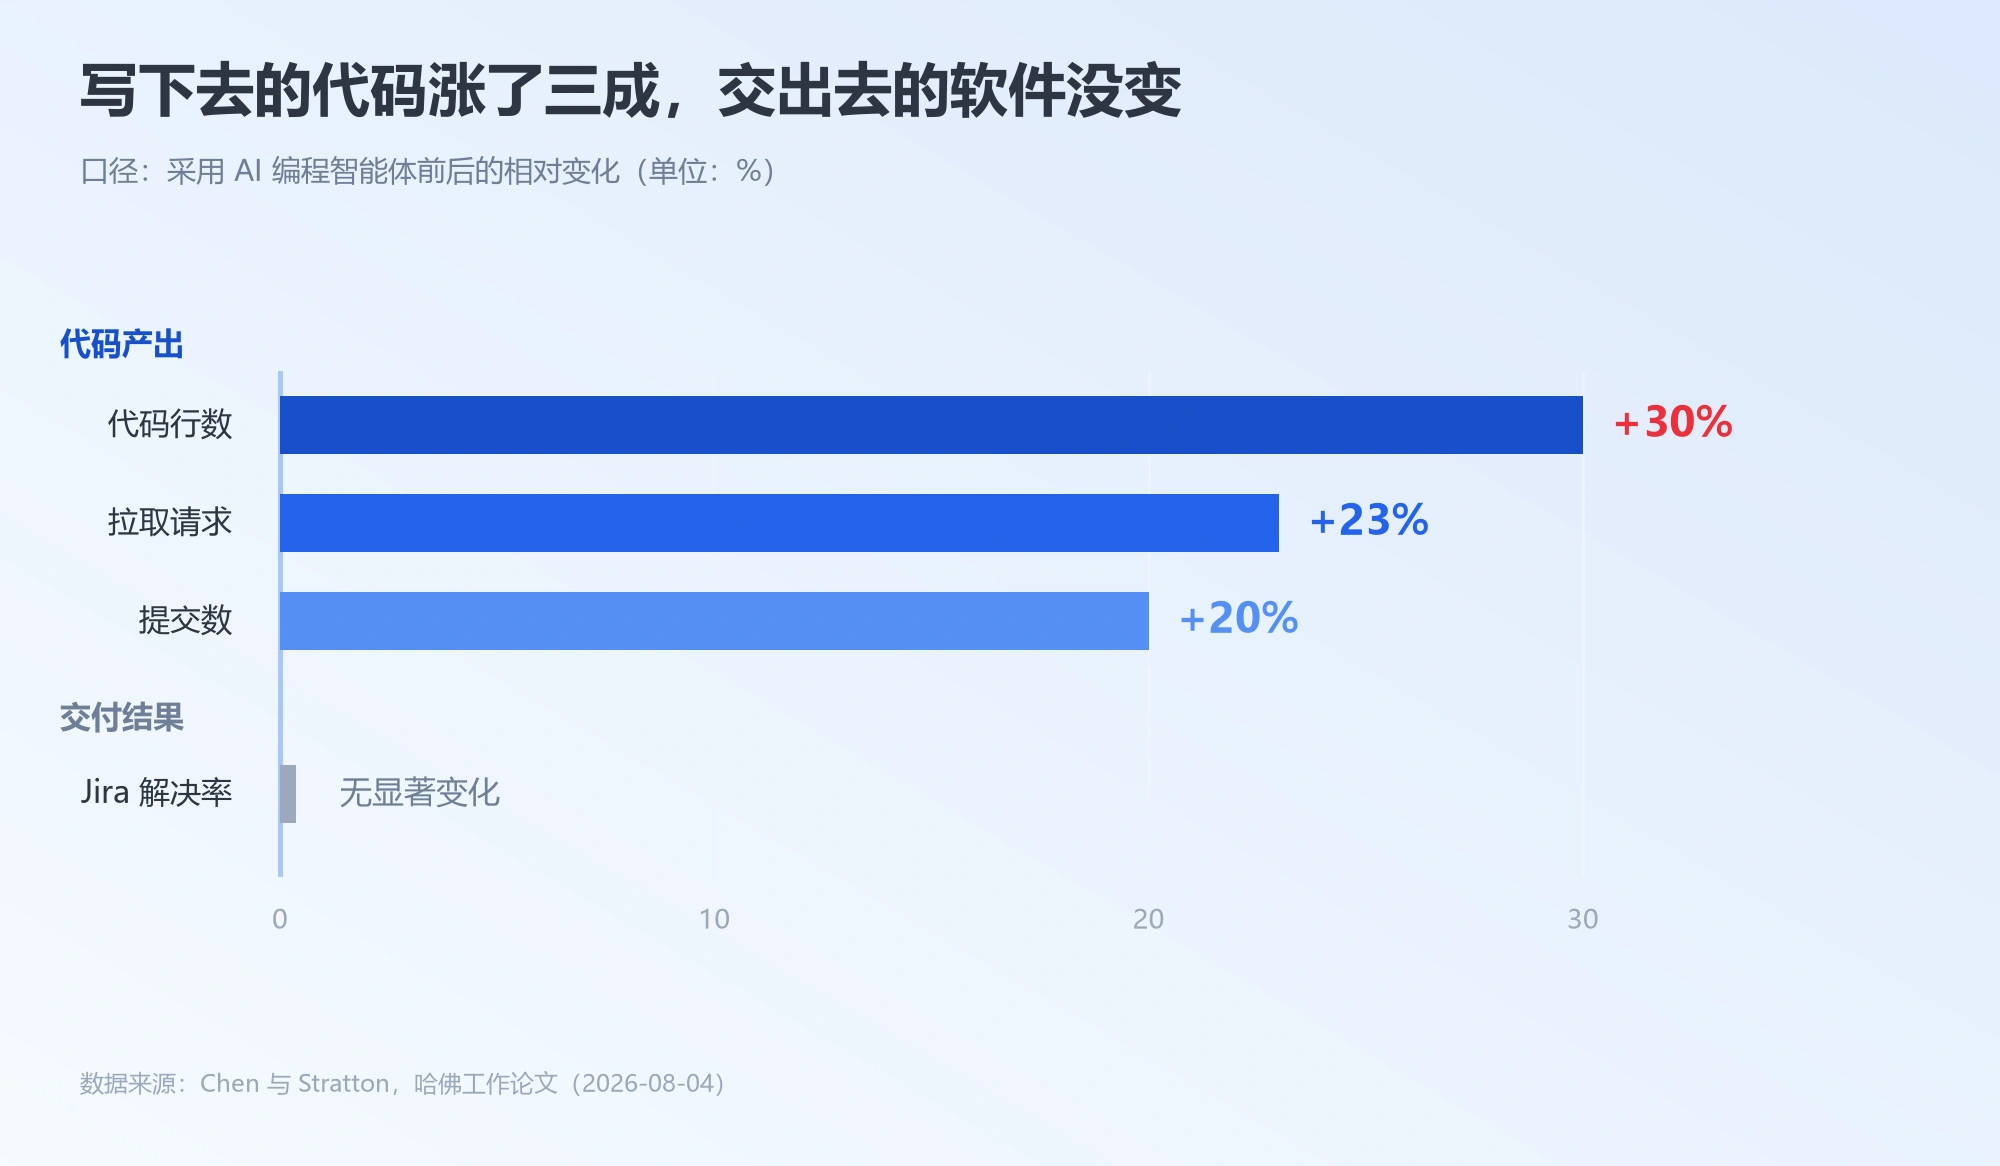
结果分成两半,落差很大。采用 AI 编程智能体后,人均代码行数涨了 30%(每人每月多写约 1500 行)、提交涨 20%、拉取请求涨 23%;只做补全的助手类工具,对应数字是 12%%、9%% 和 5%%,只有提交数显著。
另一半是交付端。Jira 里 Issue 和 EPIC 的解决率,采用 AI 之后没有统计上显著的变化;任务的规模与复杂度分布也没出现结构性位移——不是团队改做了更简单的活儿。论文原文说得很直白:生产率提升并没有完整传递到软件产出或用工上(Ars Technica 10 月 9 日报道)。
这条线的起点比看上去更早
论文只是把一条早已存在的裂缝摆到了台面上。过去两年,衡量 AI 编程用的几乎都是「写得快不快」这类中间指标:补全接受率、代码行数、提交频次——好拿、好展示,也正是供应商最愿意摆出来的。
时间线也耐看。AI 编程智能体的公司采用率,从 2024 年末的接近于零,爬到 2026 年初的 95%%(论文口径)。真正的规模化铺开就发生在过去一年多,采购决策和席位预算大多在这段时间拍板。
它不是孤例。同期一份 NBER 工作论文(编号 35275)用 50 多万名开发者的数据得出同向结论:累计提交量提升,自动补全约 30%、交互式智能体约 180%、自主智能体约 240%;但一路下探,到项目只剩约 80%,到发布版本只剩约 30%。两套方法指向同一个点:增量集中在上游,而下游收得住。这也和往期 AI 岗位暴增 789%,工时却没少 是同一条线的两端。
多写的三成,堵在评审口
论文把落差追溯到了同一个环节:代码评审。采用 AI 智能体后,拉取请求从提交到合并的平均时长涨了 49%(按论文口径约多出 3.45 天);被要求返工的 PR 占比从 13% 涨到 25%,差不多翻倍;每条 PR 的评论数涨 35%;参与评审的员工占比涨了 14%。
逻辑不难理解:写得越快,往下游送的东西越多,而评审这一环的产能没有跟着长。一位受访的资深工程师说得很干脆——一次只有一个瓶颈,写代码快了,瓶颈就挪到别处。往期 DeepSeek 把编程智能体搬上桌面 写的是智能体接手长任务:那一层问「谁来干」,这一层问「谁来验」。
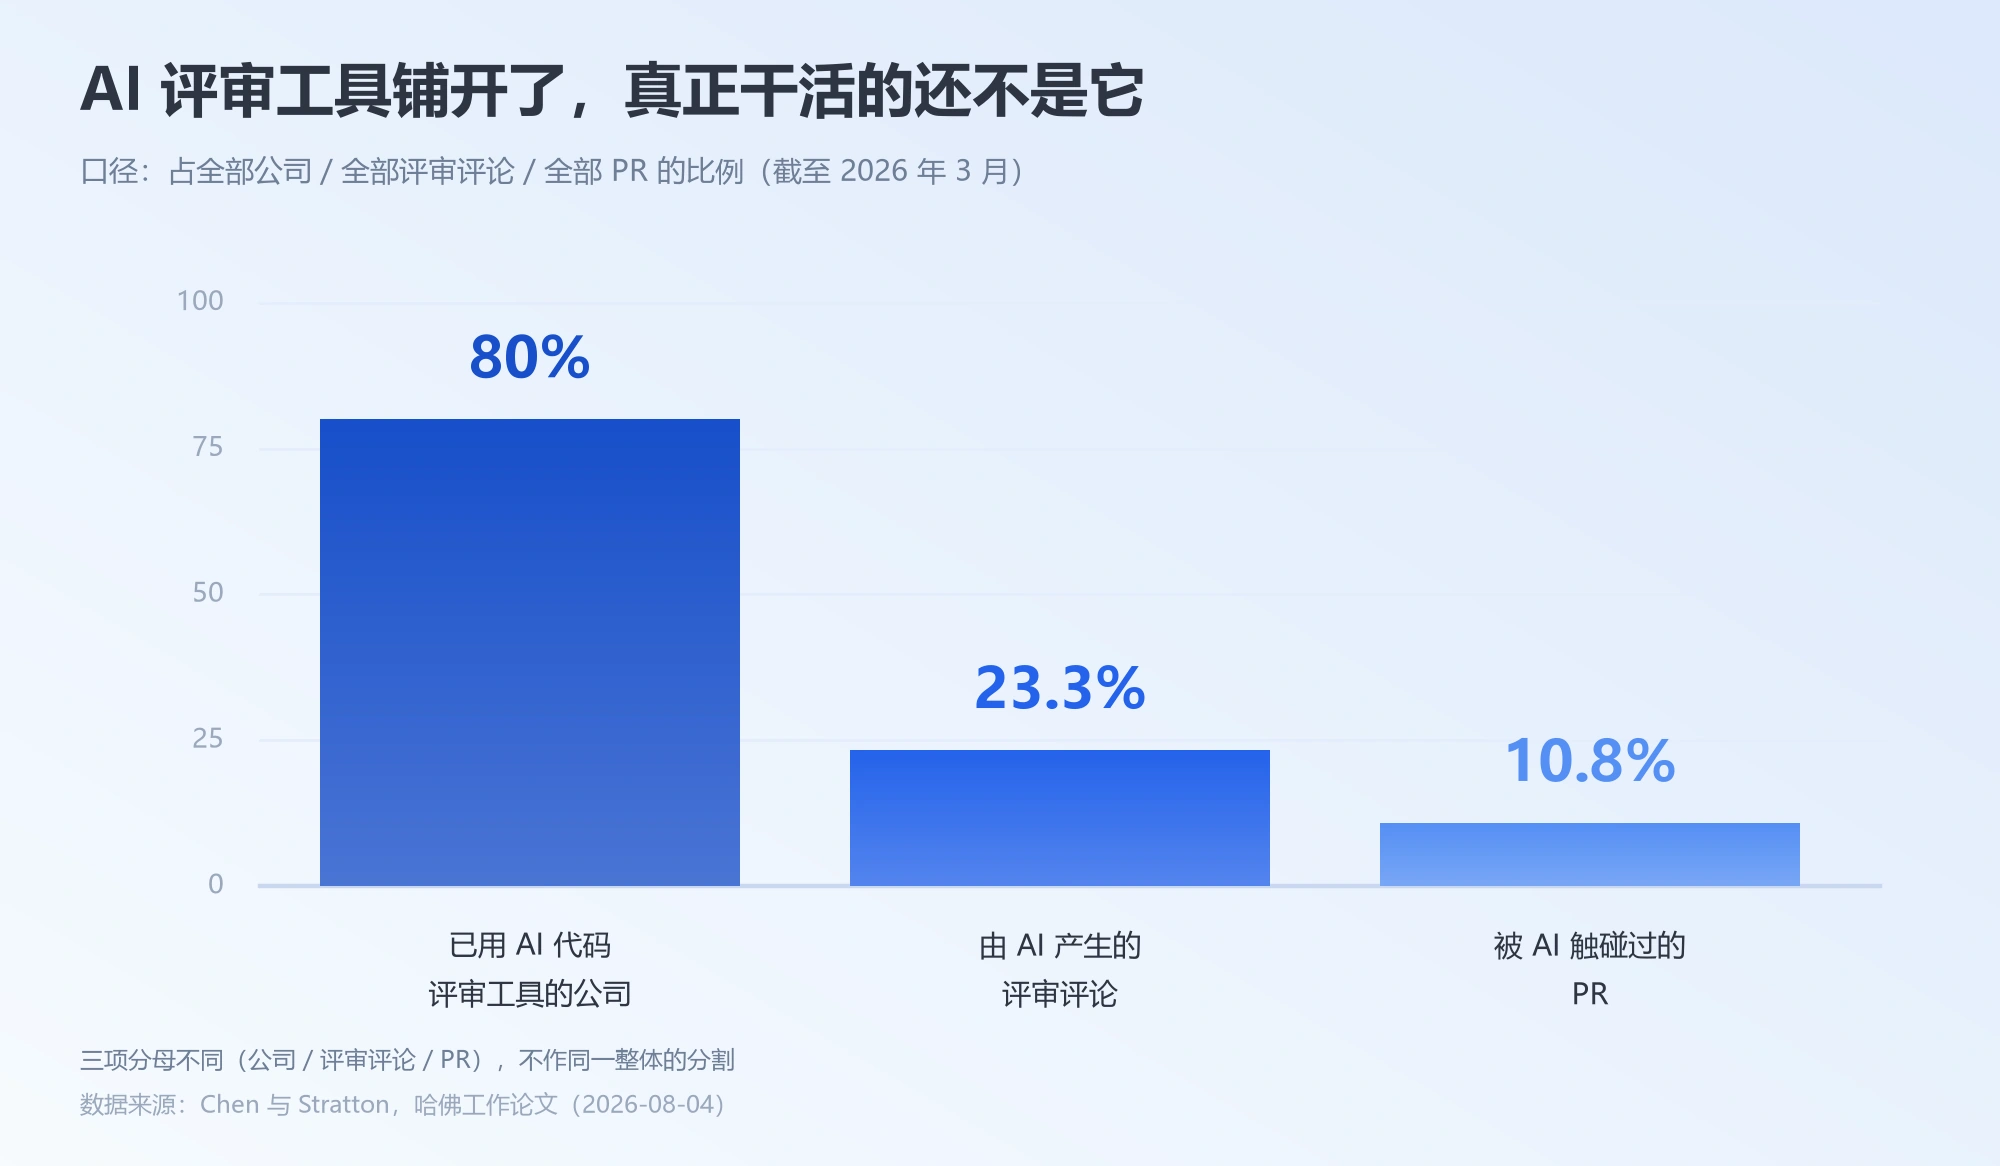
更值得留意的是,AI 暂时没接住这一棒。到 2026 年 3 月,样本里约 80% 的公司在用某种 AI 代码评审工具,但真正由 AI 产生的评审评论只占 23.3%,被 AI 触碰过的 PR 只占 10.8%。最终放行签字还是握在人手里。站内收录的 Cursor 的多智能体编排 这类工具,也更多在编排「谁去改」,而不是替人判断「放不放行」。
被改写的角色有哪几个
先说影响不大的。如果你只是偶尔让 AI 帮自己写几段脚本、补几条函数,这件事跟你关系有限——你既是作者也是评审,多写的代码自己看完就行。
真正要重算的是两类角色。一类是靠「写得多」证明价值的人:当代码行数、提交频次可以被工具轻易拉高,它们就不再是有区分度的业绩证明,能说明问题的只剩「交出去、并且没被退回来」的那部分。
另一类是做 AI 工具生意的人。如果采购逻辑还停在「多买一个席位,就多一份产出」,这份研究正好戳在这个假设上。想先摸清这类产品实际的手感,可参考 Claude Code(Anthropic 推出的命令行编程智能体,能在项目目录里直接读写文件);同类的还有 Mellum2.1(JetBrains 的开源编程智能体模型)。

什么情况会证明我想错了
第一,数据截止在 2026 年 3 月,到现在已经过去半年多。这半年里编程智能体的能力跳了一档。如果新一轮数据里评审时长回落、交付抬头,我今天这套判断就得往回收。
第二,论文把「交付」折算成 Jira 里 Issue 和 EPIC 的解决率,这是个代理指标——功能被标记为完成,和它真的产生价值之间还有距离。第三,这是观察性研究而非随机对照实验,排不干净干扰。第四,Jellyfish 的客户以中大型工程团队为主,小团队未必如此。
现在能动手的几件事
一,先给自己的账本换个分母。别只统计写了多少行、提交了多少次,把「从提交到合并的时长」和「被退回重改的比例」也记上。
二,把评审能力当成要买的资源。既然瓶颈在下游,加席位之前先问一句:多出来的提交,谁来验?先算评审,再算席位,顺序反了就是给自己排队。
三,做工具选型时,把「产出可评审性」加进评估表——同样写代码,改动拆得清楚、diff 好读的工具,能省下不少评审精力。站内收录的 TRAE 编程(字节面向中文开发者的 AI 编程工具)可以一并放进清单。这条线的后续,我会记在 老高AI观察 里。
我把判断放这儿
我的判断是:AI 编程提效这件事,眼下卡住的不是写,是验;在你把评审能力算清楚之前,多买的每一个席位,都只是在给评审队列加班。
关于AI编程提效,集中答三个问题
这份研究的数据从哪来?
来自工程效能平台 Jellyfish,覆盖 718 家公司、70 万余名员工、约 3 亿条工作事件,时间从 2021 年 1 月到 2026 年 3 月。
为什么代码多了三成,交付却没多?
增量被下游的代码评审吸收了——评审时长涨 49%、返工比例从 13% 接近翻倍到 25%,而评审产能没有同步增长。
那 AI 编程工具还值得用吗?
值得,但要换个算法。若只按代码量或席位数量算投入产出,容易高估收益;把评审能力和交付周期一起算,结论更接近真实。
本文依据
- Fiona Chen、James Stratton《Bottlenecks in Software Production》,哈佛大学工作论文,当前版本 2026-08-04、初版 2026-01-07
- 同论文数据:718 家公司、70 万余名员工、约 3 亿条工作事件(2021-01 至 2026-03);80% 公司已用 AI 评审工具,但 AI 仅产生 23.3% 的评审评论、触碰 10.8% 的 PR
- Ars Technica,2026-10-09:报道该论文,指出编程效率增益被人工评审吸收
- NBER 工作论文 35275(2026-05):提交量效应约 30%/180%/240%,下探到项目约 80%、发布版本约 30%
老高,AI工具箱站长,更关心这些变化对普通人意味着什么。想及时拿到AI行业动态、工具玩法和能落地的创业机会——👉 加入AI工具箱免费社群
相关文章


 浙公网安备33010202004812号