
老高AI观察 · 第28期|2026 年 10 月 13 日
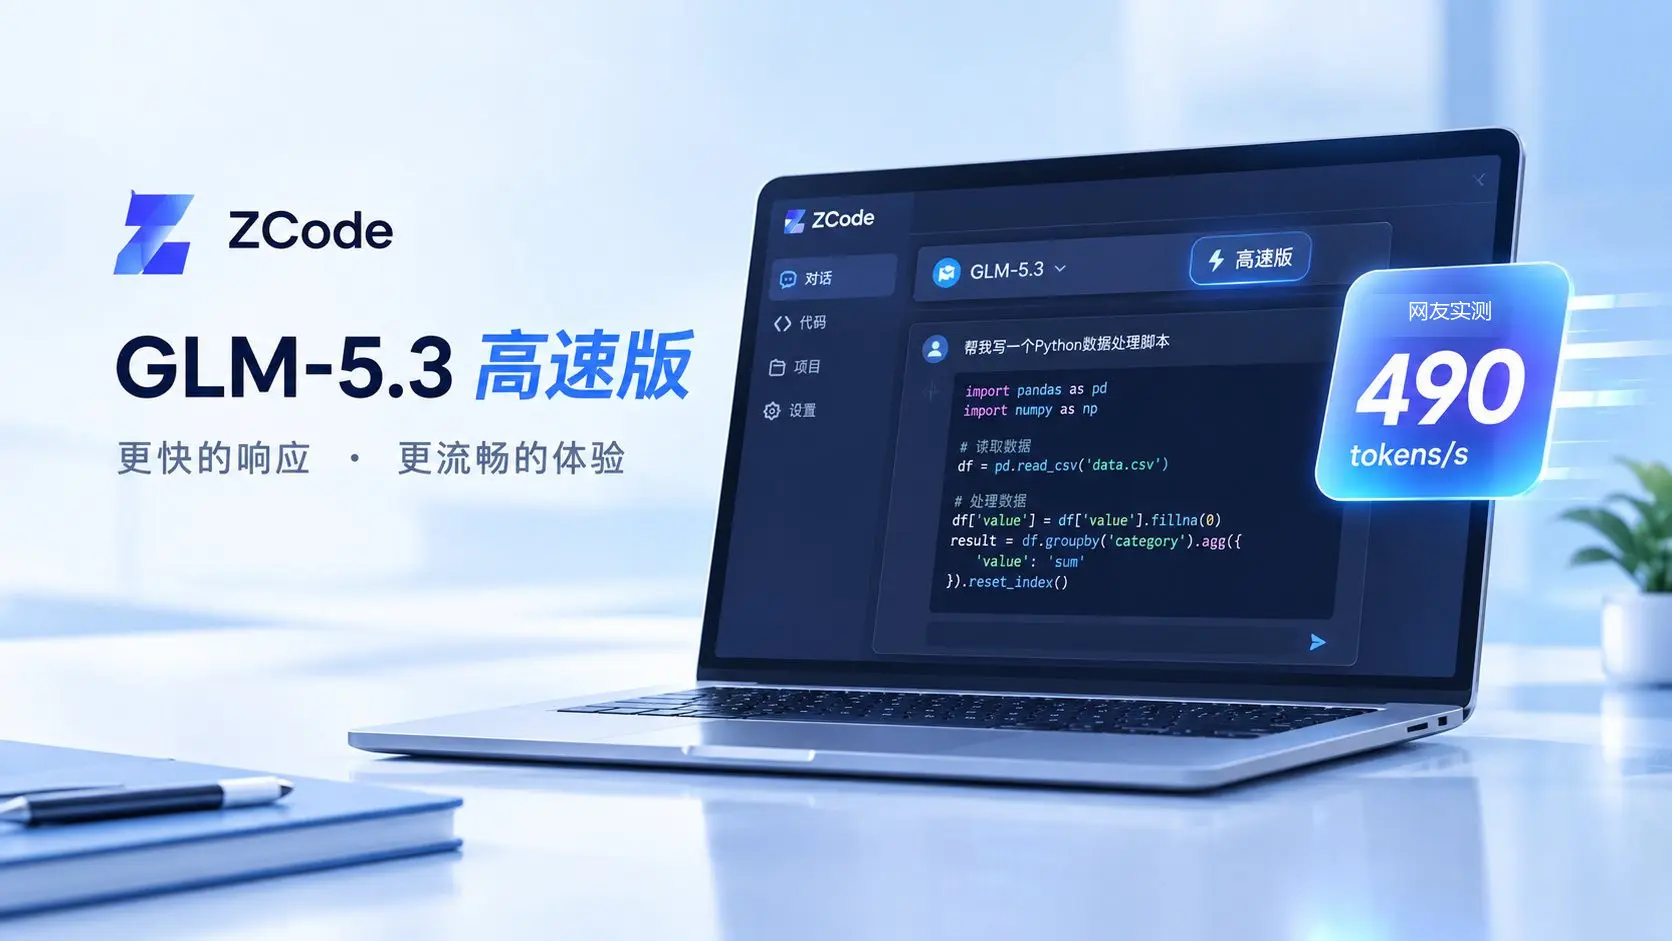
智谱的 GLM-5.3 发布两个月后,自家编码工具 ZCode 里悄悄多了一档「高速版」。10 月 12 日,有人贴出实测截图,输出速度跑到 490 tokens/s——这个数字一天之内传遍了圈子。但我盯着看了很久,觉得最值得说的不是「490」有多大,而是它的来源:它不是智谱给的。官方至今没发公告,也没公布任何吞吐数据。一个模型跑多快,这次是先由用户替厂商宣布的。
ZCode 里,多出一档高速版
先把事情说清楚。ZCode 是智谱自己的 AI 编程工具,跑在 zcode.z.ai 上,走订阅制。最近有订阅用户发现,模型选项里多出了一个「高速」档位——用的还是 GLM-5.3 这代模型,但推理路径明显更短、吐字更快。
目前这一档还在灰度放量,官方没有在产品页单独写出来,能不能用上带点随机(智东西 10 月 12 日报道)。换句话说,它不是一次新品发布,更像一次没打招呼的内测。
官方口径里能查到的硬信息只有三条:1M token 的上下文窗口、128k 的最大输出长度,以及 low/high/max 三档思考强度(智谱开放平台文档)。这三条其实已经说明了高速版的定位——为长输出、高频调用准备的,不是为深度推理准备的。
这条消息的时间轴
把时间摊开看,智谱碰「速度」不是第一次。今年 5 月,GLM-5.1 就出过一档 highspeed 版本,标称输出速度 400 tokens/s。8 月 GLM-5.3 发布时,站内 GLM-5.3 的介绍文 里写过它的完整规格:7430 亿参数的 MoE 架构,主打开源与编程。
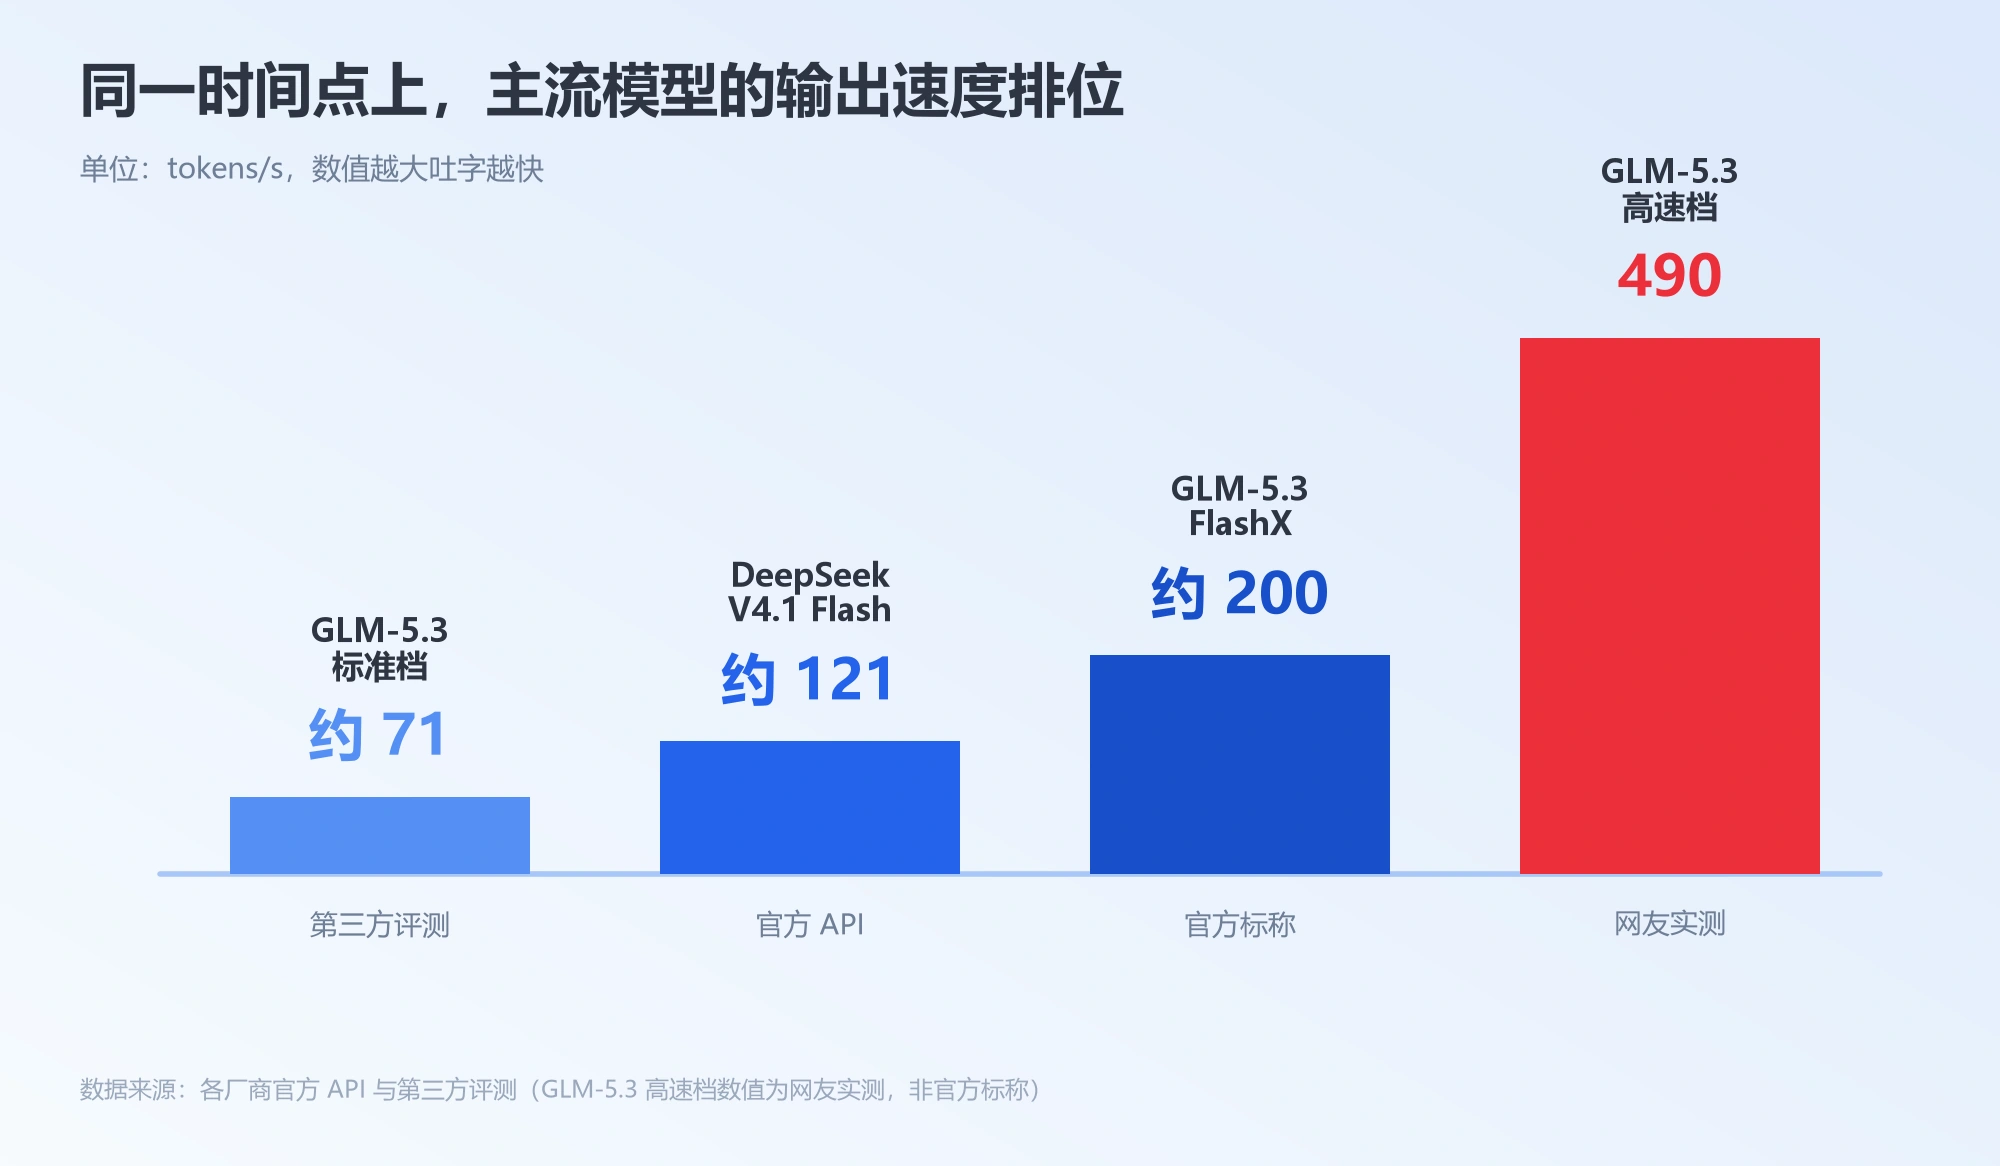
但那一代的速度成绩并不亮眼。第三方评测里,GLM-5.3 标准 API 的输出速度在 70 tokens/s 上下,同期站内 GLM-5.3-FlashX 标称 200,DeepSeek V4.1 Flash 的官方 API 实测在 120 左右。高速档要补的,正是模型够强、但吐字不够快这块短板。
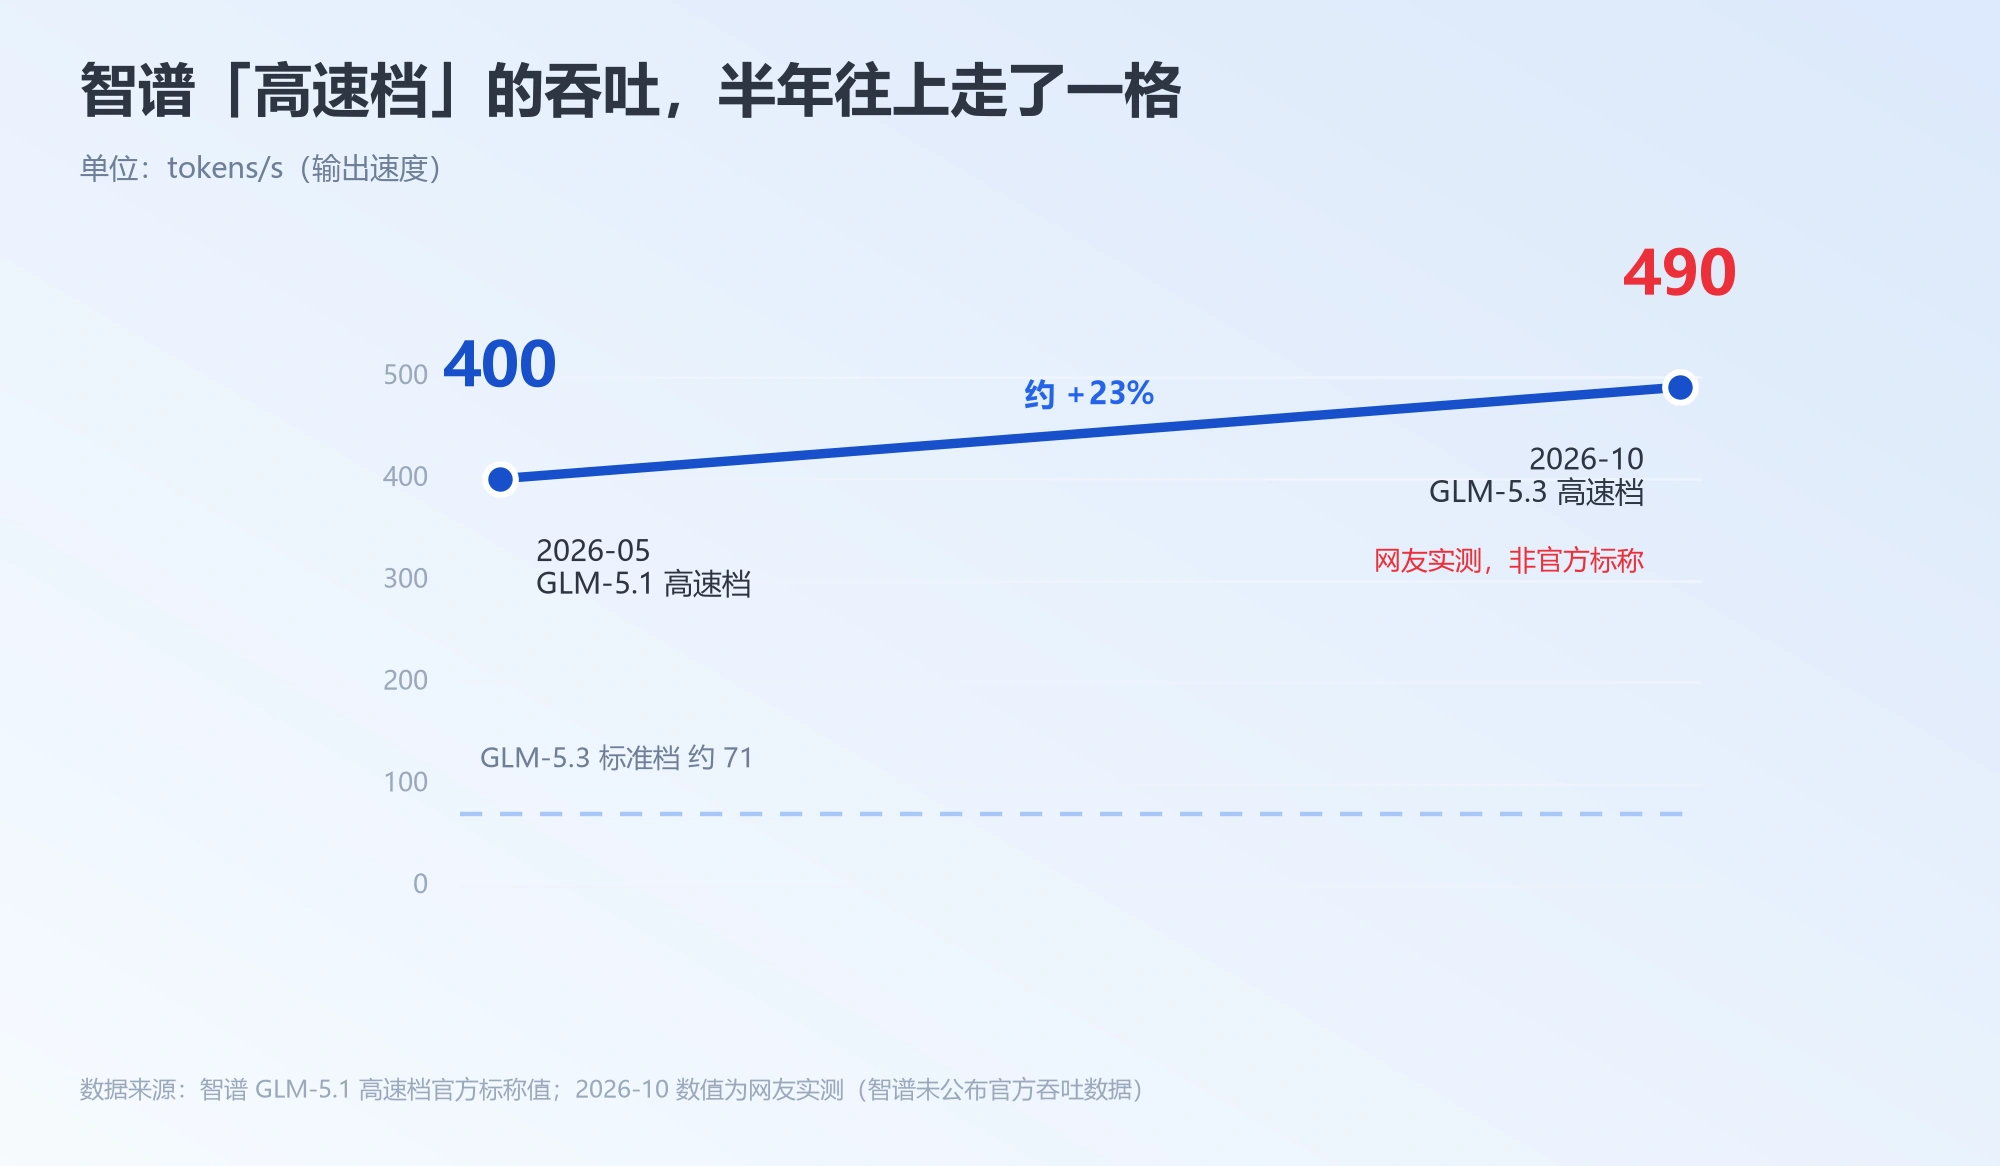
所以这次冒出来的 490,更像是在把「速度」当成一条独立产品线在推,而不是模型升级顺带的副产品。这个思路本身,比这个数字更值得记。
快,是拿什么换的
速度从来不是白来的。同一套模型权重,要在单位时间里多吐几倍的 token,常规做法无非三条路:把默认的思考链砍短、让解码更激进地并行、对输出做投机采样。它们有个共同点——都在拿「想得久」换「说得快」。
GLM-5.3 本身就有 low/high/max 三档思考强度,高速版很可能就是把默认档往下压了一到两档。好处是响应变快、交互更顺;代价是在长逻辑、深推理、多步规划这类任务上,可能不如标准档稳。
这不是智谱一家的问题。往期 第 23 期 讲过算力这条线怎么被重新分配;到了吞吐这一层,同一道选择题又出现了一次:同样的算力预算,你是花在多「想」几秒,还是多吐几个字。
谁在受益,谁在被挪位置
先说影响不大的。如果你只是偶尔打开对话框问两句,速度从 70 提到 400 还是 490,体感差别没那么明显——你等的那几秒,本来也不难熬。
真正受益的是跑批量任务的人:Agent 连续调用、长文档处理、代码仓库批量改写。这些场景里,等待时间是实打实的成本,吞吐翻几倍,同样的时间窗口能跑完的活儿就多几倍。往期 第 26 期 聊过开源模型争榜单位置,那次比的是排名;到这一层,比的是谁出字快。
但这里得泼盆冷水。速度提升不等于省钱。主流 API 现在还是按 token 计费,你为每个字付的钱没变;速度改变的只是「单位时间能跑多少」,不是「跑完一件事要花多少」。对按结果交付的生意,它可能压低交付周期;对按调用量付费的账本,它一分钱也省不下来。
该重新算账的,是把「响应快」当成核心卖点的人。当高速档变成标配,快本身就不再是溢价。
我的判断里最软的一环
第一条,也是最要命的:490 这个数字不是官方数据。它是网友在自己的环境里跑出来的单次实测,截图在社交平台流传。量子位 10 月 12 日的报道写得很清楚——智谱没有发布公告,也没有公布官方吞吐数据。
第二条,官方能查到的,只有上下文长度、最大输出和三档思考强度,没有一条是关于速度的。连「高速版」这个名字本身,都还停留在产品界面的档位开关上。
第三条,单一样本、单一任务、单一网络环境,不能当通稿数字用。我倾向于相信「智谱在做高速档」这件事方向是对的,但具体是 490 还是 350,我不替它背书。等厂商自己把口径摆出来,或者第三方评测跑出可复现的数,再谈也不迟。
手上能试的几招
一,如果你在用 ZCode,或者通过 智谱开放平台 调智谱的模型,先去模型列表翻一眼有没有高速档——灰度是随机的,有就试试,没有也不用急。
二,拿你自己的真实任务去测,别拿标称值当预期。换个提示词、换个输出长度,速度能差出好几倍。
三,做工具选型的时候,把「吞吐」加进评估表。以前大家只看跑分和价格,现在多一栏:同样的活儿,它要跑多久。这条线的后续,我会记在 老高AI观察 里。
一句实在话
我的判断是:速度这条线,正在从「模型跑分」变成「产品体验」——但当数字由网友的截图来定、而不是厂商的公告,这件事就还没到能下结论的时候。
关于GLM高速版,集中答三个问题
GLM 高速版是一个新模型吗?
不是。它是 GLM-5.3 在 ZCode 里的一个高速推理档位,用同一代模型换更短的推理路径。目前处于灰度阶段,订阅用户随机开放,官方没有单独发布。
490 tokens/s 是官方公布的数据吗?
不是。这是网友实测的单次结果。智谱没有发布公告,也没有公布官方吞吐数据;官方可查的参数只有 1M token 上下文、128k 最大输出,以及 low/high/max 三档思考强度。
普通用户现在能用上吗?
目前是灰度放量,能不能看到这一档有一定随机性,可以登录 ZCode 查看模型列表。即便没有高速档,GLM-5.3 标准档也能正常使用。
资料来源
- 智谱 ZCode 官网(zcode.z.ai):订阅方案与模型档位
- 智谱开放平台文档(docs.z.ai):GLM-5.3 的 1M token 上下文、128k 最大输出、low/high/max 三档思考强度
- 量子位(2026-10-12):智谱未发布公告、未公布官方吞吐数据;网友实测输出速度约 490 tokens/s
- 智东西(2026-10-12):ZCode 灰度放量,订阅用户可随机用上高速档
- 公开第三方评测与厂商官方数据:GLM-5.3 标准版 API 输出速度约 70 tokens/s、GLM-5.3-FlashX 峰值 200 tokens/s、DeepSeek V4.1 Flash 约 120 tokens/s
- 站内《GLM-5.3 – 智谱推出的编程与网络安全能力开源大模型》《GLM-5.1-highspeed》:7430 亿参数 MoE、GLM-5.1 高速版最高 400 tokens/s
我是老高,AI工具箱站长,工具出来先自己跑一遍才敢下判断——👉 来老高的AI工具交流群
相关文章


 浙公网安备33010202004812号