
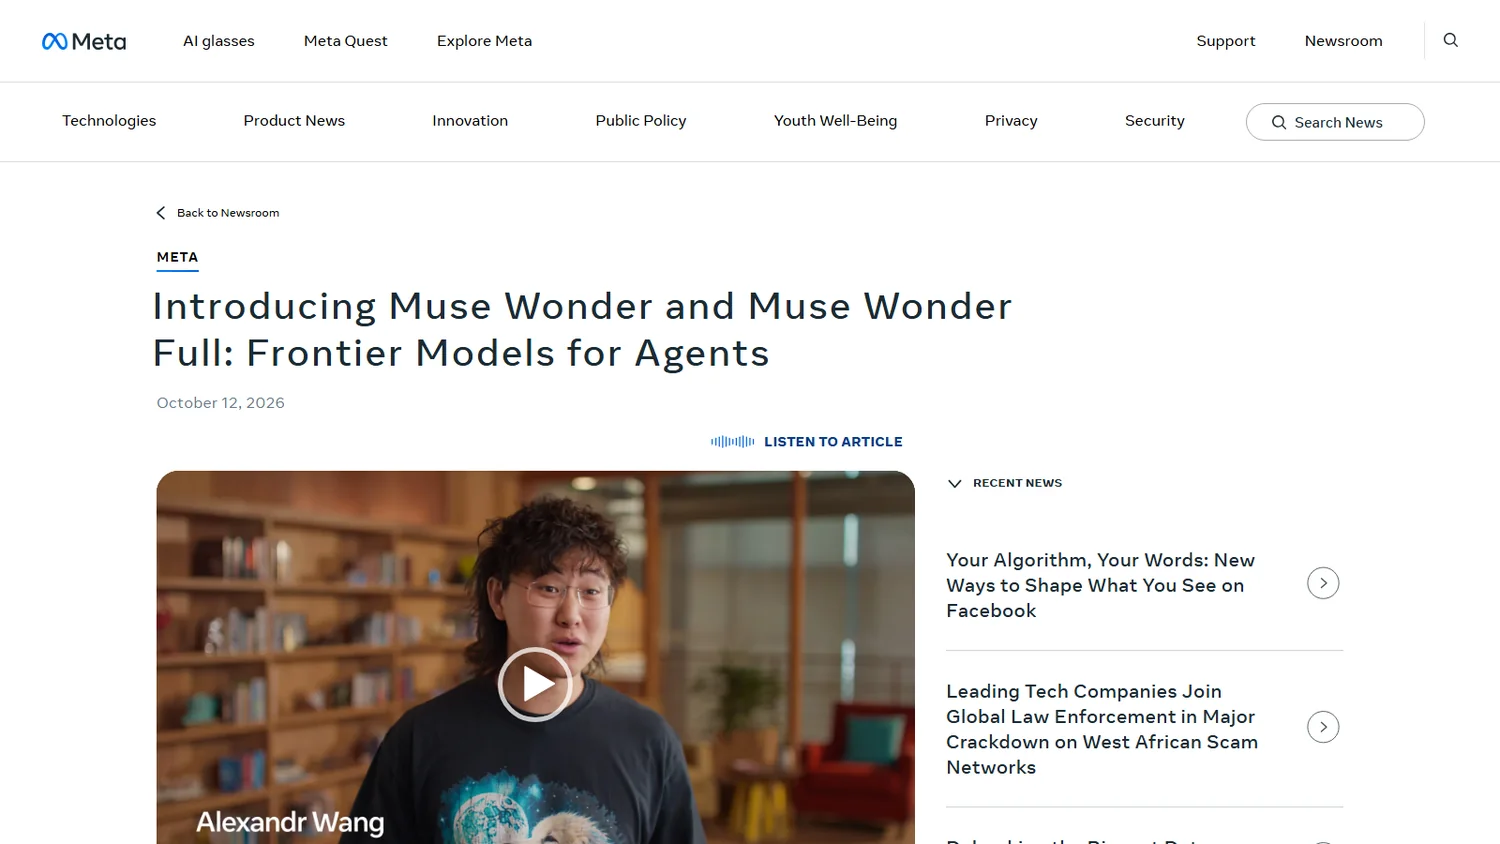
Muse Wonder是Meta于 2026 年 10 月推出的前沿智能体模型系列,由 Meta Superintelligence Labs 研发,主要用于承担生活与专业场景的长程智能体任务,支持跨对话长期记忆与遇阻自主换路,适用于生活代办、专业文书处理与长周期编程等方向。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 个人与专业场景的前沿智能体模型 |
| 出品方 | Meta Superintelligence Labs |
| 发布时间 | 2026年10月12日 |
| 上下文窗口 | 100 万 token |
| 输入模态 | 文本、图像与文件 |
| 开放方式 | Meta Model API 与 Muse Code |
| API 定价 | 输入 4、输出 20 美元每百万 token |
| 权重开放 | 未开放 |
Muse Wonder 的核心能力
Muse Wonder 要解决的是 AI智能体 在真实任务里最容易断掉的两个环节:一是记不住此前交流过什么,二是遇到障碍就停下等待指示。Meta 把这两点分别做成 Active Memory 与 Active Focus 两项能力,并让模型在跨对话与跨步骤的执行中持续调用它们。
Active Memory 跨对话保留关键上下文
Active Memory 让模型把与用户有关的重要信息保留下来,在后续任务中主动检索与当前目标相关的部分,而不是每次请求都重新交代背景。官方给出的例子里,用户此前提到过的偏好与条件会在新一轮任务中被自动带入,模型据此调整方案,不需要重复说明。这项能力针对的是长期使用的个人助手场景——任务之间往往相隔数天,上下文需要跨会话延续。
Active Focus 遇阻时自主换路并确认关键操作
Active Focus 描述的是模型在目标困难时的执行方式:尝试替代路径、消化过程中的阻塞、根据新出现的信息调整做法,并在必要时请求澄清;在随后执行的步骤比较重要时,会先与用户确认再继续。官方用 FocusBench 衡量这一能力,并用 SWE-Marathon 检验模型在长时间软件工程任务中的持续执行表现。这与只做单轮回答的模型差异明显:后者在第一次尝试失败后通常就结束了。
面向法律、金融与健康的专业领域能力
除通用问答外,Muse Wonder 把专业领域能力作为重点方向,官方列出的场景包括理解租赁合同、核对保险理赔与梳理个人财务信息。在测试专业领域能力的评测中,Meta 采用了 Harvey 的法律智能体基准(Harvey LAB),该基准要求模型在给定源文件与详细指令的前提下产出法律工作成果。这一方向的思路是让模型读懂材料再推理,而不是仅凭常识作答。
长周期编程与未见过任务的泛化
编程被官方视为这些能力的集中体现:写软件需要持续跟踪需求、跨文件修改代码、反复测试与修订。Muse Wonder 在长周期编程任务上达到前沿水平,可支撑从小型应用到复杂软件的构建。官方研究博客还提到,由于 Muse Wonder 建立在规模更大的基座之上,后训练获得的提升更容易迁移到训练时没有针对过的陌生任务,这一点与此前的 Muse Spark 1.3 相比有进一步提升;对需要组合多种目标与工具的个人助手而言,泛化能力比单一基准分数更关键。
Muse Wonder 与同类前沿模型的对比
| 对比维度 | Muse Wonder | Claude Opus 5.5 | Qwen 3.8-Max |
|---|---|---|---|
| 开发方 | Meta Superintelligence Labs | Anthropic | 阿里巴巴通义千问团队 |
| 核心定位 | 个人与专业场景智能体 | 通用旗舰模型 | 千问旗舰智能体模型 |
| 发布时间 | 2026 年 10 月 12 日 | 2026 年 9 月 22 日 | 2026 年 8 月 3 日 |
| 上下文窗口 | 100 万 token | 100 万 token | 100 万 token |
| 输入模态 | 文本、图像、文件 | 文本、图像、文件 | 文本、图像、视频 |
| 权重开放 | 未开放 | 未开放 | 计划开放 |
| API 定价 | 输入 4、输出 20 美元每百万 token | 输入 4、输出 20 美元每百万 token | 按阿里云渠道计费 |
上表 Muse Wonder 一列取自 Meta 官方发布材料与 Meta 研究博客,Claude Opus 5.5 一列取自 Anthropic 官方模型说明与第三方评测口径,Qwen 3.8-Max 一列取自阿里云官方说明。三款模型的调用接口都支持文本与图像输入,选择时可以先看自己的任务落在哪一类:需要跨越多次对话、持续数小时推进的智能体流程,重点看 Muse Wonder 的记忆与长任务设计;已经使用 Claude 或通义生态的团队,迁移成本更低的选择分别是 Claude Opus 5.5 与 Qwen 3.8-Max。
Muse Wonder 当前的落地入口之一是 Meta 的编程智能体工具。需要直接在编辑器里调用这一系列模型的开发者,可以参考 Muse Code(Meta 推出的 AI 编程智能体工具,登录后即可在开发流程中调用 Wonder 系列模型)。
Muse Wonder 的应用场景与适用人群
Muse Wonder 面向需要在多次交互之间延续、且中途可能受阻的任务,常见场景包括:
- 跨会话的个人助理:此前交代过的偏好与约束会被带入新任务,连续若干天推进同一件事,不必每轮重述背景。
- 多步骤事务代办:给出一个目标,由模型自行拆成订位、比价、确认时间等子步骤逐个完成;遇到档期已满一类阻碍时改走替代方案。
- 专业材料初筛:通读合同、理赔材料与财务记录,把与委托立场相关的条款和数字标出来,并单独列出需要人工确认的部分。
- 长时间软件工程:在需求持续变化时保持同一目标,跨文件修改并反复测试,中途失败后调整实现路径继续推进。
适用人群:需要把长流程任务交给智能体执行的个人用户,希望把专业材料初筛与文书整理纳入自动化流程的团队,以及在此基础上构建编程或办公智能体的开发者。
Muse Wonder 的使用方法
Muse Wonder 通过 Meta Model API 与 Muse Code 开放,可按以下顺序接入:
- 确认开放范围:在 Muse Wonder 官方发布页 对照标准版与完整版的定位差异。
- 开通开发者权限:在 Meta 的模型控制台完成账号注册,并建立用于生产与测试的调用凭据。
- 指定模型标识:请求中的模型参数使用
muse-wonder-1.0;已订阅 Muse Code 的账号可改用muse-wonder-full-1.0。 - 沿用现有 SDK:接口兼容 OpenAI 与 Anthropic 的调用格式,迁移时只需替换 base URL 与模型名。
- 估算调用开销:输入按每百万 token 4 美元、输出按每百万 token 20 美元计费,命中缓存的读取价更低。
两款模型的定位不同:标准版面向接口调用,完整版只随 Muse Code 的订阅方案发放,并额外支持视频输入。评估阶段建议先用标准版验证完整流程,确认效果后再决定是否升级到完整版。
Muse Wonder 的价格与开源情况
Muse Wonder 通过 Meta Model API 按 token 计费,输入为每百万 token 4 美元、输出为每百万 token 20 美元,缓存读取的价格低于输入价。Muse Wonder Full 不作为独立商品售卖,而是随 Muse Code 的订阅方案一并提供,因此完整版的支出体现为订阅费,不按调用量单独结算。
Muse Wonder 与 Muse Wonder Full 均未开放模型权重,官方也没有公布后续的开源安排,使用方式限于接口调用与配套产品。需要在本地部署或自行微调的团队,目前无法直接获得这一系列模型的权重。
Muse Wonder 的常见问题
Muse Wonder 是什么?
Muse Wonder 是 Meta 于 2026 年 10 月推出的前沿智能体模型系列,包含标准版 Muse Wonder 与完整版 Muse Wonder Full 两款。它把跨对话长期记忆与长任务持续执行作为核心能力,面向生活代办、专业材料处理与长周期编程等需要连续推进的任务。
Muse Wonder 与 Muse Wonder Full 有什么区别?
两款模型建立在同一套训练方法之上,差别在开放方式与输入模态。标准版通过 Meta Model API 按 token 计费开放,输入模态为文本、图像与文件;完整版仅随 Muse Code 订阅提供,并额外支持视频输入。
Muse Wonder 是开源的吗?
不是。Muse Wonder 与 Muse Wonder Full 都没有开放模型权重,官方也暂未说明后续的开源安排,目前只能通过 Meta Model API 调用,或在 Muse Code 内使用 Wonder 系列模型。
相关文章


 浙公网安备33010202004812号