
Mellum2.1是一款由JetBrains于2026年10月推出的开源编程智能体模型,主要用于代码库探索、文件编辑与工具调用等智能体编程任务,支持 131,072 tokens 上下文与本地自托管部署,适用于软件工程自动化与企业内网代码场景。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 开源编程智能体模型 |
| 出品方 | JetBrains |
| 发布时间 | 2026年10月8日 |
| 架构 | 12B 混合专家,2.5B 活跃参数 |
| 上下文长度 | 131,072 tokens |
| 开源许可 | Apache 2.0 |
| 部署方式 | 自托管(vLLM 等) |
Mellum2.1 的核心能力
Mellum2.1 是 JetBrains 开源编程模型 Mellum2 的升级版,架构未变,工作集中在预训练之后的阶段。官方把它归入 AI 模型 序列,定位从快速补全转向可在仓库内自主执行的编程 AI 智能体,目标场景是让它像工程师一样读代码、改文件、跑测试,而不只是续写下一行。
强化学习成为训练主体
这一版把强化学习从训练末段的收尾环节扩展为训练主体。新增任务覆盖数学、算法竞赛、科学、工具使用与软件工程,由公开强化学习数据集与团队自建任务混合而成。每一份训练来源在入库前都做过筛除,剔除的对象包括测试本身有缺陷、答案无法验证,以及难度明显失当的任务。
真实代码库中的智能体执行
软件工程方向的训练直接放在真实仓库里进行,模型配有 shell 与文件编辑工具,只有测试通过才获得奖励。官方说明,训练期间启动了数百万个沙盒、覆盖数千个环境。升级后的模型可以浏览代码库结构、修改文件并回读自身改动,在失败测试面前能够定位根因、起草修复方案,再运行验证结果。
高负载下的推理吞吐
JetBrains 公布的速度指标针对单张 H200 在重负载下的输出吞吐:官方称 Mellum2.1 每秒产出的 token 数量接近 Qwen3.5-9B 的两倍。这项优势的价值集中在并发场景——当同一张卡上同时运行多个智能体或子智能体时,吞吐直接决定单位时间能完成多少轮任务,对按产出量而非单次质量计价的工作更明显。
多 Token 预测带来的加速
模型规格包含多 Token 预测(MTP)头,用于在单次请求中一次预判多个后续 token,官方给出的单请求提速约为 1.6 倍。需要留意的是,MTP 头并未随本次发布一并提供,官方表示面向 vLLM 的推测解码组件将随后推出,因此这项加速在正式发布前尚不可用。
开源权重与本地部署
模型以 Apache 2.0 许可证发布,权重已在 Hugging Face 开放,支持在本地或自有基础设施上部署,企业可以把代码与数据保留在自身环境内。官方后续还将提供面向 llama.cpp、Ollama 与 LM Studio 的 GGUF 版本。对源码不能出内网的团队来说,这条路径省去了走外部接口的合规环节。
Mellum2.1 与同类编程模型的对比
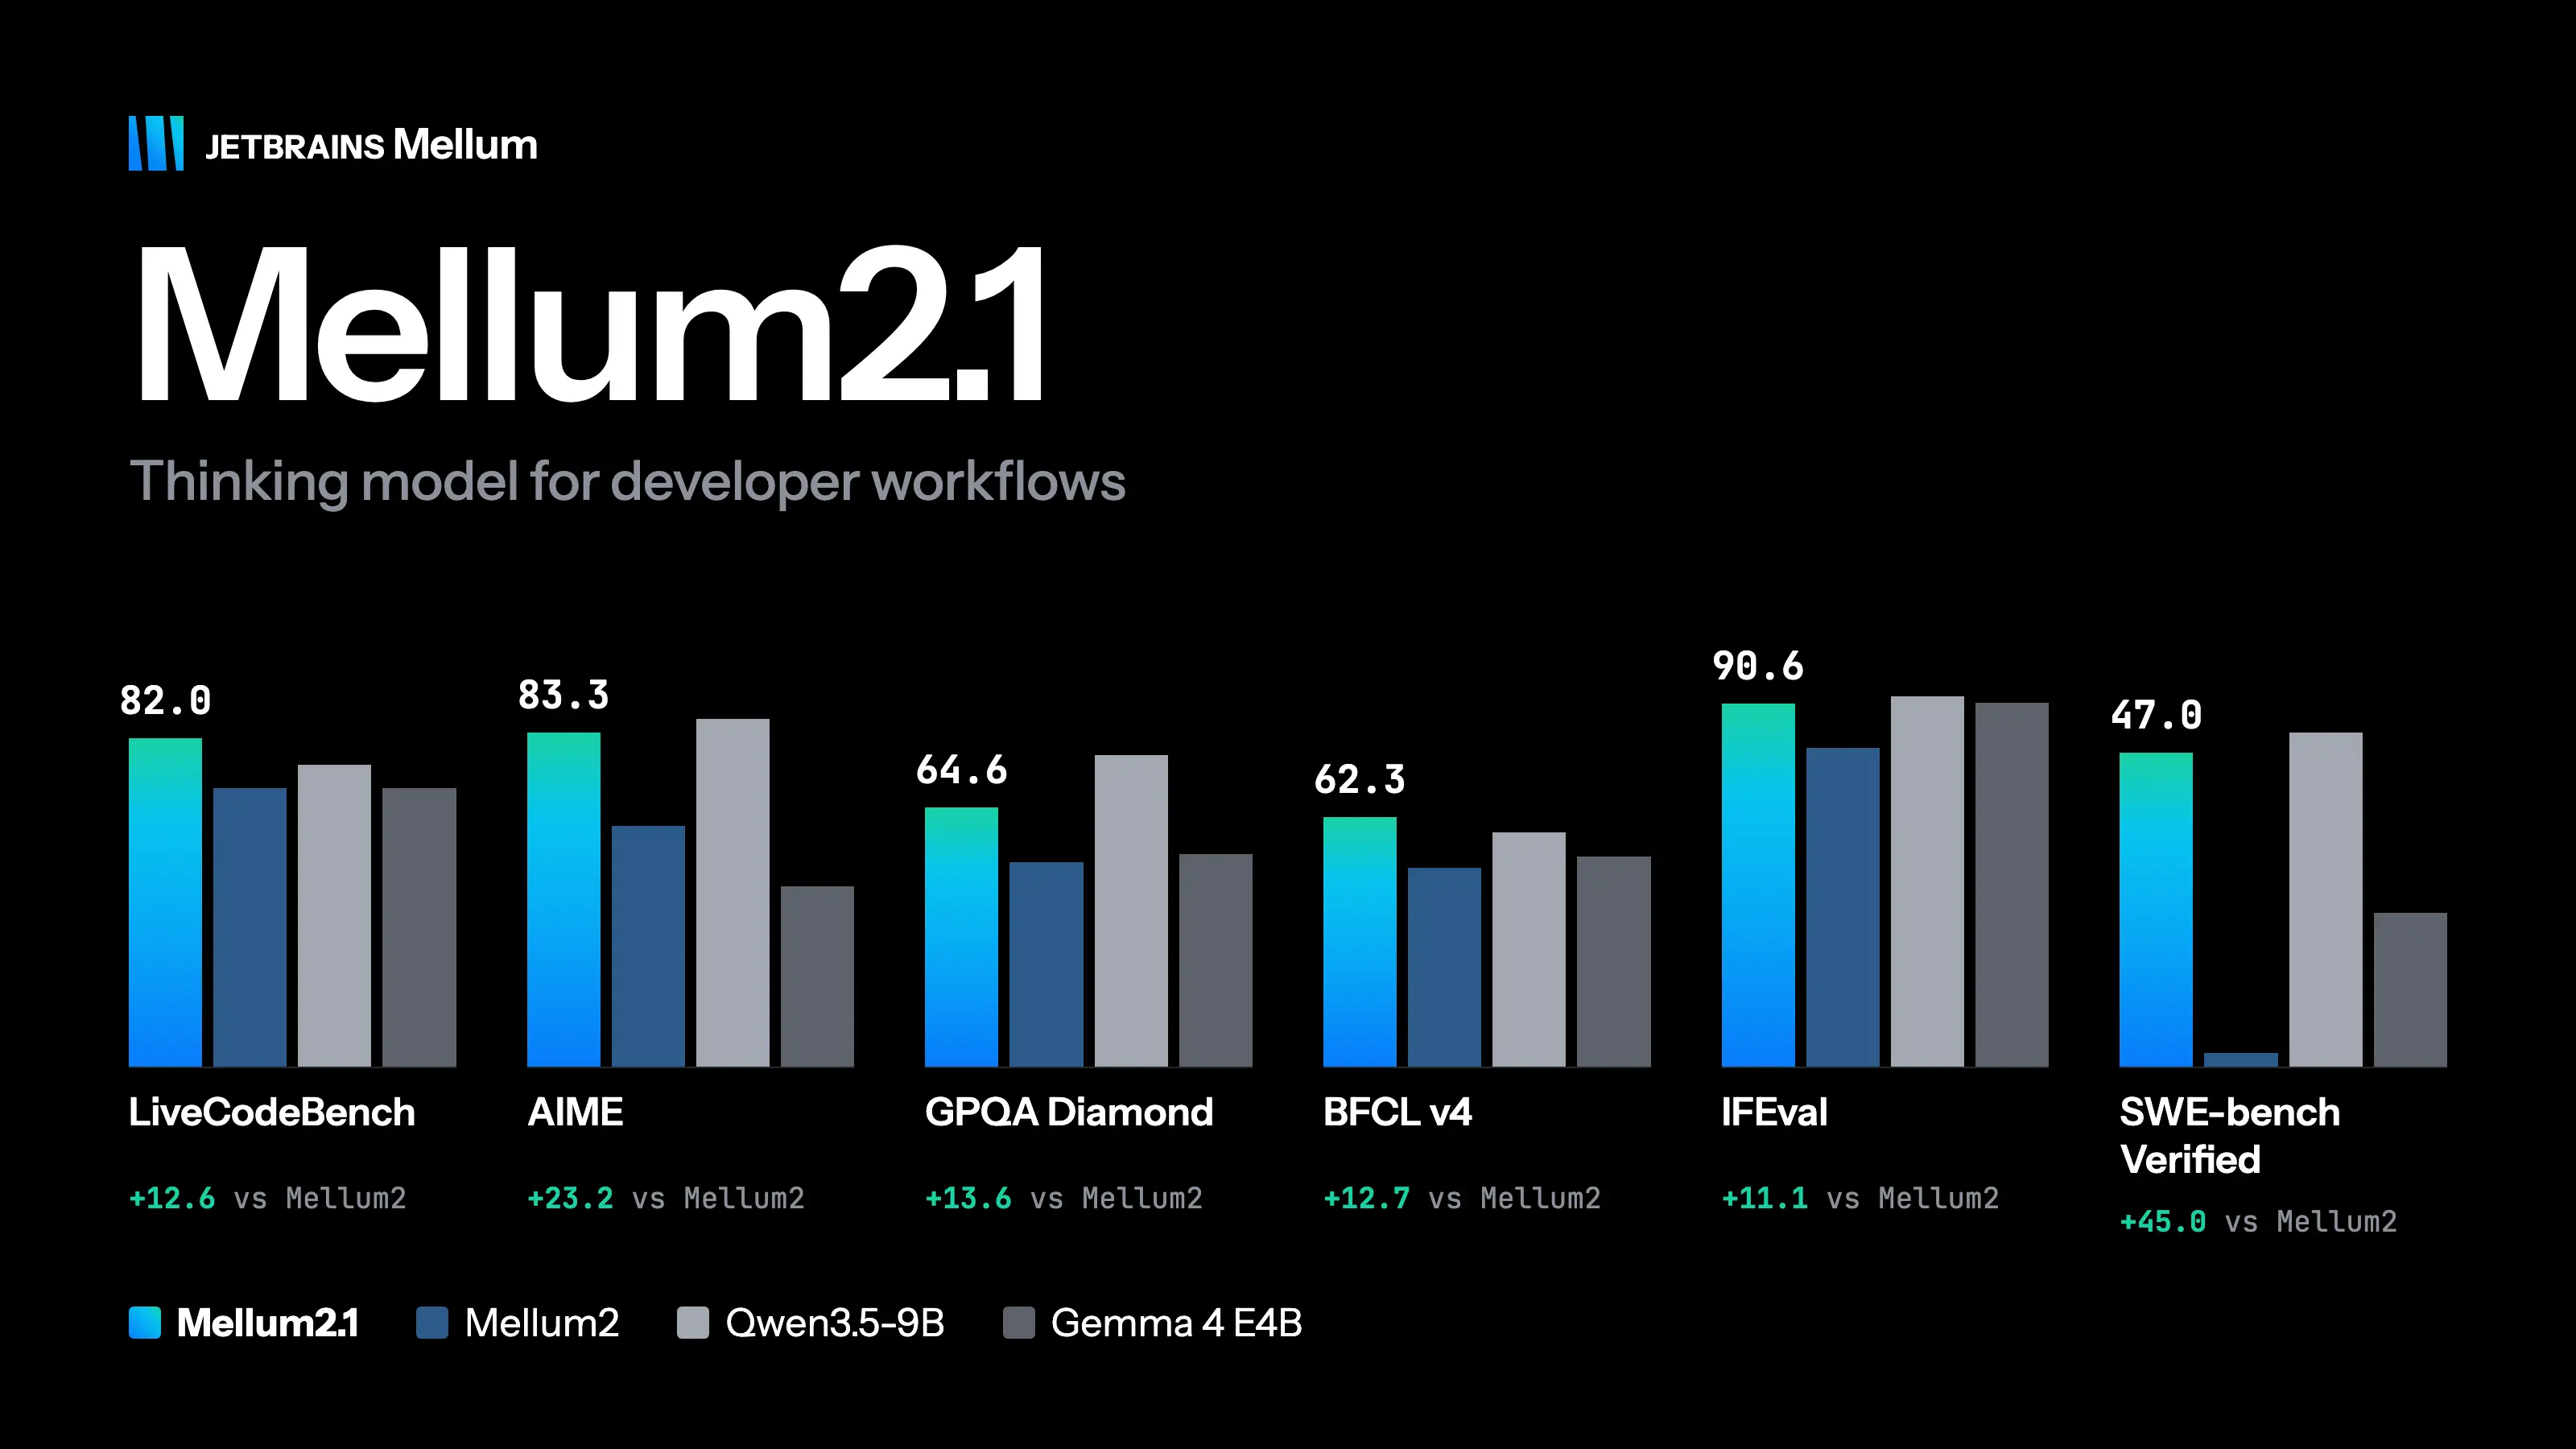
| 对比维度 | Mellum2.1 Thinking | Qwen3.5-9B | Gemma 4 E4B |
|---|---|---|---|
| 开发方 | JetBrains | 阿里 | 谷歌 |
| SWE-bench Verified | 47.0 | 50.0 | 23.0 |
| SWE-bench Pro | 28.0 | 38.0 | 4.0 |
| Terminal-Bench 2.1 | 17.4 | 21.7 | 3.4 |
| LiveCodeBench v6 | 82.0 | 75.4 | 69.4 |
| BFCL v4 | 62.3 | 58.5 | 52.5 |
| GPQA Diamond | 64.6 | 77.8 | 53.1 |
| HumanEval+ | 91.5 | 89.6 | 89.1 |
上表三列数据均取自 JetBrains 在 Hugging Face 官方模型卡公布的评测结果,四个模型由同一套流程在 thinking 模式下评测,智能体类基准统一使用同一开源 agent harness,数值为厂商自评口径。三者的取舍方向不同:需要在固定算力下批量运行智能体、且源码不便外发的,权重开放且吞吐更高的路线更直接;面向真实仓库的修复与命令行任务,Qwen3.5-9B 的完成率更高。
关注开源编程智能体这条路线,还可以参考 Qwen3-Coder-Next(阿里开源的编程智能体模型,同样以开放权重发布,主打代码生成、仓库理解与工具调用,适合与自有研发流程对接)。
Mellum2.1 的应用场景与适用人群
该模型面向需要在自有环境内运行代码智能体的任务,常见场景包括:
- 缺陷修复:在真实仓库中定位失败测试的根因,起草补丁并运行验证。
- 代码库理解:浏览项目结构与调用关系,输出可执行的修改方案。
- 工具调用:在智能体流程中执行命令、编辑文件并串联多步操作。
- 内网开发:把权重部署在自有服务器上,代码与数据不出内网。
适用人群:软件工程团队、把编程智能体接入内部研发流程的企业,以及需要在自有基础设施上部署代码模型的开发者。
Mellum2.1 的使用方法
模型权重已在 Hugging Face 开放,按以下顺序自托管部署:
- 获取权重:在 Mellum2.1 官方模型页 下载权重,模型编号为
JetBrains/Mellum2.1-12B-A2.5B-Thinking。 - 启动服务:用 vLLM 加载模型,指定
--max-model-len 131072与--reasoning-parser qwen3。 - 启用工具调用:需要执行命令或编辑文件时,追加
--enable-auto-tool-choice与--tool-call-parser hermes。 - 发送请求:走 OpenAI 兼容接口调用,采样参数按官方示例取
temperature0.6、top_p0.95、top_k20。 - 对齐显存:按
--max-model-len设定值与并发量核算显存占用,显存不足时优先下调上下文长度。
首次部署建议先用单条提示词验证工具调用链路,确认命令执行与文件编辑均可回传结果后,再接入仓库级任务。
Mellum2.1 的价格与开源情况
Mellum2.1 不提供官方托管接口,JetBrains 只以权重形式发布模型,使用成本取决于自建或租用的推理算力,官方未公布接口调用价格。以 bfloat16 精度部署时,显存占用由总参数量、上下文长度与并发量共同决定,部署前需按实际业务量核算;模型本身不按调用次数收费,批量运行智能体也不会产生额外的接口账单。
Mellum2.1 以 Apache 2.0 许可证发布,属于允许商用的开源许可,权重托管于 Hugging Face,支持本地或自有基础设施部署,企业可以把代码与数据保留在自身环境内。官方后续将提供面向 llama.cpp、Ollama 与 LM Studio 的 GGUF 版本,以及 vLLM 的多 Token 预测推测解码组件。
Mellum2.1 的常见问题
Mellum2.1 与 Mellum2 有什么区别?
两者架构一致,均为 12B 总参、2.5B 活跃参数的混合专家模型,许可证同为 Apache 2.0。区别在训练:Mellum2.1 把强化学习从收尾阶段扩展为训练主体,并补充了数学、算法竞赛、科学、工具使用与软件工程任务,智能体编程能力提升最明显,官方评测中 SWE-bench Verified 由 2.0 升至 47.0。
Mellum2.1 可以商用吗?
可以。模型以 Apache 2.0 许可证发布,商用不受限制,权重已在 Hugging Face 开放,可下载后部署在自有或租用的基础设施上。
Mellum2.1 支持多长的上下文?
上下文长度为 131,072 tokens。官方在智能体类基准中统一按 114K token 上下文与每轮最多 16K token 输出运行,实际部署时可按显存余量调整上限。
相关文章

 浙公网安备33010202004812号