
老高AI观察 · 第22期|2026 年 10 月 6 日
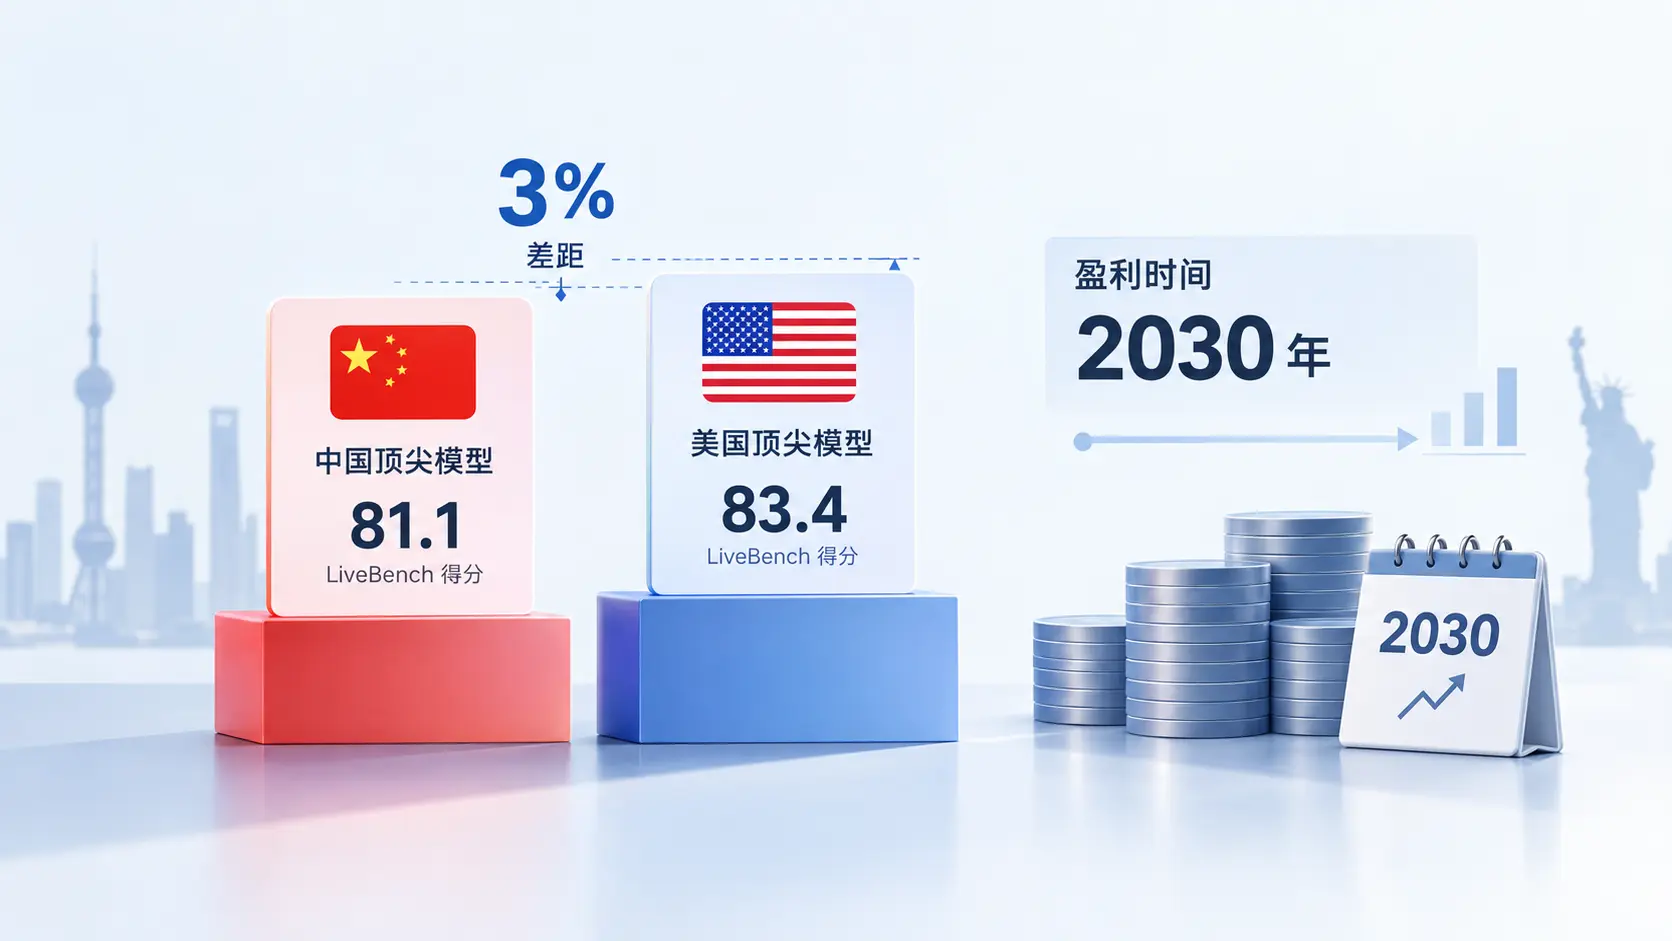
一组数字摆在一起,比单独看任何一个都刺眼:中国最顶尖的模型,在基准测试上只落后美国 3%;而同一份报告的作者判断,中国 AI 行业可能要到 2030 年才能盈利。追平的是分数,没追平的是账。这是彭博行业研究(Bloomberg Intelligence)10 月 5 日发布的报告给出的两条结论。过去一年我们习惯的“差一代”“差半年”,如今被压到个位数百分比——但被压掉的只是分数。对国内读者,意义不在“我们赢了”,而在两件事:国产模型会更够用、价格继续往下走;做 AI 生意的团队,接下来面对的不是能力短板,是利润天花板。
三个季度,差距从 15% 收到 3%
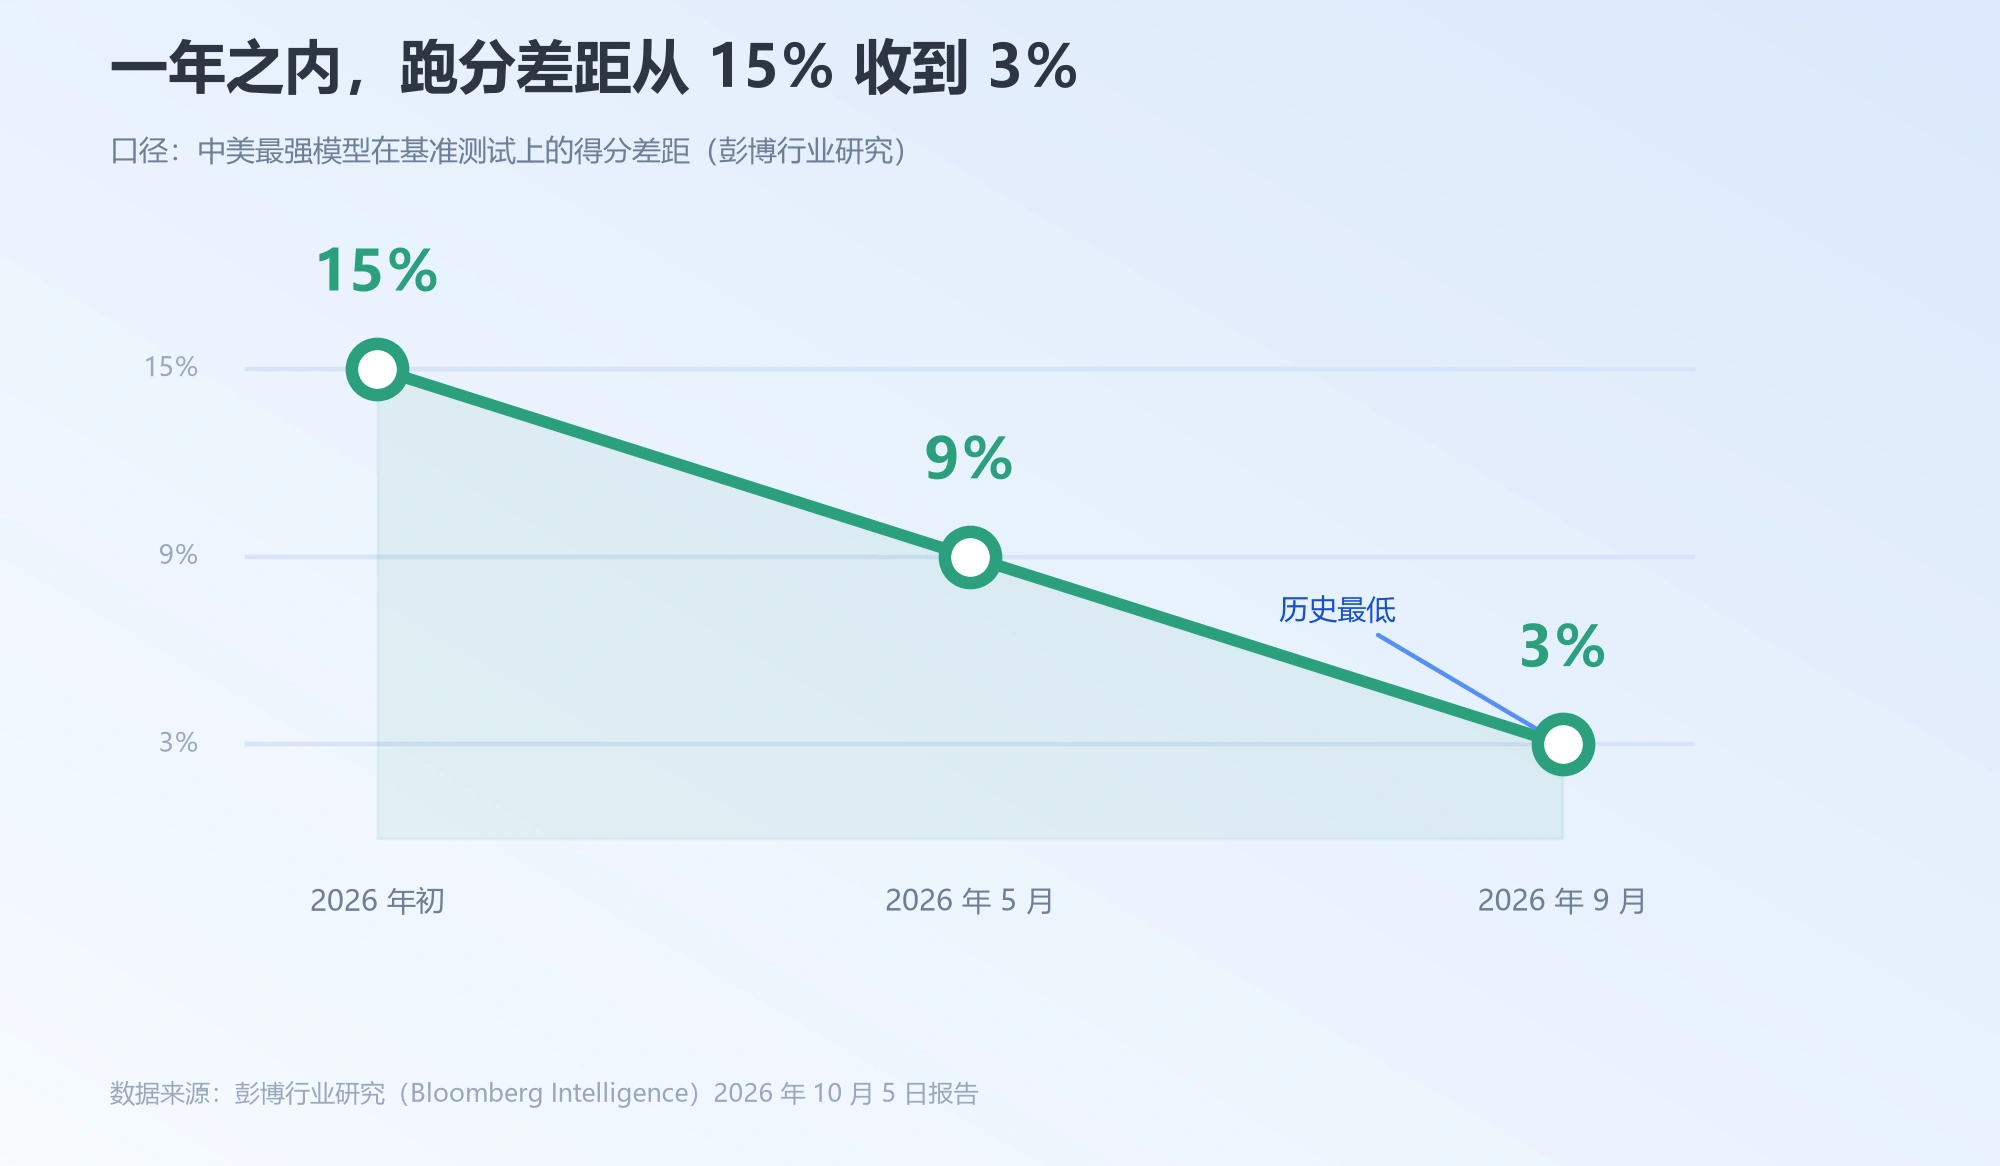
先摆事实。彭博行业研究(Bloomberg Intelligence)高级分析师 Robert Lea(罗伯特·利)在 10 月 5 日(周一)发布的报告里写道:自 DeepSeek 今年 9 月发布 V4.1 Flash 后,中国顶尖模型与美国竞争对手在基准测试得分上的差距已缩小到 3%,而 5 月还约为 9%,年初约为 15%。支撑它的是 LiveBench——按问答、谜题和实际任务打分的第三方榜单:DeepSeek V4.1 Flash 在 9 月排到全球第 6,是 2025 年 R1 出圈以来中国模型拿到的最高名次,最新得分 81.1,美国 Anthropic 旗下最高分模型是 83.4。
报告把中国这轮进步归到两件事:国内团队在 AI 上的积累越来越厚,以及研究人员很会针对国产硬件做优化。彭博社的报道点出延伸——这些进展让外界质疑,美国限制英伟达芯片出口还起不起作用。报告也留了活口:在被指控“模型蒸馏”后,中国模型在美国正面临更严的监管审查,甚至可能被禁用(信源:彭博社报道、LiveBench 榜单)。
这条线的起点比看上去更早
15% → 9% → 3% 这条线,不是 9 月才画出来的。起点可以追到 2025 年 DeepSeek 的 R1——那一次它让“开源模型能打”成了行业共识。之后的节奏站内一期一期记过:今年上半年我写过 开源模型只差 4 个月那次,当时比的是发布时差;现在这份报告比的是跑分。指标换了,方向没换——这类跟踪我都收在 老高AI观察 这个系列里。
另一条线是硬件。今年国产芯片上的适配进展,让“针对本土硬件优化模型”从口号变成了可量化的分数,比如 DeepSeek 把组件开源到昇腾上 这类动作,本质是把软件门槛补上。把这些放在一起,“为什么是现在”就有答案了:模型、算力、工程三件事同时往前挪,不是某一次发布的偶然。
差 3% 的是跑分,不是生意
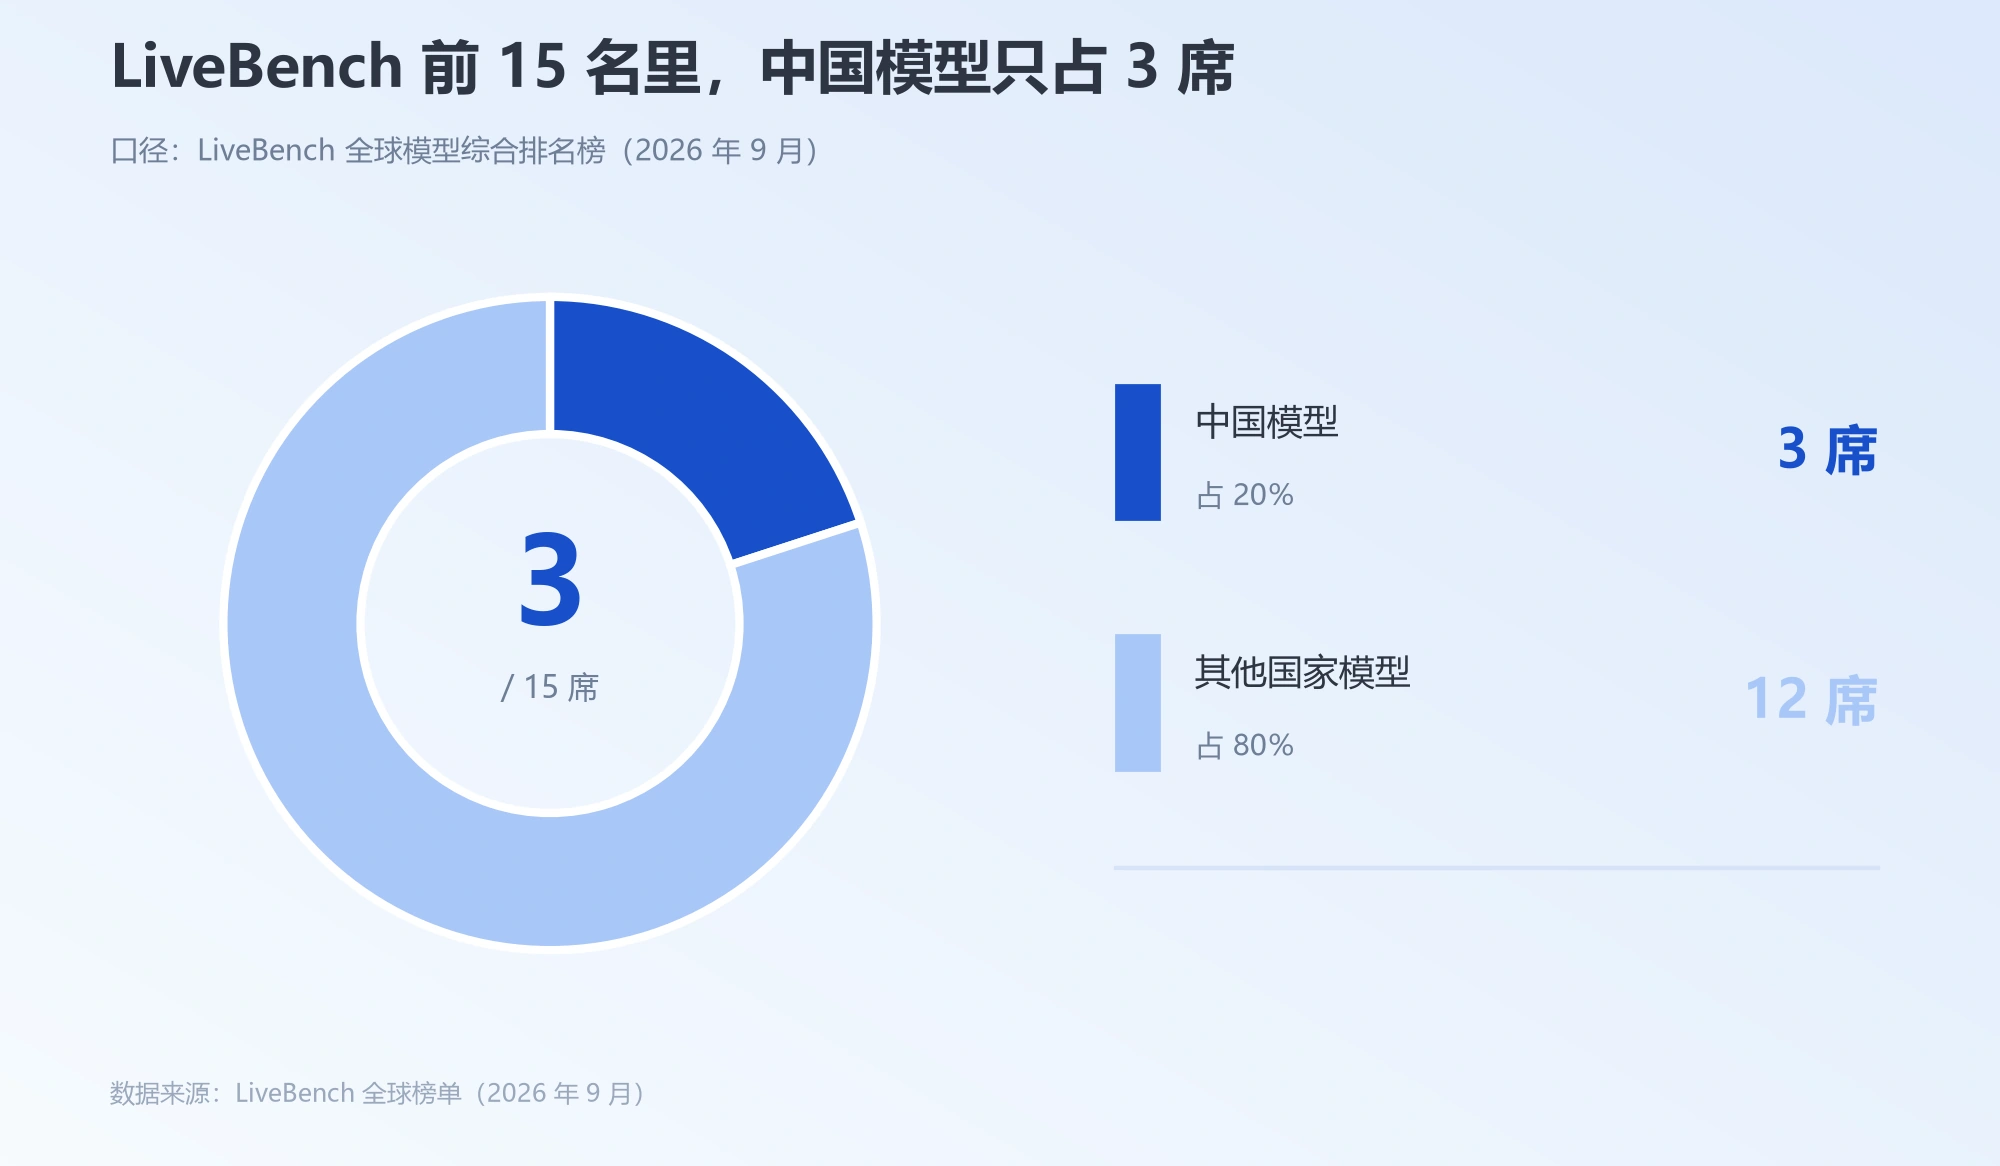
3% 很好传播,也最容易读错。第一,这是“最强对最强”的差距,不是整体差距——同一份报告里写着,LiveBench 前 15 名模型里中国只占 3 席。我们有一个能打的高点,没有一片能打的高地。
第二是榜单的性质。Robert Lea 自己提醒,这类排名会变,而且无论排第几,变现都可能很困难。跑分衡量的是“答得对不对”,不是“用户愿不愿意付钱”——这段距离,恰恰是过去一年国内 AI 行业最没解决的部分。所以正确读法是:能力进第一梯队是真的,但不证明这门生意跑通——把两者混为一谈,是这波讨论里最常见的误读。
没被追平的是付费意愿
为什么说“账”没追平?看两组对照。一边是美国的头部公司——彭博社报道提到,Anthropic 和 OpenAI 正为潜在 IPO 争取万亿美元级估值,“模型更强”正是支撑估值的重要理由。另一边是国内:超过 1100 个 大语言模型挤在同一条赛道上,Token 价格一路往下走。Robert Lea 的判断很直接——中国 AI 行业可能要到 2030 年才能盈利,原因是大家都挤在低毛利的模型调用生意里。商业化跑在前面的只有字节的豆包;DeepSeek 和腾讯的部分聊天机器人到现在仍免费。
我在 词元用量全球第一那期 里写过同一件事的另一面:中国调用量全球第一,但赚得少。这次报告从外部给了印证——用量能涨,是因为便宜;赚得少,也是因为便宜。Lea 的原话是:要让中国 AI 走上可持续盈利的路,需要竞争压力降温、行业洗牌,以及更理性的定价。
谁的旧经验不管用了
这件事落到不同人身上,影响完全不一样。普通用户这边结论最直接:国产模型已经够用。3% 的跑分差,在日常写作、翻译、整理资料上基本感受不到,而价格比美国同行低得多——如果你还在为“国产的能不能用”犹豫,这个犹豫可以省了。
做 AI 工具生意的人盘算就复杂了:过去两年“模型能力不够”是很多产品做不起来的理由,现在基本站不住:门槛挪到了别的地方——分发渠道、单位成本,以及你能不能找到一个真正有人愿意付钱的场景。放到整站看也一样:我们 AI模型库 里收录的模型,今年明显是“数量更多、差异更小”,选型靠跑分已经排不出高下。
如果我是错的,会错在哪一步
得说清楚这份判断的软肋。第一,报告来自单一机构:彭博行业研究是彭博社的研究部门,结论经彭博社报道传播,但严格说,我目前没在中文侧看到权威媒体的独立核实,这一条如实标出来。第二,基准测试可以被“优化”,模型针对榜单做专项提升在业内不是新鲜事,跑分追赶的速度可能快于真实体验的追赶。第三,3% 说的是顶尖模型不是全线——前 15 名里中国 3 席,这个数字比 3% 更能说明结构。所以我的判断只在“能力已进入第一梯队”这一层站得住。
手上其实有三个选项
落到动作上,给三种读者各一句。普通用户——找一个手头重复度最高的活儿,用国产模型跑一周,比时间和结果,够用就换。
做工具或副业的——把成本表重算一遍:模型调用成本,以及你能收多少钱。能力不再是护城河,能不能收上钱才是。想找一个能长期用的国产主力模型做底座,可参考 DeepSeek V4.1 Flash(DeepSeek 推出的原生多模态低成本主力模型)。
看行业的人——把注意力从“谁跑分高”挪到“谁在收钱”。接下来一年关于中美 AI 的讨论,重心会从能力转到商业模式,这也是国内最薄的一环。
结论放这儿
我的结论是:中美模型的能力差距已经收窄到可以忽略竞争的地步,但商业差距没有同步收窄——接下来真正决定输赢的,不是谁再快 3%,是谁先找到愿意付钱的人。
关于中美AI差距,集中答三个问题
中美AI差距真的只剩 3% 了吗?
说的是最强模型之间的基准测试得分差,出自彭博行业研究 10 月 5 日报告、经彭博社报道。整体上中国模型仍偏少:LiveBench 前 15 名里只占 3 席。
这对普通人选模型有什么影响?
日常写作、翻译、整理资料这类任务,国产模型基本够用,价格还更低。纠结“国产能不能用”意义不大,拿手上的任务试一周最准。
为什么说中国 AI 赚钱更难?
国内 1100 多个大模型挤在同一条赛道,Token 价格持续下探。彭博报告判断行业盈利可能要到 2030 年。
依据与出处
- 彭博社(2026-10-05):报道彭博行业研究关于中美 AI 模型差距的测算与分析师判断
- 彭博行业研究(Bloomberg Intelligence)(2026-10-05):Robert Lea,3% / 9% / 15% 三档差距与 2030 年盈利判断
- LiveBench 全球榜单(2026-09):DeepSeek V4.1 Flash 81.1 分、全球第 6,前 15 名中国占 3 席
- 联合早报(2026-10-05):区域主流媒体报道,独立印证同一份报告的结论
老高,AI工具箱站长,更关心这些变化对普通人意味着什么。想及时拿到AI行业动态、工具玩法和能落地的创业机会——👉 免费加入AI工具箱交流群
相关文章

 浙公网安备33010202004812号