
老高AI观察 · 第15期|2026 年 9 月 29 日
有一个世界第一,中国 AI 拿到手已经快一年了,但几乎没人开发布会。
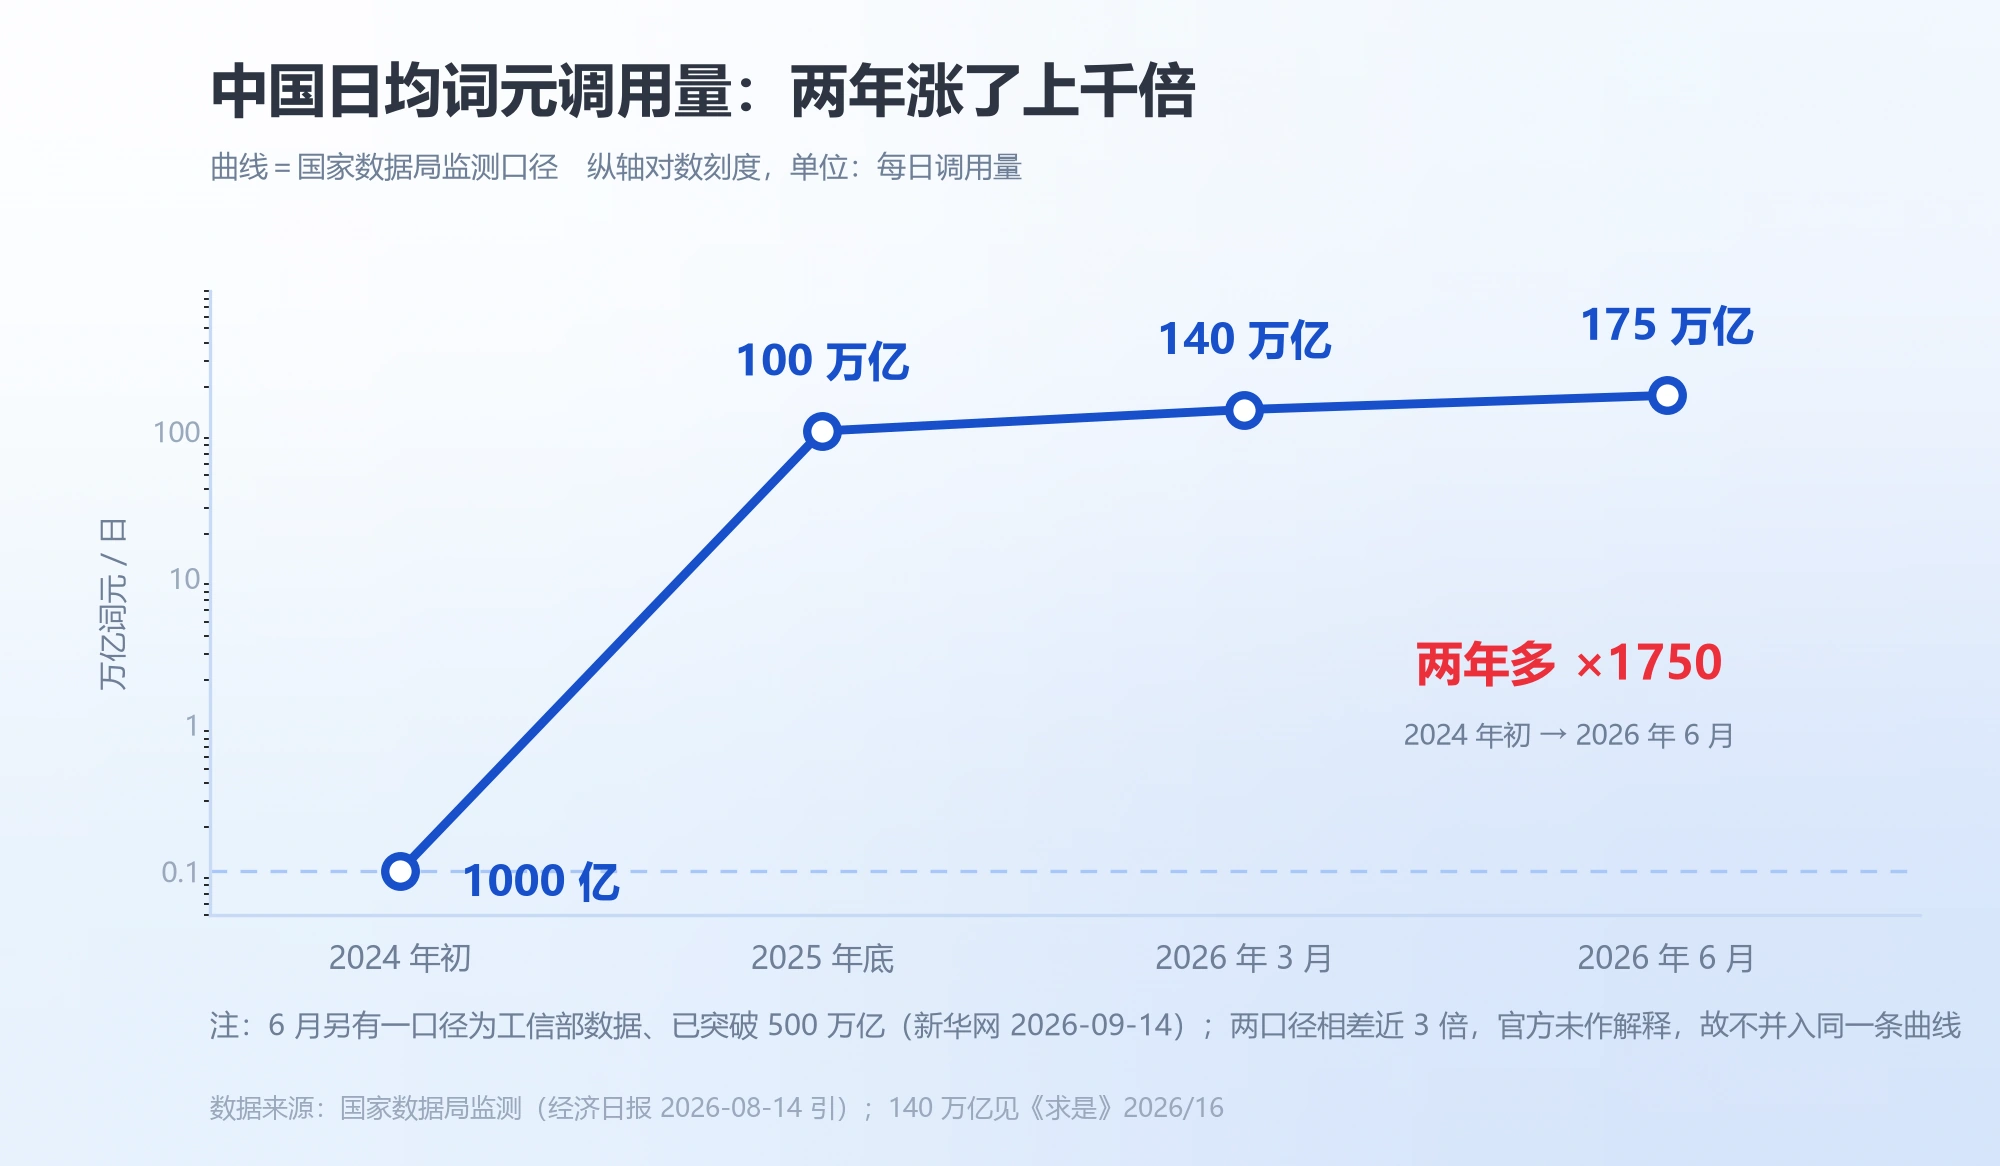
2026 年 8 月 17 日,国家数据局官网挂出一篇解读文章,原刊《求是》。里面有一句很硬的话:2024 年初,我国日均词元调用量是 1000 亿;到 2026 年 3 月,这个数字变成 140 万亿。两年多,涨了一千多倍。
同一个数字的另一面写在官方文件里:国产开源模型的服务价格,对海外闭源旗舰具备”跨数量级优势”。翻译成大白话——我们用的量最多,但每一份卖得最便宜。
所以这个第一,是”用得多”的第一,不是”赚得多”的第一。这个差别决定了接下来一年做 AI 生意的人该怎么挑模型。
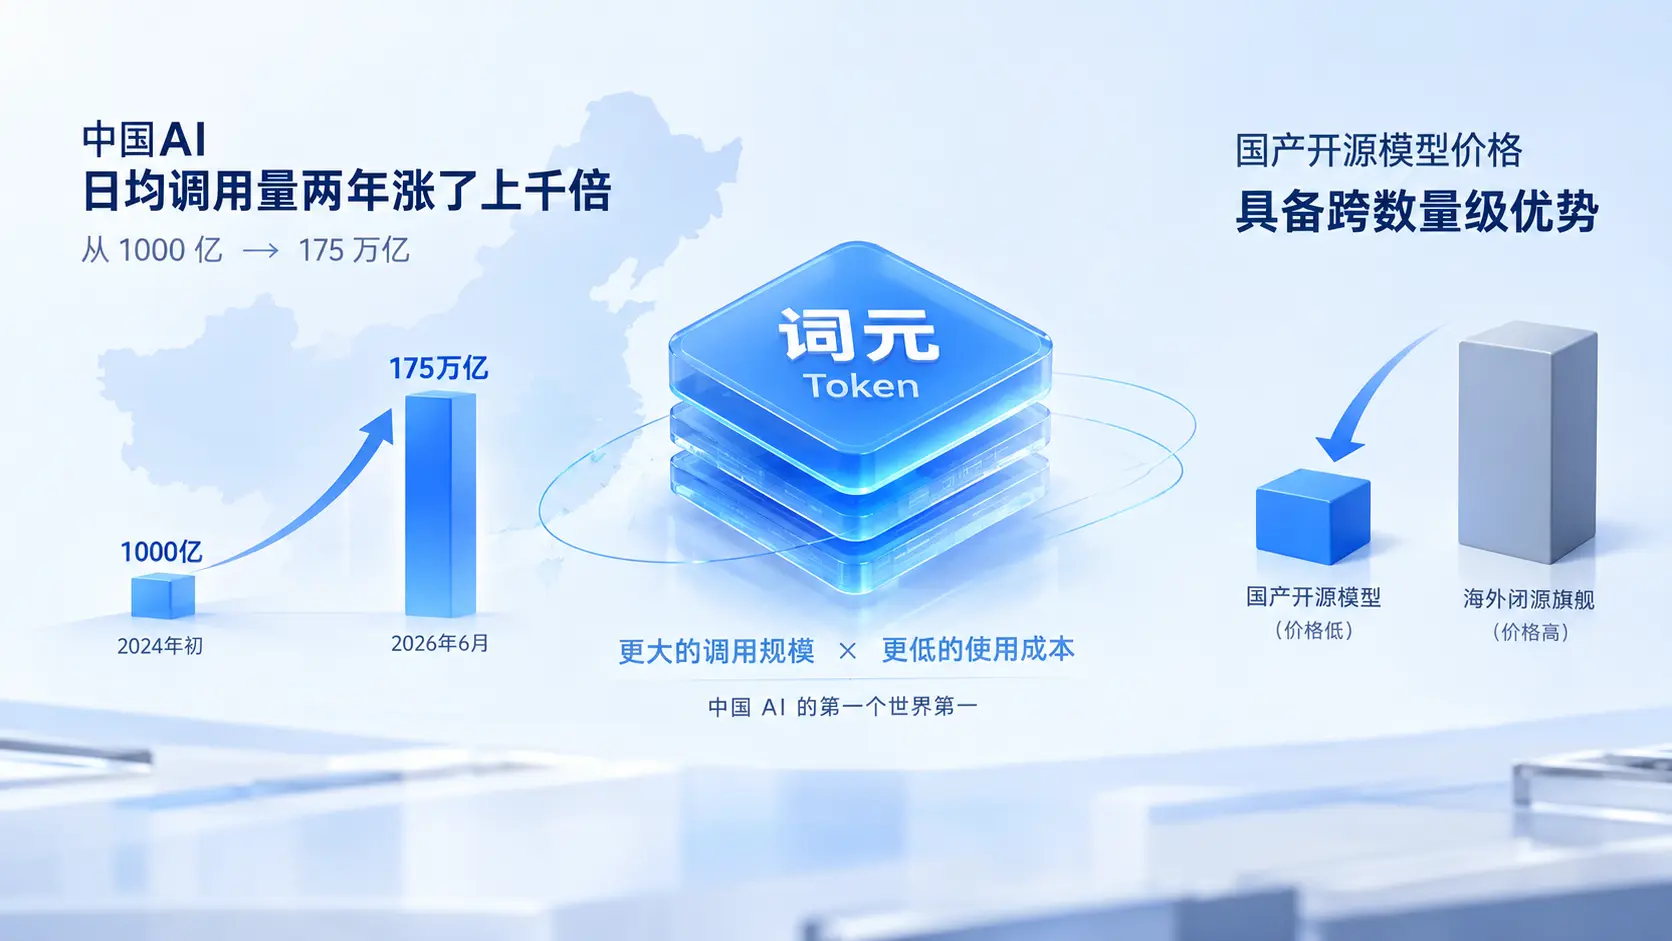
日均调用量两年涨了上千倍
上面的数字出自国家数据局(国家数据局官网的这篇解读)。同一篇里还有一条对照:据全球大模型聚合平台 OpenRouter 统计,2026 年 4 月下旬以来,中国大模型的周词元调用量已连续三个月超过美国,稳居全球首位。
到了 6 月,公开可查的数字开始打架。经济日报 8 月 14 日引国家数据局监测数据,说的是日均调用量”激增至近 175 万亿”;一个月后,新华网 9 月 14 日的报道则写明”工信部数据显示,截至今年 6 月已突破 500 万亿”。同一个时点、同一件事,两个口径差了近三倍。
配套还有两组数:截至 2026 年 8 月,全国累计建成高质量数据集超 12.6 万个、数据总体量超 1815 PB;今年 6 月,北京首家”词元工厂”落地,一期每日词元产能 1.4 万亿个(中国青年报的这篇报道)。
两个数字差在哪,官方没有解释,我不猜。不管按哪套口径算,”量在暴涨”这个方向没有分歧。
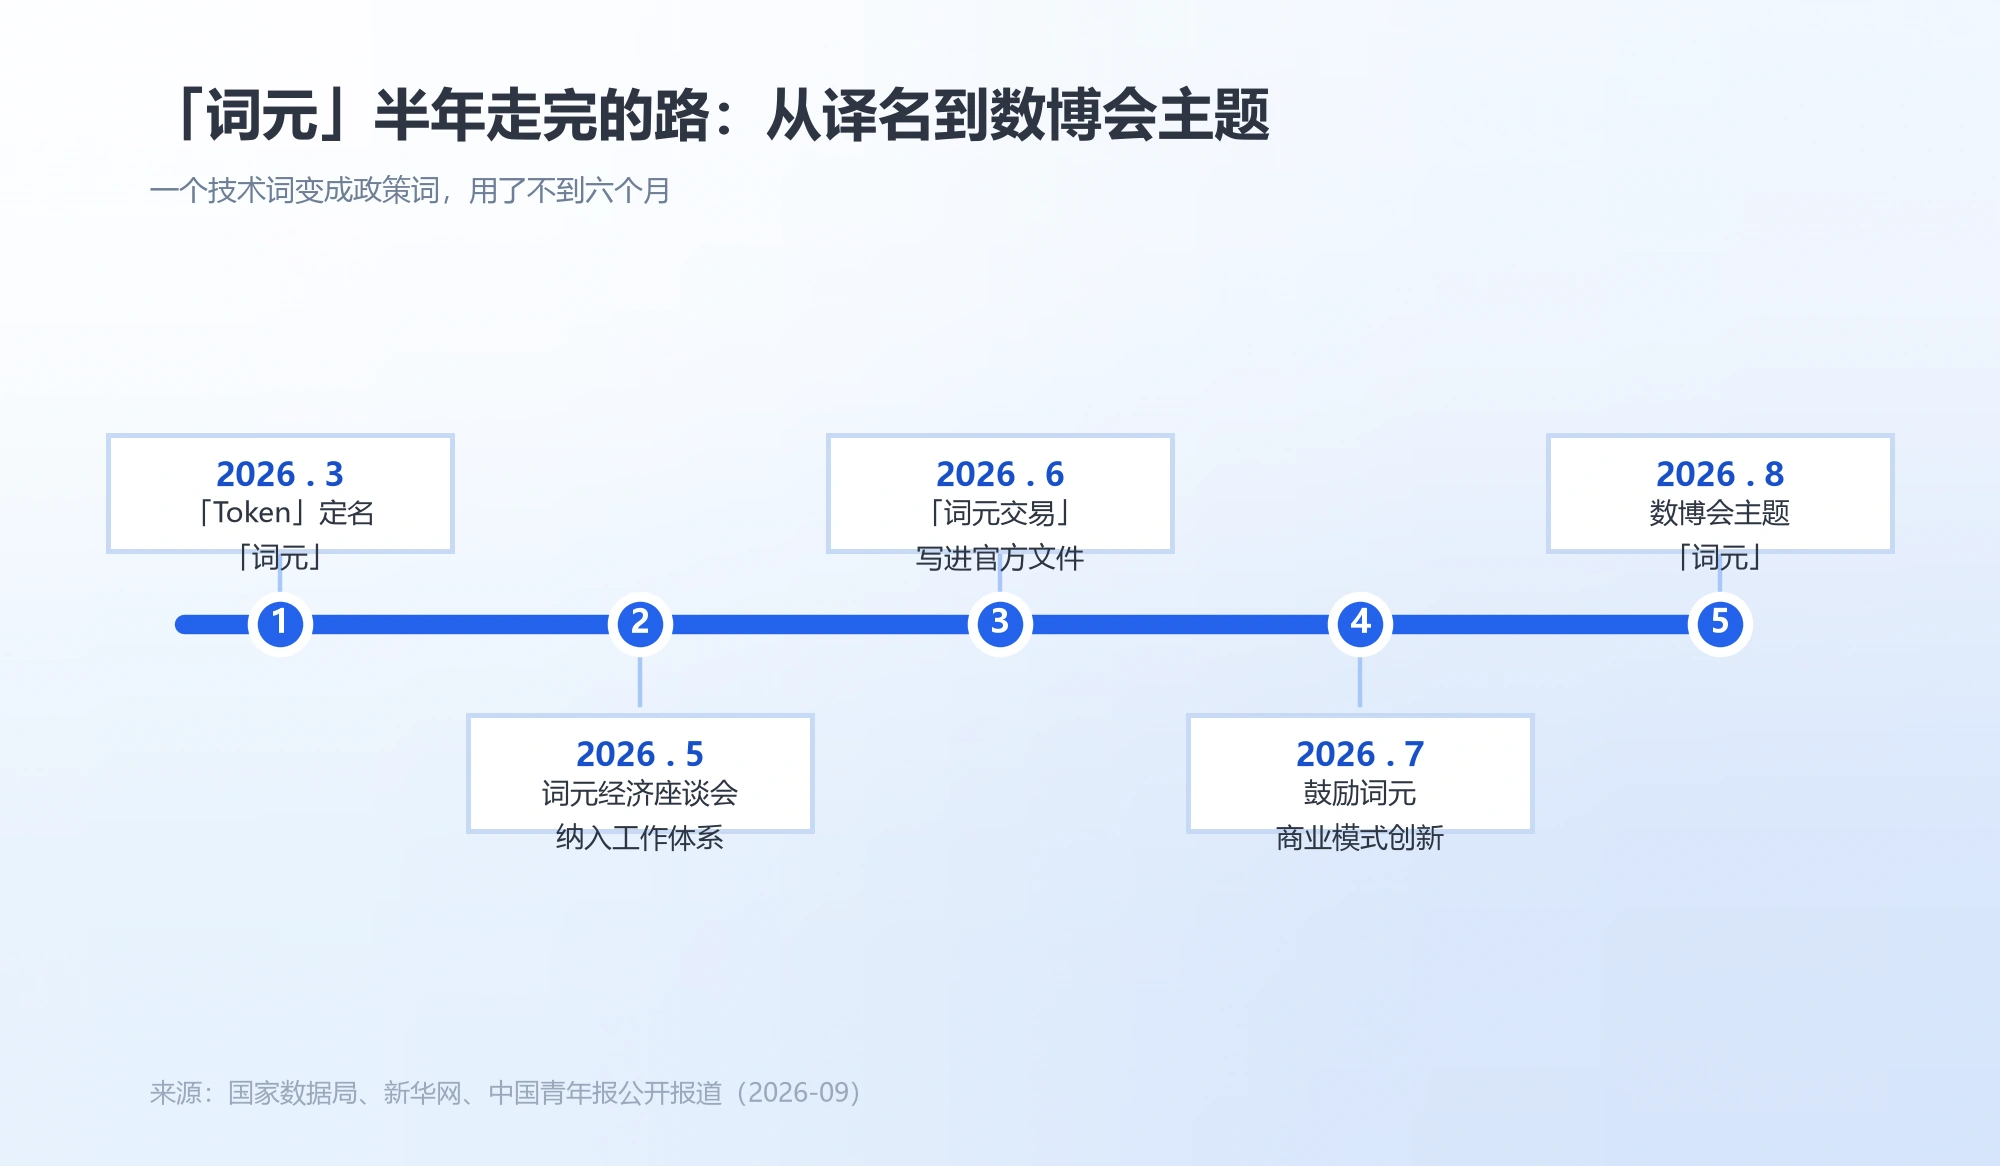
时机比事件更值得看
把 2026 年的动作排一遍,会发现这不是突然冒出来的:3 月,”Token”的中文译名定为”词元”,定位”智能时代的价值锚点”;5 月开词元经济座谈会,纳入工作体系;6 月印发的高质量数据集建设方案里,“词元交易”第一次写进官方文件;8 月底,数博会的主题直接定为”词元——数据要素价值释放新路径”。
我更在意那篇解读里的一个类比:词元之于智能经济,像石油时代的”桶”、电力时代的”度”;紧接着一句是,掌握计量单位等于掌握定义权。半年时间,一个技术名词走完了从译名到展会主题的全流程,这种速度在行业里不多见。
计量单位被写进政策,通常意味着竞争焦点已经从”谁的技术更强”转向”谁的成本结构更好”。技术天花板还能往哪顶,大家心里有数;剩下的战场在价格和效率上。
用量第一的位置,是用价格换来的
先看国家数据局官网的原话:国产开源模型的服务价格,相比美国闭源模型的旗舰版本具备”跨数量级优势”。国家数据发展研究院院长胡坚波在数博会上补了一层——不同场景下词元的价值差异极大,通用对话里百万词元可能只值几元钱,医疗、金融场景能高出去数十倍甚至上百倍。
两句话连起来读,意思很清楚:用量是靠低价堆出来的。国产开源把价格打到地板,换到了全球最大的调用规模。这笔账在市场份额上划得来,在收入上划不来。
这跟前几期写过的海外两家同日降价是同一条线——不是谁比谁便宜,是整个中文市场的价格锚已经被国产开源按住。站内收录的主力里,千问云、LongCat 走的都是低价换量这条路。
单价在跌,总账单不一定会跌
中国金融新闻网 8 月 6 日的一篇分析把这件事说透了:单位词元价格持续下降,但企业的 AI 总支出未必同步减少;模型能力、任务复杂度的差异,又推动词元服务形成分层定价。
这跟DeepSeek 那次涨价并不矛盾。8 月它把部分模型价格抬到原来的 2.3 到 4.5 倍,同时下调了 Flash 的价格——同一张价目表上,便宜的线占入口,贵的线收钱。整体单价往下走,单个厂商往上分层。
那篇分析里还有一句建议原样记住:企业真正需要比较的,不是名义词元单价,而是单位有效任务的综合成本。它解释了一个反直觉现象——价目表上的数字年年降,你的账单不一定跟着降:多轮推理、外部检索、工具调用都会推高一次任务的真实消耗。
降价降的是单价,不是总成本。这话放在聊天里像绕口令,放在预算表上就是真金白银。
谁的位置会被重新定价
普通用户短期基本无感。订阅费和 API 单价是两套账,中间隔着好几层,传到手上时已经衰减得差不多。
做 AI 工具生意的人要重算一次。过去两年很多产品的成本模型建立在”单价会一直降”这个假设上,现在得加个条件:单价降,但你的一次任务可能吃掉更多词元。按次计费的产品尤其危险——收费按次,成本按词元,中间的口子会被悄悄拉开。
还有一类容易被漏掉:内容站、自媒体、做批量内容的小团队。你不直接调 API,但写作、翻译、配图全在调,传导慢一点,方向一样。
换个角度,我可能漏了什么
第一,我把”用量第一”往负面读,可能读偏了。规模本身就是壁垒——调用量堆上去,单位成本会被摊薄,这也正是官方文章里”超大规模市场优势”的意思。
第二,价格低是国产厂商主动选的战略,不是卖不上价。开源换生态位、低价换开发者,这套打法在互联网时代反复出现过,能不能收口,现在下结论太早。
第三,词元只是中间投入。那篇金融分析自己也承认:调用规模与任务质量、生产率、企业价值之间,不存在自动对应关系。拿它当衡量 AI 竞争力的唯一尺子,本身就不完整。
建议你从哪儿下手
第一,选模型别再只看价目表。把一个你真实要跑的任务拿去两家都跑一遍,比一比完成它到底花了多少钱——这个数字才是你的成本。
第二,把功能分层。哪些必须用贵的、哪些换便宜的不影响效果,分开配,比整体换供应商省得多。顺手可以看看站内收录的 豆包 Seed 2.1 这类页面,价格和能力的对应关系比跑分表更直接。
第三,想跟上这条线,可以常翻 老高AI观察——计量单位、定价方式这类变化不上热搜,但它决定的是明年的成本线。
我把判断放这儿
中国 AI 拿下的第一个世界第一,是用价格换来的规模——它说明我们的市场跑得比谁都快,但还没说明我们能把这股规模变成收入;谁能把”用得多”变成”单位任务更便宜”,谁才占住下一轮的位置。
关于词元经济,被问最多的几点
词元到底是什么?
词元是大模型处理信息的最小语义单元,英文 Token。2026 年 3 月,国家数据局把它的中文译名正式定为”词元”,并定位为智能时代的价值锚点。
日均词元调用量为什么有两个数?
国家数据局监测口径的 6 月数据是近 175 万亿;新华网 9 月报道引工信部数据称已突破 500 万亿。两个口径差了近三倍,官方未作解释。
用量全球第一,为什么说赚不到钱?
“第一”指调用规模,不是收入。国家数据局官网明确写到,国产开源模型价格相比美国闭源旗舰具备跨数量级优势——量是靠低价换来的。
本文依据
- 国家数据局官网(2026-08-17,原刊《求是》2026/16):词元定位、140 万亿、OpenRouter 周调用量对比、跨数量级价格优势
- 经济日报/中国经济网(2026-08-14):6 月日均调用量近 175 万亿(国家数据局监测口径)
- 新华网(2026-09-14):”Token”定名时间线、工信部口径 500 万亿
- 中国青年报(2026-09-01):高质量数据集 12.6 万个/1815 PB、北京首家词元工厂日产能 1.4 万亿
- 中国金融新闻网(2026-08-06):词元价格下降、分层定价、单位有效任务综合成本
老高,AI工具箱站长,持续记录AI行业的真实变化。想及时拿到AI行业动态、工具玩法和能落地的创业机会——👉 AI工具箱交流群(免费进)
相关文章

 浙公网安备33010202004812号