
老高AI观察 · 第9期|2026 年 9 月 23 日
9 月 22 日这一天,两家头部实验室做了同一件事:把最贵的那一档模型,价格往下调。
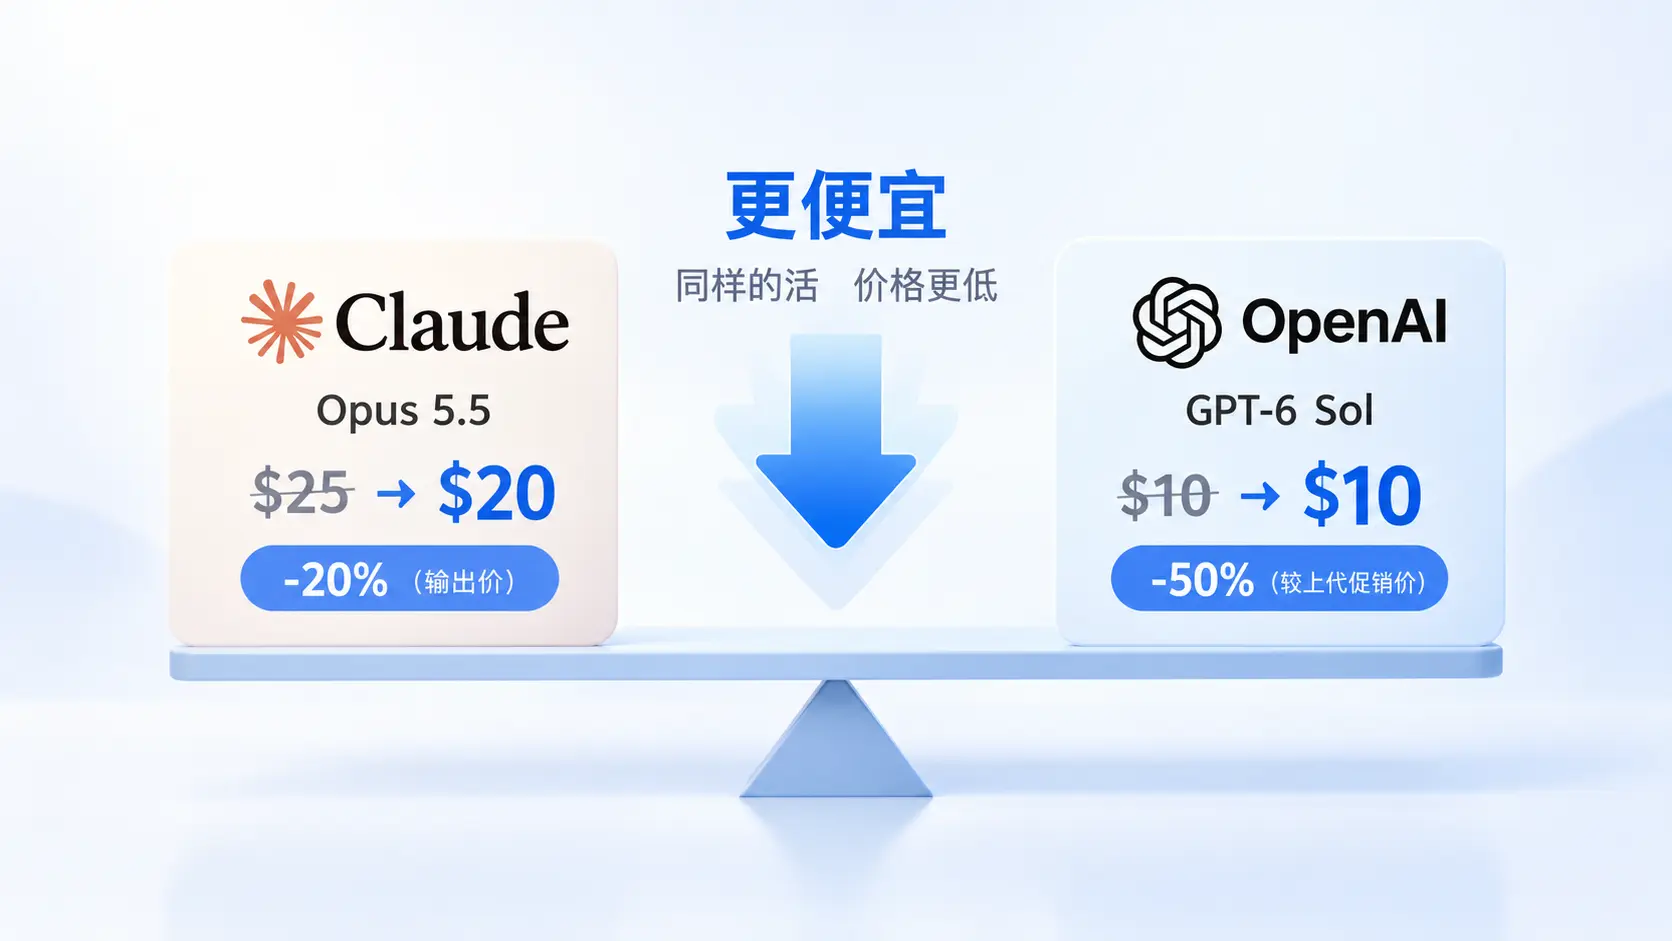
Anthropic 端出 Claude Opus 5.5,Claude 5.5 家族第一款。官方介绍里最要紧的不是它比上一代强多少,而是「比 Opus 5 的运行成本低 40%」。同一天,OpenAI 补齐 GPT-6 的 Sol 与 Luna,价格较上代促销价再降约一半。
我的判断是:头部实验室正在把竞争维度从「谁更强」搬到「同样的活谁更便宜」。而带头降价的那一家,两周前还在公开呼吁这个行业该慢一点。
同一天,两家各自端出了更便宜的旗舰
先说 Anthropic。据其官方公告(署名 9 月 22 日),Opus 5.5 输入/输出价格为每百万 token 4 美元与 20 美元,前代是 5 美元与 25 美元,按 token 单价算降 20%。官方另给了更大的数字:典型工作负载运行成本低约 40%。两者口径不同,后者是 Anthropic 自估的,我不合成「降价 40%」。
性能上是「在多数工作上达到 Claude Fable 5.1 的水平」——追平上一代最强,不是超过。Fable 5.1 定价 10 美元与 50 美元。
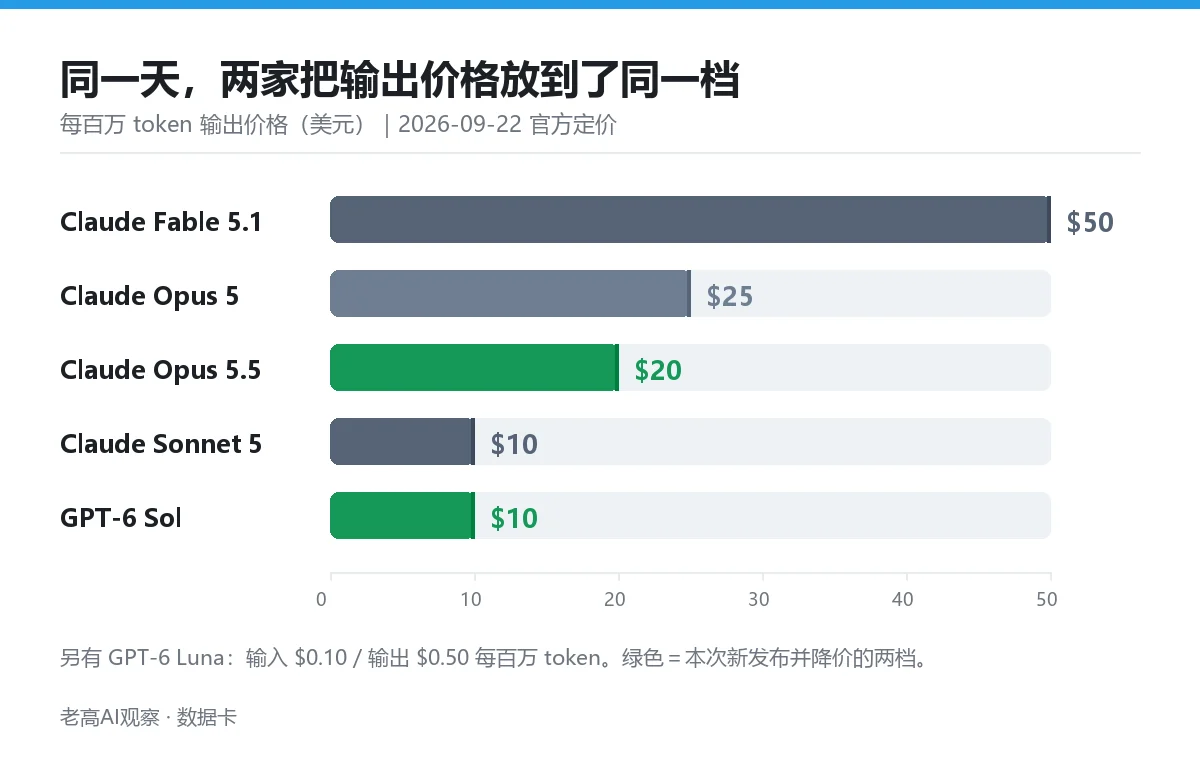
再看 OpenAI。GPT-6 Sol 定价 2 美元与 10 美元每百万 token,较 GPT-5.6 Sol 促销价降 50%;Luna 是 0.10 美元与 0.50 美元,输入降 50%、输出降 58.3%。降幅是对比上代促销价、不是标准价。Sol 的 2 美元与 10 美元,恰好和 Claude Sonnet 5 完全同价。
能力对照上,据 OpenAI 官方博客与开发者社区帖的自家测试:OSWorld 2.0 offline 上 Sol 得 60.5%、Claude Opus 5 得 60.3%,Sol 单任务成本低约 80%。OpenAI 上一代旗舰是 GPT-6 Astra。
这条线的起点比看上去更早
只看 9 月 22 日,很容易读成「两家打价格战」。把时间拉长,这是三条线走到了一起。
第一条是本系列的开篇:AI 巨头集体喊慢。当时的判断是,「慢」是对外说辞,「抢」才是真实动作。两周后最贵那一档自己降了价——这是那句话的第一个硬证据。
第二条是开源与闭源的价差。我在开源模型只差 4 个月那期算过:能力差半年,价格差好几倍。两家这次把最贵的一档往下压,本质是去堵那条价差。
第三条是这周本身:Anthropic 提到 Opus 5.5 发布前经过 METR 与 Frontier Design 两家外部机构的前置测试。一家刚喊完「要慢」的公司,第一款新模型既做了外部安全测试、又降了 40% 成本——说明它现在的首要对手不是监管,是同行。
这次降的不是单价,是「够强」这条线
先补两组事实。一:Opus 5.5 的官方定位是「达到 Fable 5.1 的水平」,追平不是超越。二:在 OpenAI 自己的 OSWorld 测试里,Sol 60.5%、Opus 5 60.3%,差 0.2 个百分点。
两组数字指向同一个结论:新一代模型的能力增量,已经小到进了误差范围。以前旗舰升级的正当性来自「我比你聪明」,这个理由现在说不出口了。
于是升级的理由只剩一个:同样的活,我收得更少。
对下游的人,这个变化比价格本身重要。过去两年选模型的逻辑是「先挑最强的,再压成本」;现在反过来了——先按成本选出几档够用的,再挑表现稳的。
真正被重估的是「够用」两个字
据 OpenAI 公布的数据,AutomationBench 上以 Sol 单任务成本为 1 倍:Astra 3.9 倍、Fable 5.1 8.9 倍、Opus 5 11.1 倍;各档成功率是 33.2%、30.3%、31.4%、26.9%——最大差 6.3 个百分点,成本却差一个数量级(OpenAI 自家口径,非统一第三方测试)。
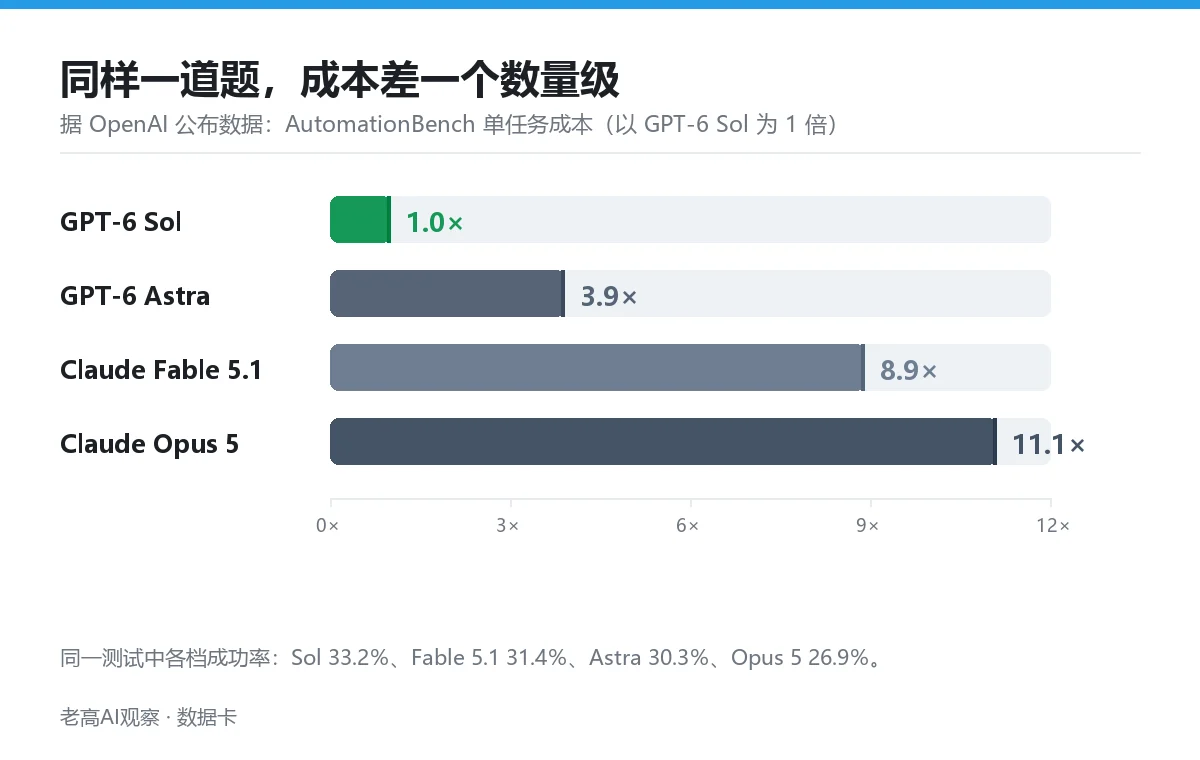
它给的信号很清楚:能力差距缩到几个百分点以内,价格就成了唯一还可比的变量。
「够用」于是被重新定价了。以前它是贬义词,意味着能力上认输;现在是采购语言里最贵的三个字——一旦某档被认定够用,它和更贵那档之间的全部价差,都变成纯利润或纯亏损。
这也解释了为什么降价的是最贵那一档:门槛每往下拉一格,就有一批原本只能看的人变成能买的人。
谁的位置会被重新定价
普通用户最直接的变化:OpenAI 的 Free 和 Go 用户可以在桌面端用 Luna;Anthropic 这边 Sonnet 5.5 与 Haiku 5.5 数周内跟进,中低档跟着降是大概率。
做 AI 工具生意的人要算两笔账。第一笔是单位成本:如果产品跑在 Sol 或 Opus 这一档上,按新价格重算一遍毛利,可能有些原本不划算的玩法突然能跑了。
第二笔更要紧,也更容易算错:别把降价当护城河。价格是厂商随时能改的变量,今天靠便宜建立的差价,明天对方一句话就能抹平。真正留在你手里的是跟单价无关的东西——数据、渠道、用户信任。若想对照这一代旗舰的定价,可参考 Claude Opus 5(Anthropic 上一代的高性能旗舰模型)。
还有一类容易被漏掉:做内容的人。批量生成内容的成本跟着掉。我在AI 训练数据版权战那期写过,内容站在输入端被无偿取用、在输出端又要和机器生成的量竞争——这轮降价把后者成本又压低一截。这条线我在老高AI观察里继续跟。
我的判断里最软的一环
最软的地方在数据来源。前面引的成本倍数与成功率全部出自 OpenAI 自家测试——厂商自测能证明「官方认为这笔账怎么算」,不能证明「独立环境下也是这样」。
第二个不确定是「永久定价」四个字:发言人对媒体说的,不是合同条款。
第三是我没把握的一点:这轮降价多少来自效率提升、多少来自让利。如果主要是后者,它就不是趋势而是一次战术动作,价格随时能弹回去。
接下来你的动作清单
如果你在做 AI 工具,这个月建议做三件事,按性价比排:
- 重算单位成本:主力功能调用量乘上新旧两套价格,看毛利差多少。不用改代码。
- 重排模型档位:把「必须最强」的功能列出来,逐个问「差几个百分点,真感知得到吗」。
- 把省下的钱投到跟单价无关的地方:数据、渠道、内容,而不是直接降价。
如果是普通用户,只需留意免费额度与中低档模型的可及范围——这轮红利不在旗舰降价,在中低档会跟着往下走。
若想直接上手,可参考 Claude(Anthropic 官方模型入口页)。中低档会不会跟着降,才是普通人真正拿得到的那部分。

老高的判断
这次降价的真正含义,不是「AI 变便宜了」,是「AI 的能力竞争正式让位给了成本竞争」。好消息是成本会越来越低,坏消息是你的对手也一样。
关于AI模型降价,集中答三个问题
Claude Opus 5.5 到底降了多少?
两个口径。token 单价从 5/25 美元降到 4/20 美元,降 20%;Anthropic 称典型工作负载运行成本降约 40%。别混成一个。
GPT-6 Sol 和 Luna 的降价是真的吗?
OpenAI 确认是永久定价、不是促销。但 50% 的降幅是对比上一代的促销价。
开源模型会被挤掉吗?
短期看不出来。这轮降价压缩的是闭源内部的价格带;开放权重模型的份额仍在增长,终局我判断不了。
本文依据
- Anthropic 官方公告(2026-09-22):Opus 5.5 定价与性能对标
- OpenAI 官方公告与开发者社区帖:Sol / Luna 定价与测试数据
- 财经媒体转述 Vercel 数据:开放权重模型份额变化
老高,AI工具箱站长,更关心这些变化对普通人意味着什么。想第一时间知道哪些AI工具值得花时间——👉 加入AI工具箱免费社群
相关文章

 浙公网安备33010202004812号