
老高AI观察 · 第8期|2026 年 9 月 22 日
一边在法庭上主张拿新闻训练模型属于「合理使用」,一边在内部备忘录里把它写成「人类历史上最大规模的劳动盗窃」——两种说法出自同一家公司,后者在 2026 年 9 月 17 日被原告写进了解封的诉讼文件。
同一份动议里,微软自己记录的流量数据第一次公开:AI 搜索相对传统搜索,给新闻网站带来的点击率下降八成以上。
我的判断是:值得内容站记住的不是那句狠话,是这组点击率数字。狠话是观点,可以被反驳;流量记录是账本,翻出来就没法再装作没这回事。对一个靠搜索吃饭的独立站来说,这份文件把你每天看到的那条下滑曲线,第一次和平台的内部报表对上了。
被告自己把「替代」两个字写进了内部文件
2026 年 9 月 17 日(美东),纽约南区联邦法院解封《纽约时报》等出版商的简易判决动议删减版,此前涂黑段落首次公开。诉讼起点是 2023 年 12 月《纽约时报》起诉 OpenAI 与微软,此后多家机构加入并合并审理。
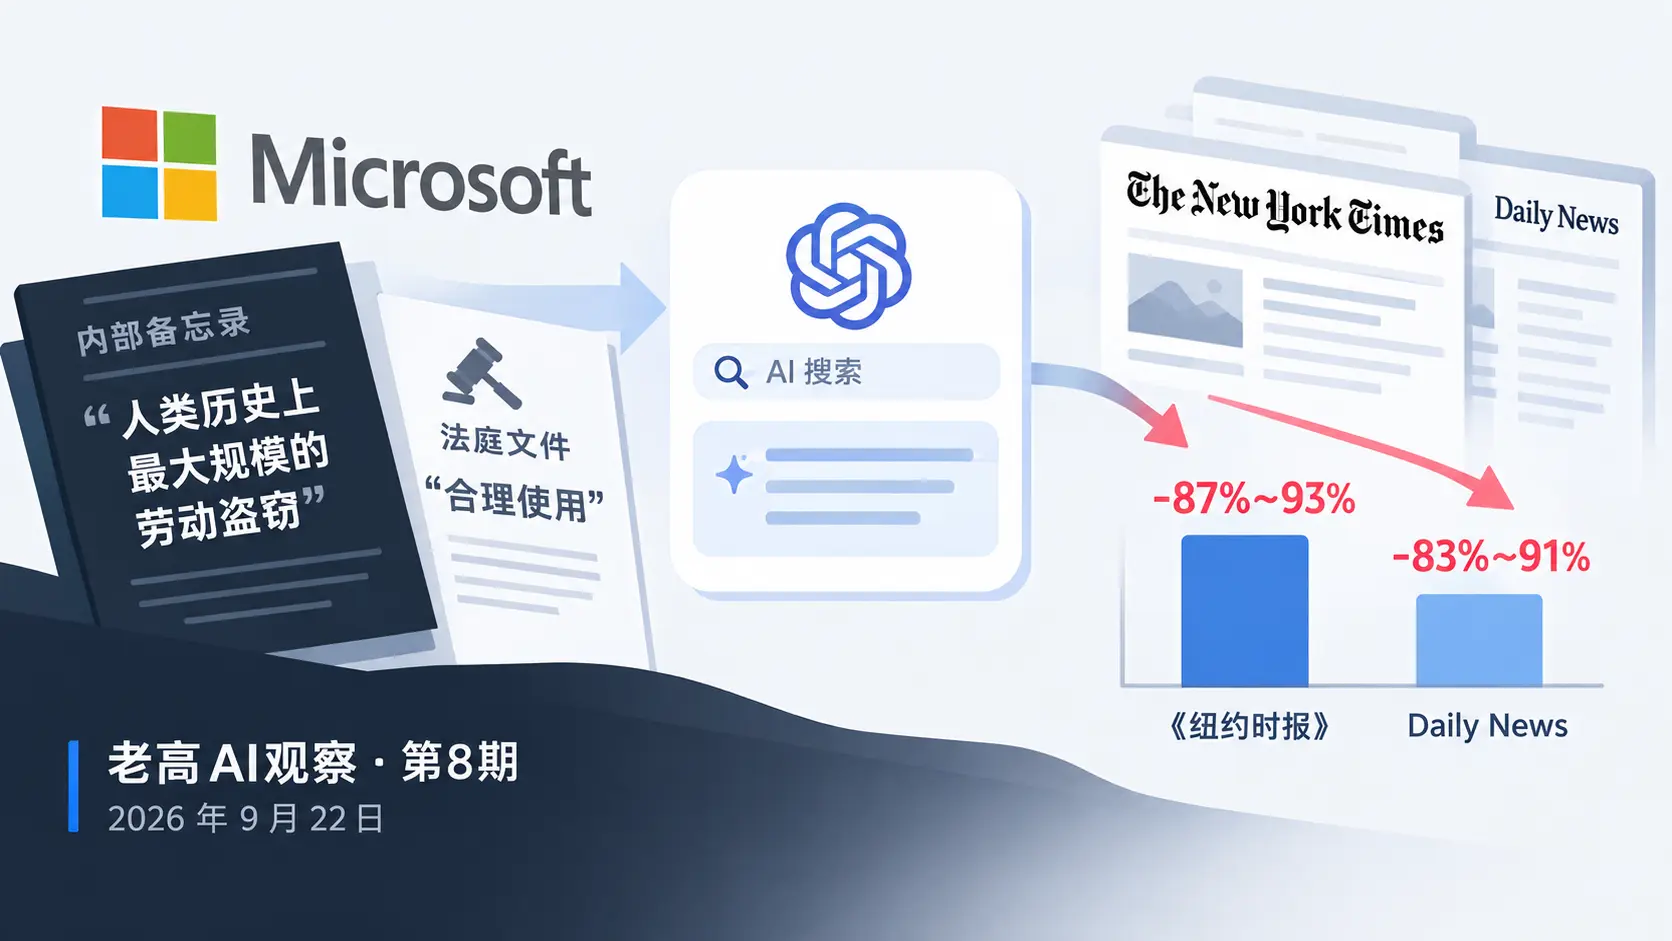
材料里最扎眼的是被告自己的话。据 Ars Technica 报道,微软应用科学总监布伦特·赫希特(Brent Hecht)在 2023 年 1 月的内部备忘录里写道,大模型「卷走」创作者作品是「规模空前的、令人震惊的盗窃」,可能是「人类历史上最大规模的劳动力盗窃」,若「合理使用」抗辩成立,将是对这一理念的「彻底嘲弄」。
OpenAI 旗下 ChatGPT 负责人尼克·特利(Nick Turley)在内部通信里写道,出版商正面临「生存威胁」,产品「在很大程度上是替代性的,就是这样」,且「随着它们变得更好,替代性会越来越强」。微软 CEO 萨蒂亚·纳德拉(Satya Nadella)则宣誓承认,与聊天机器人对话已经「替代」了出版商网站。
微软自己的流量账本也一并公开。据 TheWrap 报道,Bing Chat 相对传统 Bing 搜索,给《纽约时报》网站带来的点击率低 87%–93%,给 Daily News 等原告站点低 83%–91%(中文报道见 澎湃新闻)。
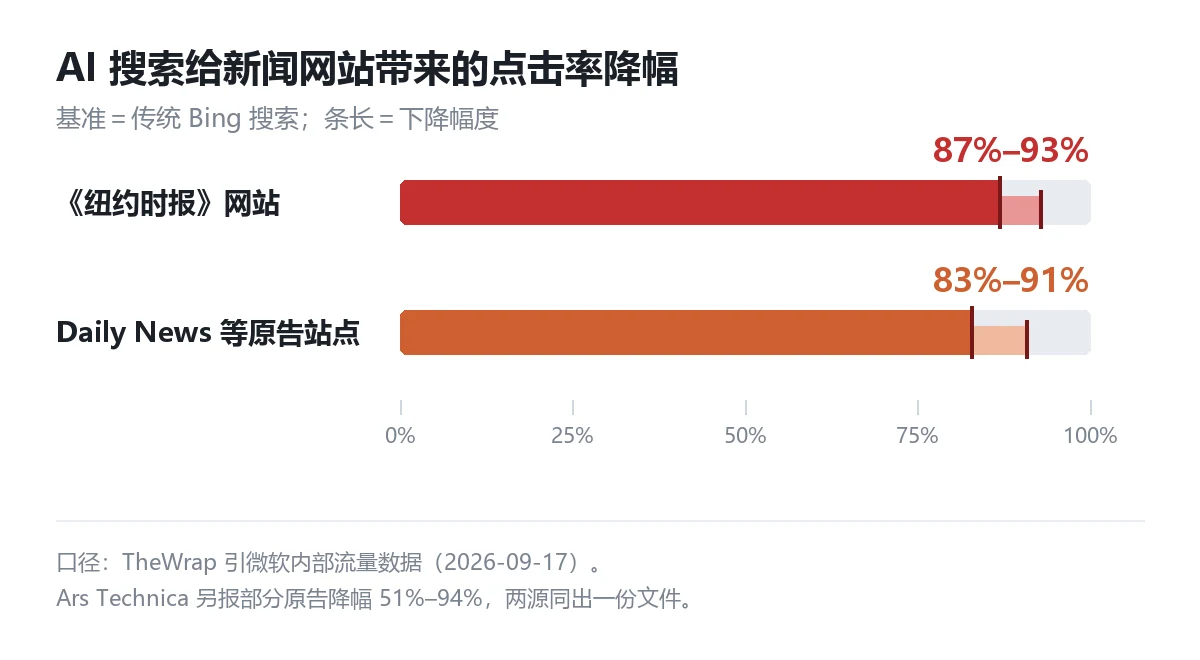
这条数据出自原告动议引用的微软内部记录,不是判决认定;Ars Technica 的汇总口径是「部分原告下降 83%–93%,另一些 51%–94%」,与 TheWrap 略有差异。另外,9 月 1 日美国司法部提交利益声明书支持 OpenAI 与微软,称 AI 训练「极具转换性」。
现在浮出来,不是巧合
内部文件此前被标注为机密,此刻解封是因为案件进入简易判决阶段。原告要主张「市场替代」,就得证明被告自己知道产品会替代被训练的作品——在「合理使用」四要素里,「对原作市场的影响」往往决定性,高管的内部认知是最直接的证据。
另一个前提是替代真的发生了。AI Overviews、Bing Chat、Perplexity、ChatGPT 搜索在过去一年多里从「给出链接」变成「直接给答案」,用户不必再进原文页,「替代」从推测变成了可测量。
还有一个背景:Anthropic 呼吁把控前沿技术节奏,OpenAI 系统披露模型失控案例,Google DeepMind 成立研究院并提议美国主导的模型评估机构——治理与法律压力在同一周到位。
被拿走的不是内容,是下一次点击
内容站的老模式很简单:内容被搜索索引,用户点进来,广告或订阅变成收入。这条链里内容不直接卖钱,卖的是「点击」。AI 搜索改变的不是索引,是「用户要不要进来」。
像 Perplexity 这类产品把答案直接合成在对话里,用户拿到结论就走——内容是原料,访问却不回到内容方。所以问题不是「作品被抄了」,而是「作品被用到了,用完之后没人再来」。这两件事在法律上是两个问题,在收入上是同一个结果。
「内容供应链」这个词,平台自己先说了
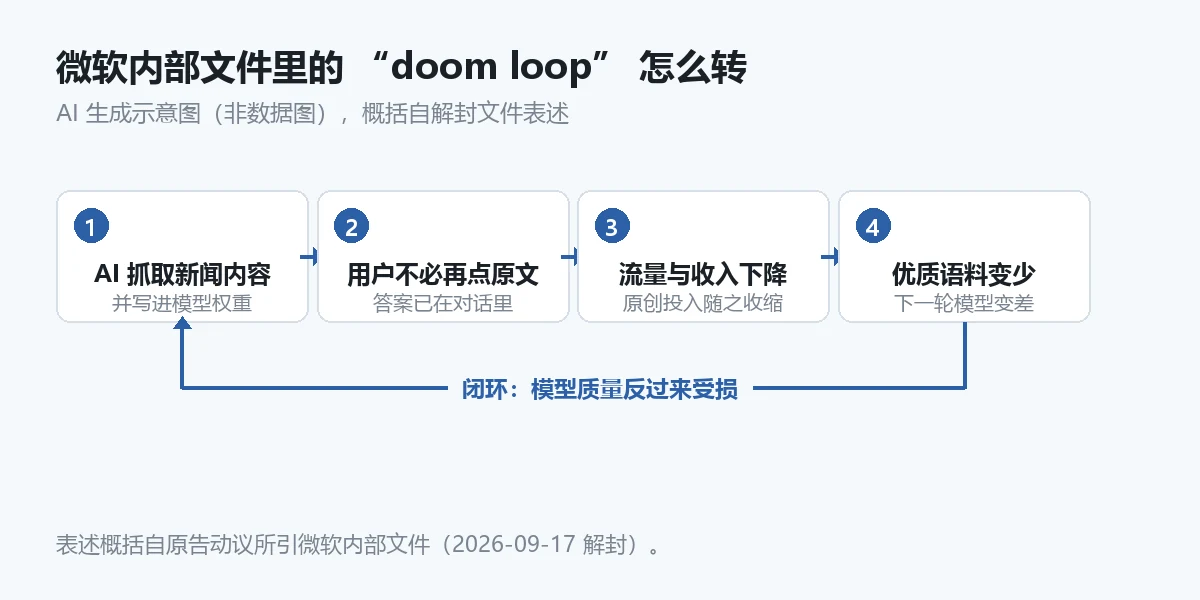
解封文件里有一段比「盗窃」那句更值得琢磨。一份微软内部文件写道:终端产品威胁其关键供应商的经济基础,这极不寻常,但这就是他们为 LLM 业务创造的「内容供应链」现状;该文件把这个机制称为 doom loop——会同时损害模型表现和整个网络。
我的判断是:接下来大概率不是「AI 搜索不抓内容了」,而是分层。付得起授权费的公司可以继续给用户免费答案;付不起的独立 AI 搜索,要么涨价、要么接入别人的授权池、要么消失。技术上,大语言模型的能力本就高度依赖语料质量,语料供给被法律切碎后,有稳定内容来源的一方会拿到结构性优势。
这也是我上一期写 ChatGPT 开始卖对话式广告 时的同一个判断:对话正在变成新的商业界面,界面上的位置越来越贵,而被用来喂这个界面的原料还在按免费算。
被波及的是这些角色
普通用户短期几乎没感觉,该免费的照样免费。中期能感知两点:免费 AI 搜索可能收缩或分层;「引用能不能核对」会变成挑工具的标准——同一句结论,能点进原文的和只能听它说的,可信度不是一回事。
做 AI 工具生意的人要留意三层:一是靠搜索流量吃饭的模式在变薄,把「被搜到」做成「被引用」是最值钱的一步,这也是 Pallas AI 这类可见性工具在解决的问题;二是内容授权会变成资产,有授权池的工具占优,纯聚合、无来源的会被挤出去;三是独立站还有平台短期替代不了的空间——实测、对比、真实体验(相关判断见 AI 职场效率观察)。
这一段说点不利证据
第一,这是动议阶段文件,不是判决。法院尚未认定侵权,最终完全可能判定训练属于「合理使用」。
第二,监管部门此刻不在原告这边。美国司法部 9 月 1 日的声明书支持被告,认为训练「极具转换性」——若法院采信这个框架,上述内部言论的法律杀伤力会小很多。
第三,点击率两源口径不一致,我没读到法院文件原文。第四,微软已把赫希特的言论定性为「员工个人观点」——私下判断不等于公司行为认定。
这几步现在做还不晚
如果这份文件成立,它对独立站的启示不是「去抗议」,而是三条准备:一是别让流量只从搜索来,把一次性访客变成订阅或社群,做法我在 AI 工具站赚钱操作手册 里拆得细;二是做能被引用也能被核验的内容——真实数据、明确出处、跑过的实测,这类内容被 AI 摘要时反而是加分项;三是把「有授权来源」当作选工具的加分项,合规成本接下来会写在价格上。
想亲身感受「答案替代链接」是什么体验,可以参考 Copilot(微软的 AI 助手,也是本案被指控的一方)——它在回答里给的是一段综合结论,而不是一串待点击的链接。

一句话收尾
平台内部管这叫「内容供应链」——说明它清楚自己在吃谁。问题是,被吃的那一方,这周才第一次看到账本。
关于 AI 训练数据版权,几个被反复追问的问题
AI 用新闻训练模型算侵权吗?
法院还没判。美国司法部 9 月 1 日表态支持被告的「合理使用」主张,案件仍在推进中。
点击率下降 83%–94% 是谁统计的?
出自原告动议所引微软内部流量数据。同一份文件两家媒体口径略有差异,不是法院认定结论。
这对普通用户有什么影响?
短期不大。中期可能表现为免费 AI 搜索收缩或分层,「引用能不能核对」成为选工具的标准。
引用来源
- Ars Technica(2026-09-17):解封文件逐条解读与点击率汇总口径
- TheWrap / Yahoo(2026-09-17):Bing Chat 给新闻原告带来的分网站点击率降幅
- 澎湃新闻(2026-09-18):中文报道,含赫希特、特利相关引述与微软回应
我是老高,AI工具箱站长,每天盯着AI工具生态的变化。
关心AI工具怎么真正用到生意里,而不只是看热闹——
相关文章

 浙公网安备33010202004812号