

Jev Search是Search1API 团队开源的AI 搜索引擎,于2026年9月开源,基于 TypeSafe 的 Jev 模型理解提问意图并生成查询词,同时并行调用 12 个搜索引擎,为每条结果打出 0 到 100 的相关性分数并流式展示,同时只返回链接与摘要而不生成总结。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 开源 AI 搜索引擎 |
| 发布时间 | 2026 年 9 月 17 日 |
| 开源团队 | Search1API |
| 开源协议 | MIT |
| 意图理解 | 基于 TypeSafe 的 Jev 模型 |
| 引擎数量 | 并行调用 12 个搜索引擎 |
| 排序方式 | 逐条给出 0 到 100 相关性分 |
| 结果形态 | 只返回链接与摘要 |
| 部署方式 | 可自行托管到边缘平台 |
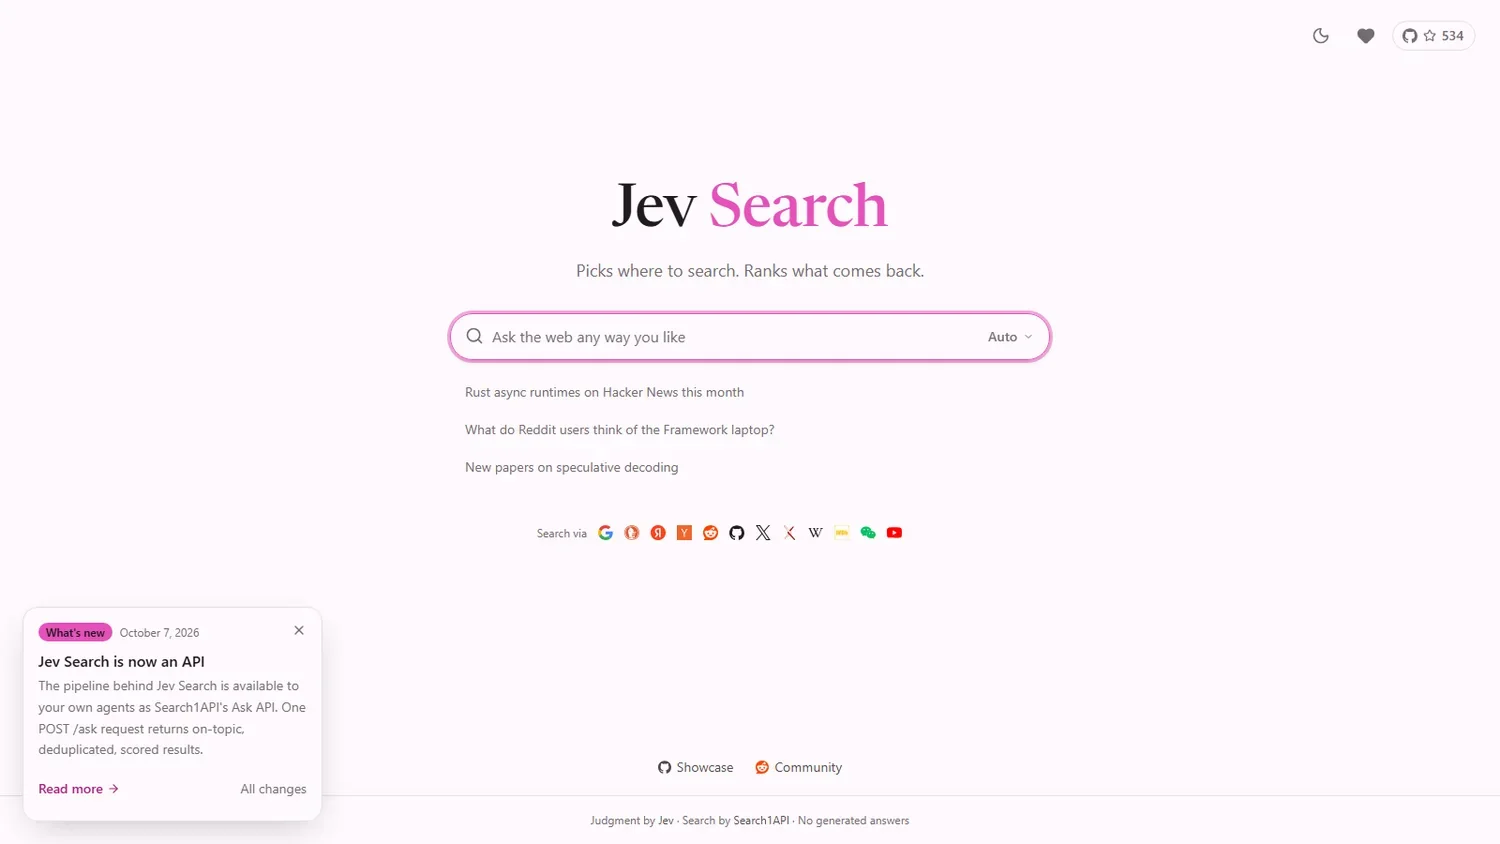
Jev Search 的核心能力
Jev Search 的定位是把搜索过程本身透明化,而不是替使用者总结答案。它由模型负责理解提问意图、选择来源与生成查询词,再由多个引擎并行取回结果并逐条打分,呈现给使用者的是可核查的链接与出处。对需要溯源的研究与核查场景,这种路线与 AI 工具 中偏生成式回答的搜索产品形成差异。
自然语言提问与意图理解
可以直接用日常口语提问,不必自己提炼关键词。Jev 模型会分析需求,确定检索主题、来源范围与时间区间,并把判断结果以标签形式展示在页面上。把意图判断外显,使用者就能知道系统为什么会这样搜。
多引擎并行与容错
系统同时调用 Google、Reddit、Hacker News 与 arXiv 等 12 个搜索引擎,单个引擎失败不影响整体结果。相比自建单一索引,这种方式可以同时覆盖网页、社区与垂直内容,代价是需要依赖底层检索服务的可用性。
相关性打分与流式展示
每条结果都会得到 0 到 100 的相关性分数,低分结果归入单独分组;结果随到随显,先返回的引擎先展示,不必等待全部完成。使用者可以据此判断哪些结果值得优先阅读。
手动覆盖检索条件
来源标签、时间范围与查询词都可以在页面上直接增删修改,系统不会把判断藏起来。对需要精确控制检索范围的专业使用者,这一层可干预性比只能调整对话措辞的方式更直接。
只给线索不给结论与自托管
系统只返回链接与摘要,不生成总结,从机制上避免编造与遗漏;前端以开源协议发布,可部署到边缘平台,检索记录不必经过第三方平台留存,适合对数据流向有要求的团队。
面向使用者的可核查性
把判断过程外显、把结果以链接形式返回,最终指向的是可核查。对需要为结论找到出处的场景,可核查性比一段流畅的回答更重要,因为它留下了可以逐条验证的路径。
结果的组织与展示
结果按引擎返回顺序流式展示,先返回的引擎先显示,不必等待全部完成;低分结果归入单独分组,使用者可以先看高相关内容,再决定是否继续往下翻。
适用边界的判断
如果只需要一段总结式的回答,生成式搜索产品更省事;如果关注的是结果从哪里来、能不能自己复核,把链接与命中来源直接列出的形态更合适。
Jev Search 与同类搜索方案的对比
下表从结果形态、排序透明度与部署方式几个维度,对比 Jev Search 与两款同属 AI 搜索方向的方案。
| 对比维度 | Jev Search | Perplexity | Mistral Agentic Search |
|---|---|---|---|
| 产品形态 | 开源搜索前端 | 商业 AI 搜索产品 | 检索层工具 |
| 结果形态 | 链接与摘要,不生成总结 | 生成总结并附引用 | 向智能体提供检索结果 |
| 排序透明度 | 逐条给出相关性分数 | 排序依据不对外展示 | 依调用方策略而定 |
| 条件可干预 | 来源、时间与查询词可改 | 可限定领域,过程不可干预 | 由接入方在代码层控制 |
| 检索覆盖 | 12 个引擎并行 | 自建索引与合作来源 | 以接口聚合为主 |
| 部署方式 | 可自托管到边缘平台 | 仅官方服务 | 以接口调用为主 |
| 开源情况 | 前端开源 | 闭源 | 以工具形式开放 |
| 适用角色 | 需要溯源的研究与核查 | 日常问答与快速了解 | 智能体开发者 |
上表 Jev Search 一列取自其开源仓库与官方站点,Perplexity 与 Mistral Agentic Search 两列取自各自产品的公开定位。三者处理的是同一次检索的不同环节:Jev Search 把检索过程摊开给使用者看,Perplexity 把检索结果收束成一段回答,检索层工具则把结果交给上层智能体继续处理。
如果希望先了解面向中文资料的搜索产品,可以参考秘塔AI搜索(一款面向资料检索与来源追溯的搜索工具,与 Jev Search 同属可追溯来源的检索方向,差异在于秘塔AI搜索以中文资料与成品检索服务为主,而 Jev Search 把前端与检索过程都交给使用者自行部署与控制)。

Jev Search 的应用场景与适用人群
作为面向可溯源检索的搜索工具,它的典型用途包括:
- 技术调研:限定社区来源检索具体议题,快速聚合开发者的真实讨论而非宣传材料。
- 论文追踪:让系统自动锁定预印本来源,第一时间发现新论文。
- 产品口碑研究:一次抓取多个社区的反馈,对照不同平台的评价差异。
- 竞品与市场监测:限定时间范围检索行业关键词,流式查看各引擎的最新结果。
- 热点多视角核查:同一事件并行检索新闻、社区与垂直站点,对比不同来源的报道。
- 学术资料核查:限定来源检索预印本与数据库,逐条核对引用出处。
适用人群:需要为结论找到出处的research与情报人员、做技术选型与竞品调研的产品与工程团队,以及希望自建检索入口、不希望检索记录留在第三方平台的技术使用者。
Jev Search 的使用方法
官方站点给出的使用路径大致分为四步:
- 访问站点:打开 Jev Search 官方站点,也可以把它添加到主屏幕当作应用使用。
- 输入问题:在搜索框中用日常口语描述需求,不必先提炼关键词。
- 查看判断并调整:来源、时间与查询词以标签形式显示,可点击增删或直接编辑。
- 浏览结果:结果按引擎返回顺序流式展示,每条链接旁标注相关性分数,低分结果归入单独分组;需要自建的团队可按仓库文档配置密钥后自行部署。
Jev Search 的价格方案
Jev Search 前端以开源协议发布,软件本身不收费,使用成本来自所调用的检索接口与模型服务。在自备密钥的前提下按实际用量计费,也便于团队按检索规模自行估算支出。
自行部署需要准备边缘计算平台账号以及检索与模型两套凭据,配置步骤以仓库文档为准。官方站点可直接体验完整流程,建议先在实际检索任务上验证结果质量,再决定是否投入部署与维护。
Jev Search 的常见问题
Jev Search 会给出总结答案吗?
不会。它只返回链接与摘要,不生成总结,从机制上避免编造与遗漏,使用者需要自己判断与归纳。
Jev Search 检索哪些来源?
系统并行调用 Google、Reddit、Hacker News 与 arXiv 等 12 个搜索引擎,单个引擎失败不影响整体结果。
Jev Search 的排序依据是什么?
每条结果会得到 0 到 100 的相关性分数,低分结果归入单独分组;来源、时间与查询词都可手动修改。
Jev Search 怎么收费?
前端开源免费,使用成本来自所调用的检索接口与模型服务,按实际用量计费;自行部署的步骤以仓库文档为准。
Jev Search 需要自己部署吗?
官方站点可直接体验完整流程;前端以开源形式发布,也可以按仓库文档配置密钥后自行部署,把检索记录留在自有环境。
相关文章

 浙公网安备33010202004812号