

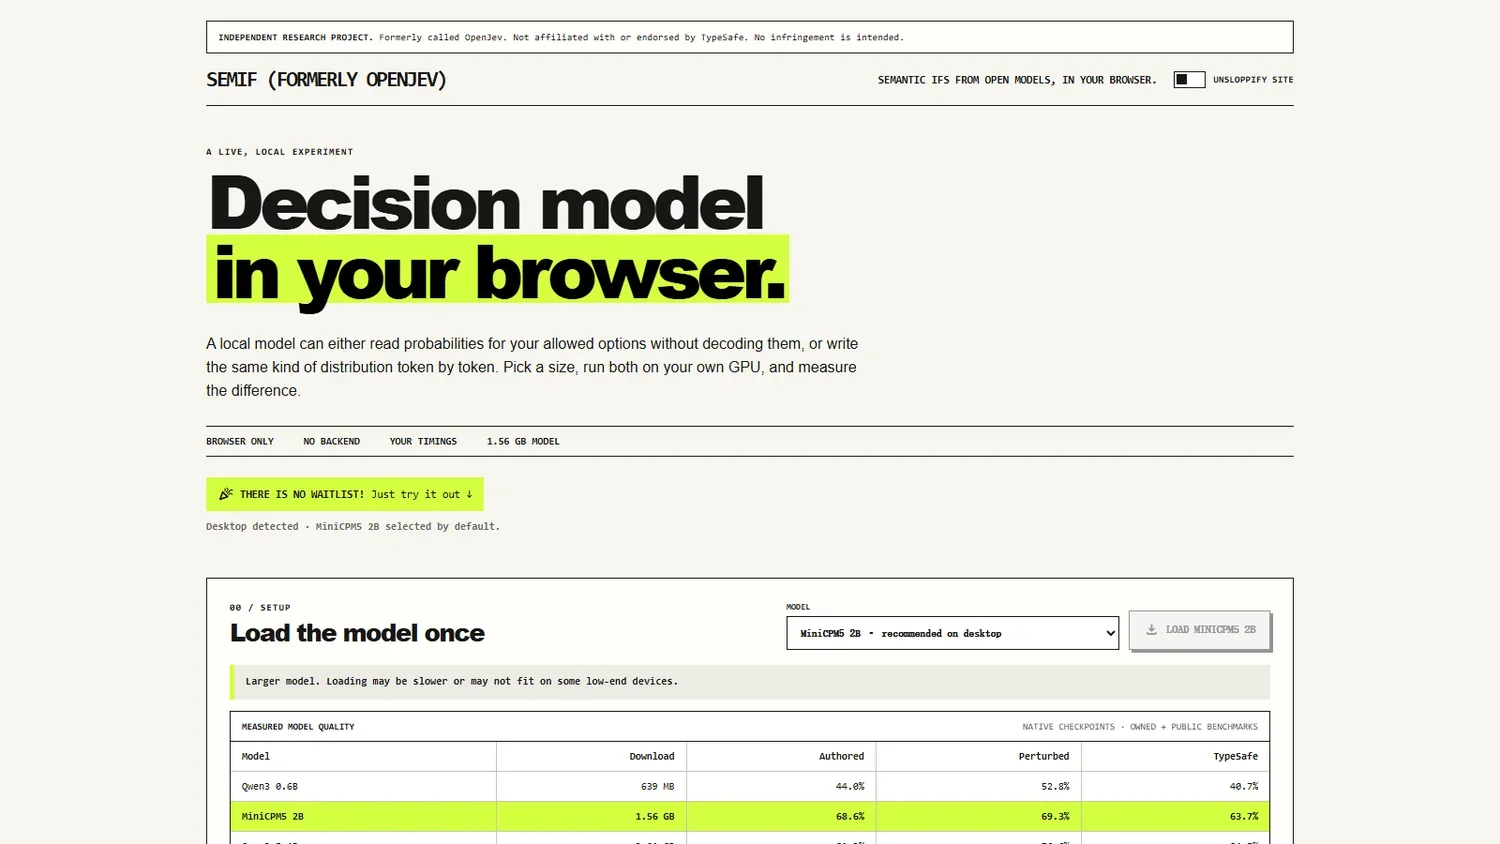
SemIf是开发者 TheoLeeCJ 于2026年9月开源的AI 决策模型项目,主要用于复现 TypeSafe 闭源决策模型 Jev 的语义决策接口,通过单次前向传播直接读取候选选项的数值打分,在单张 RTX 3090 上即可运行。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 开源 AI 决策模型项目 |
| 开源作者 | TheoLeeCJ |
| 发布时间 | 2026年9月16日 |
| 基础模型 | Qwen3.5-4B 等冻结模型 |
| 运行硬件 | 单张 RTX 3090 可运行 4B |
| 决策方式 | 单次前向读取选项打分 |
| 后端支持 | CUDA、MLX、CPU 与 WebGPU |
| 开源许可 | MIT |
| 资源获取 | GitHub 代码与项目官网 |
SemIf 的核心能力
常规做法是让语言模型生成一段答案文本,再从文本里解析出结论,格式出错就要重试。SemIf 换了一条路:不问模型该说什么,而是直接读它对每个候选选项给出的分数。理解这类接口在智能体链路里的位置,可以先了解 AI 智能体 的任务执行方式。
直接打分不做生成
项目把状态与选项描述合并进同一个提示,模型只做一次前向传播,直接读取候选选项对应位置的数值作为概率,不采样任何答案文本。官方说明这一方式比先生成 JSON 再解析快约 5 倍,也不存在格式解析失败的环节。
共享状态复用前缀
当多个判断共享同一份上下文时,前缀只需要预填充一次,之后各个标准可以并行评估。官方给出的数据是共享状态场景的吞吐量从每秒 2.33 个判断提升到最高每秒 20.03 个。
运行时可定义决策
判断标准与候选选项都随请求传入,不需要微调,也不用预先定义任务类型。这让它适合路由、重试判断这类随时会变的小型决策,接入成本主要在于把判断逻辑写成结构化的选项描述。
温度校准
项目内置按工作负载拟合的温度缩放,用来改善输出的概率与真实准确率之间的一致性。官方说明校准后置信度更贴近实际表现,可以直接用于设定自动化流程的阈值。
多后端与低硬件门槛
冻结的 4B 模型在单张 RTX 3090 上即可运行,同时支持 Apple Silicon 的原生后端、CPU 以及浏览器内的 WebGPU 演示,不设等待名单,也不需要向云端服务申请接入。
27B 模型桥接
除冻结的 4B 版本外,项目还提供一条通向 27B 模型的桥接路径,作者用它完成了更大规模的人工决策比对。官方公布的结果显示,27B 桥接在人工决策子集上的一致率达到 0.958,说明同一套打分接口可以随模型能力扩展,调用方式本身不必改动。
SemIf 与同类决策接口的对比
下表从项目性质、硬件门槛与决策机制等维度,对比两个常被放在一起评估的决策方案。
| 对比维度 | SemIf | Jev |
|---|---|---|
| 项目性质 | 独立开源项目,MIT 许可 | 闭源商业托管服务 |
| 决策机制 | 单次前向读取选项数值,不产生输出文本 | 内部机制未公开,对外提供语义决策接口 |
| 接入方式 | 本地部署即可使用,另有浏览器演示 | 需要申请接入 |
| 硬件门槛 | 单张 RTX 3090 可跑 4B 模型 | 云端托管,用户无需自备硬件 |
| 速度表现 | 官方说明 21 个是非判断约 1.02 秒 | 无公开延迟数据 |
| 质量表现 | 与对方公开结果的一致率约 0.845 | 同子集的自一致率约 0.883 |
| 可审计性 | 提示、模型版本与逐行结果均提交仓库 | 内部流程不公开 |
| 适用场景 | 自托管的路由、重试与检索排序 | 需要托管服务、不愿自建硬件的团队 |
上表 SemIf 一列取自其官方仓库与项目说明,Jev 一列取自其公开资料。两者提供的是同一类接口:用结构化选项代替自由文本输出。差别在于实现路径与开放程度——SemIf 冻结现成开源模型、只改读取方式,权重不打补丁,全部提示与结果都可逐条复核;Jev 把机制封装在托管服务里,接入更省事但需要申请。需要把决策过程纳入审计或在内网运行时,前者的可控性更强。
如果想了解这类决策接口通常接入到什么样的执行环境里,可以参考 Manus(通用型自主执行智能体,与 SemIf 同属智能体执行链路上的组件,区别在于前者负责整条任务推进、后者承担其中的判断环节)。

SemIf 的应用场景与适用人群
把决策从文本生成里拆出来之后,常见用途包括:
- 客服工单路由:根据客户描述与账户状态,直接在支持队列的候选选项上打分,实现自动分派。
- 智能体动作把关:在智能体执行高风险操作之前,对候选动作做是非判断,官方给出的复合准确率约为 0.700,可作为第一层防线的组成部分。
- 证据检索与排序:在代码库检索与企业知识库问答中替代传统排序模型,一次前向即给出候选文档的得分,官方给出的知识库问答准确率约为 0.929。
- 推理结论核验:用于判断一段证据是否支持某个结论,校准后的置信度可以直接驱动下游的自动化流程,适合与既有的规则引擎组合使用。
适用人群:需要在本地或内网部署判断组件的开发团队,以及做智能体路由、检索排序与合规核验的技术人员。项目本身仍在早期,官方也提示没有正式版本发布,接入生产流程前建议固定提交版本并在自有数据上验证。
SemIf 的使用方法
从安装到拿到逐行打分结果,可按以下步骤操作:
- 环境准备:安装 Python 3.10 以上版本、CUDA 运行时以及能容纳 4B 模型的显卡。
- 安装项目:创建虚拟环境后执行
pip install -e '.[test]'完成安装。 - 准备输入:编写 JSONL 格式的决策文件,每行包含标识、状态、问题与候选选项列表。
- 运行打分:执行
semif-score --mode direct并指定基础模型、固定版本与输入输出路径,得到逐行的选项概率与耗时。 - 共享状态模式:当所有行的状态完全相同时改用共享模式,前缀只预填充一次,随后并行评估所有判断标准。
- 校准应用:在目标工作负载上拟合温度缩放,让输出置信度与实际准确率对齐。官方项目地址见 SemIf 官方仓库。
建议先在自家数据上固定模型版本跑一轮验证,确认概率与准确率的对应关系,再决定阈值;官方也提示该项目尚未发布正式版本,接入时应当锁定提交版本,避免上游更新带来行为漂移。仓库把固定的提示、模型版本、提示哈希与逐行输出都一并提交,连已知的失败样例也保留在内,便于把一轮结果逐条复核。
SemIf 的价格与开源情况
SemIf 采用 MIT 许可开源,打分库、命令行工具、基准脚本与浏览器演示都可以自由使用,也可以用于商业项目。项目本身不附带模型权重,所用基础模型沿用各自的上游许可,商用前需要分别确认。
项目不收取任何费用,也没有需要申请的密钥;成本主要来自本地算力,官方给出的参考是一张 RTX 3090 即可运行 4B 模型。若是把判断接入高并发流程,还需要按吞吐需求评估显卡数量。
SemIf 的常见问题
SemIf 和 Jev 是什么关系?
SemIf 用开源模型复现了 Jev 的语义决策接口模式,即用结构化选项代替生成文本;项目独立开发,与 TypeSafe 没有隶属关系,官方也在仓库中作了说明。
SemIf 需要什么硬件?
冻结的 4B 模型在单张 RTX 3090 上即可运行,同时支持 Apple Silicon、CPU 以及浏览器内的 WebGPU 演示,不需要向云端服务申请接入。
SemIf 的置信度可以直接用吗?
项目内置按工作负载拟合的温度校准,让输出概率与实际准确率更接近;官方建议在自己的数据上验证后再用于生产流程的阈值判定。
相关文章


 浙公网安备33010202004812号