

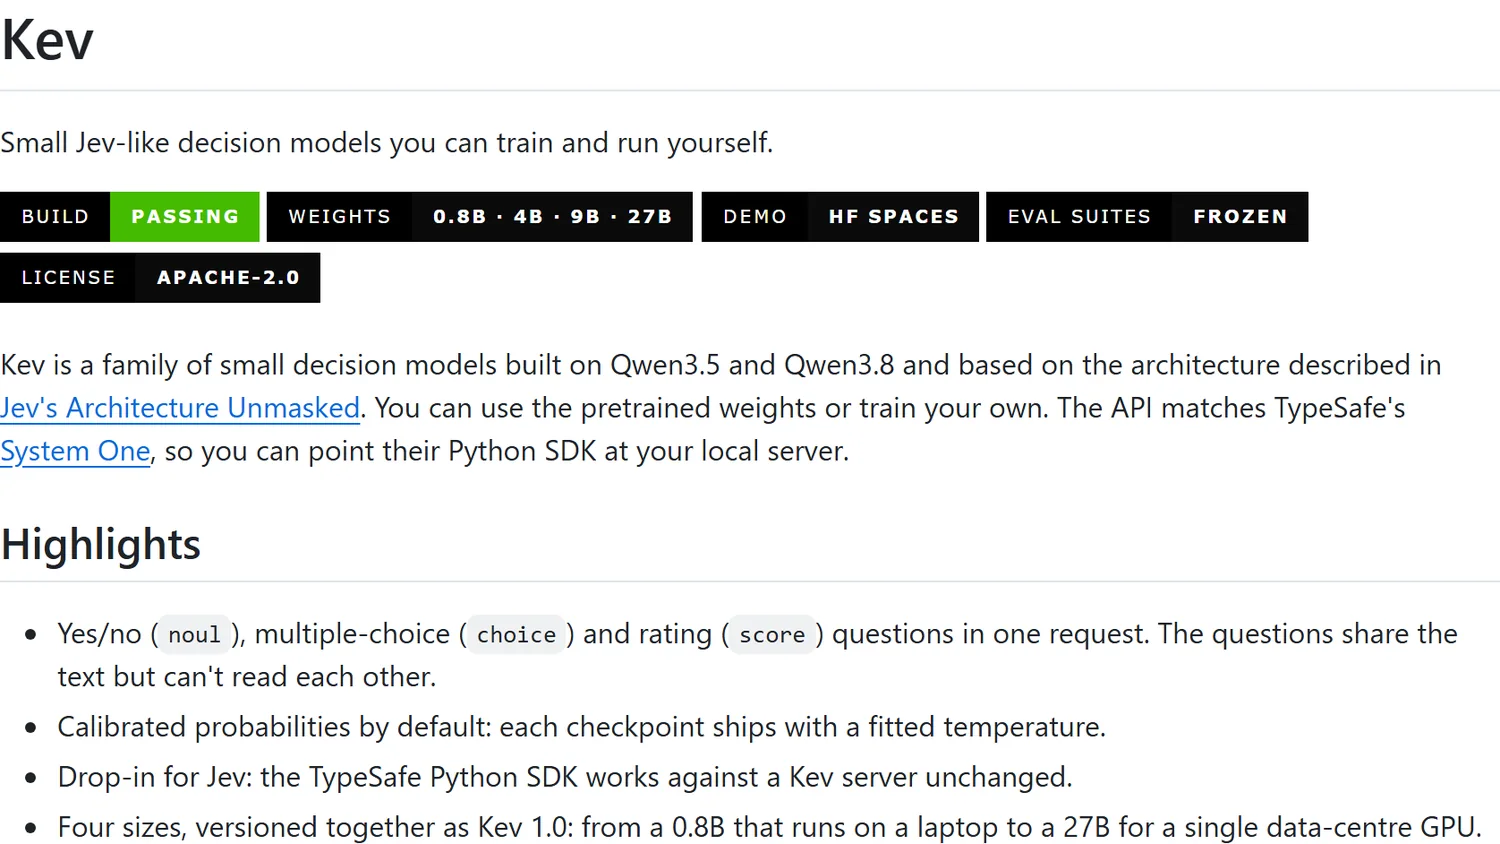
Kev是由Cognition 工程副总裁 Jared Palmer开源的决策模型家族,于2026年9月开源,基于 Qwen3.5 与 Qwen3.8 基座提供 0.8B 至 27B 多档模型。它不生成文字,输入状态文本与结构化问题后单次前向直接输出校准概率,支持是 / 否、选项路由与等级打分三类决策,可自训练并在本地部署。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 开源结构化决策模型家族 |
| 发布时间 | 2026 年 9 月 17 日 |
| 开源方 | Jared Palmer(Cognition) |
| 基座模型 | Qwen3.5 / Qwen3.8 |
| 模型档位 | 0.8B / 4B / 9B / 27B |
| 决策原语 | noul、choice、score |
| 接口兼容 | TypeSafe System One |
| 开源协议 | Apache-2.0 |
| 部署方式 | 本地服务或云端托管 |
Kev 的核心能力
Kev 的定位是把大模型的写作题改造成选择题:它冻结基座权重,外挂适配器与指针头,一次前向传播直接输出每个选项的校准概率,全程不生成解释性文字。对需要在高并发下做判断的团队,这种形态与 AI 模型 中偏生成式输出的路线互补:生成模型负责写内容,Kev 负责做分流与判定。
单次前向输出校准概率
输入一段状态文本与若干结构化问题,模型一次请求返回每个选项的校准概率,可以按阈值直接分流。由于省去了逐 token 生成,单次调用的时延与算力开销都显著低于让通用模型输出一段判断文字再解析。
三类决策原语与批量提问隔离
支持是 / 否、选项路由与等级打分三类决策原语。多个问题可以共享同一份输入状态,通过注意力掩码互相隔离,一次前向同时回答多个问题且互不污染,适合客服工单路由、内容审核这类需要并行判断的场景。
校准质量与自带评估体系
官方为每个检查点拟合温度参数,推理时直接输出校准后的概率,温度不改变排序、只调整置信度数值。仓库内置冻结评测集,报告准确率、Brier 分数与校准误差,并由持续集成自动校验发布数字。
低成本微调与自托管部署
支持基于官方检查点用自己的标注数据继续训练,配套的技能包可以让编程智能体自动完成数据整理、训练、评估与部署。部署侧提供一行命令启动本地服务并暴露决策接口,兼容 CUDA、ROCm 与 Apple Silicon 三类硬件。
接口即插即用
服务接口完全兼容 TypeSafe System One,已有的 Jev 应用只需把请求地址指向本地服务即可切换,不必改动业务代码。对已经在用同类决策接口的团队,这意味着可以在不重写调用层的前提下替换底层模型。
与生成式模型的分工
在同一套系统里,生成模型负责产出内容,Kev 负责在链路中做分流与判定。把判断逻辑从生成模型里剥离出来,可以让两部分各自按更合适的方式优化,也便于单独评估判断环节的质量。
适用边界与选型建议
Kev 面向的是需要高频、批量做判断的场景。如果任务本身是生成一段说明文字,通用模型更合适;如果任务是把大量输入分流到若干选项,并希望结果以概率形式留痕,决策模型的形态在时延与调用成本上更有优势。
Kev 与同类决策方案的对比
下表从开源情况、架构路线、模型档位与成本几个维度,对比 Kev 与两款同为结构化决策方向的方案。
| 对比维度 | Kev | Jev | SemIf |
|---|---|---|---|
| 产品性质 | 开源决策模型家族 | 闭源商业接口 | 开源决策模型 |
| 开源协议 | Apache-2.0 | 未开源 | 开源发布 |
| 基座与架构 | Qwen 基座加指针头 | 未公开 | 决策模型路线 |
| 模型档位 | 0.8B 至 27B 四档 | 单一托管模型 | 单档开源模型 |
| 输出形式 | 单次前向输出校准概率 | 输出结构化决策结果 | 输出结构化决策结果 |
| 推理速度 | 单机可批量推理 | 受接口网络延迟限制 | 依部署环境而定 |
| 成本 | 权重免费,自托管无调用费 | 按调用量付费 | 开源免费 |
| 数据位置 | 本地或自有服务器 | 经由第三方接口 | 可本地部署 |
上表 Kev 一列取自其开源仓库与官方发布说明,SemIf 与 Jev 两列取自各自项目的公开信息。三者的路线差异集中在打开程度:Kev 把权重、训练代码与评测集一并开放,SemIf 提供开源模型,Jev 以托管接口交付,选择哪一种取决于团队对数据位置与自主可控程度的要求。
如果希望先了解把模型能力编排成业务流程的方式,可以参考 Coze(一个面向智能体搭建的开发平台,与 Kev 同属为上层应用提供判断与编排能力的环节,差异在于 Coze 交付的是对话与流程编排环境,而 Kev 交付的是可自托管的决策概率输出)。
Kev 的应用场景与适用人群
作为面向结构化判断的模型家族,它的典型用途包括:
- 客服工单路由:一次前向同时判断转哪个部门、是否需要人工介入与客户情绪等级,按概率阈值自动分流。
- 内容安全审核:对用户生成内容并行执行是否违规、违规类型与严重程度三类判断,高置信结果自动处置。
- 金融与信贷初审:判断投诉类型与风险等级,用概率分布辅助合规留痕与人工复核排序。
- 电商意图分类:把用户查询路由到搜索、推荐或售后等下游系统,处理一个词同时命中多个类目的情况。
- 批量离线判定:在夜间批处理中完成大规模标注筛选,把低置信样本留给人工。
- 内容标签预判:为海量内容预判主类目与置信度,把低置信样本留给人工复核。
适用人群:需要把判断逻辑从通用模型里剥离出来、对时延与调用成本敏感的算法与工程团队,以及要求数据不出内网的金融、医疗与政企技术团队。
Kev 的使用方法
官方仓库给出的接入路径大致分为四步:
- 环境准备:安装 Python 3.12 或 3.13 与
uv,克隆 Kev 官方仓库后执行uv sync --extra serve安装依赖。 - 本地启动服务:执行
KEV_DTYPE=bf16 uv run --extra serve python -m kev.serve --run jaredpalmer/kev-4b --port 8009启动推理服务,首次运行会自动下载权重。 - 发送决策请求:向
POST /v1/systemone提交状态文本与问题列表,接口返回各选项的校准概率。 - 微调与评估:整理标注数据后基于官方检查点继续训练,并在冻结评测集上验证效果后再上线。
Kev 的价格与开源情况
Kev 以 Apache-2.0 协议开源,权重、训练代码与冻结评测集全部公开,自托管推理不产生调用费用。官方公布的三档移植训练总花费约 95 美元,个人基于官方权重微调一次约 1 美元,完整账单公开可查,便于团队评估真实投入。
部署成本主要取决于自有硬件。官方在 H100 上实测回答 6 个问题耗时约 18 毫秒,也可以选择按需计费的云端推理服务,闲置时缩容到零不计费。对需要批量决策的团队,自建推理通常比按调用量付费更容易控制长期成本。
Kev 的常见问题
Kev 会输出解释性文字吗?
不会。Kev 不做文本生成,输入状态文本与结构化问题后单次前向直接输出每个选项的校准概率,因此不存在生成内容被误读的问题。
Kev 和 Jev 是什么关系?
Kev 是由 Cognition 工程副总裁 Jared Palmer 参考 Jev 的架构思路复现并开源的模型家族,接口兼容 TypeSafe System One,已有应用改指向本地服务即可切换。
Kev 需要什么硬件配置才能运行?
官方提供 0.8B 到 27B 四档模型,服务端兼容 CUDA、ROCm 与 Apple Silicon,可以按算力条件选择档位;训练与推理的完整代码与评测集均随仓库公开。
Kev 开源吗?
是。权重、训练代码与冻结评测集按 Apache-2.0 协议开放,可自训练、可审计、可自托管。
Kev 有哪些决策类型?
支持是 / 否判断、选项路由与等级打分三类决策原语,多个问题可在一次前向中并行回答并保持互相隔离。
相关文章

 浙公网安备33010202004812号