
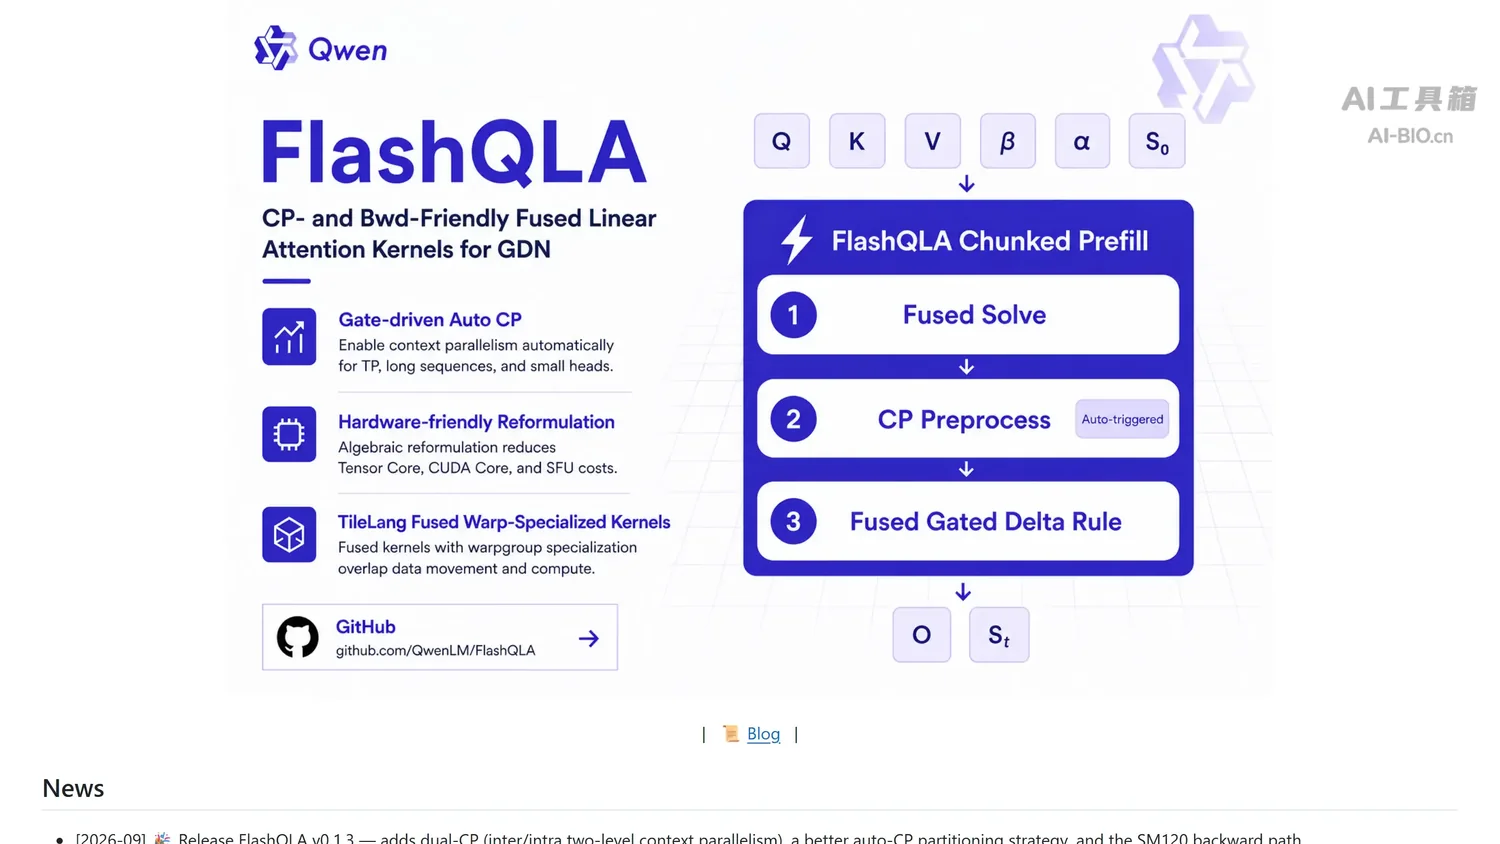
FlashQLA 是一款由通义实验室于 2026 年 6 月发布首个公开版本的线性注意力算子加速库,主要用于加速 GDN 分块预填的前向与反向计算,支持算子融合与门控驱动的卡内序列并行,适用于长上下文预训练、端侧智能体推理与注意力算子优化等场景。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 面向 GDN 的线性注意力算子库 |
| 出品方 | 通义实验室 |
| 发布时间 | 2026 年 6 月 30 日(首个公开版本) |
| 开源协议 | MIT |
| 实现基础 | 基于 TileLang 编写 |
| 加速幅度 | 前向约 2 至 3 倍、反向约 2 倍(对 FLA Triton 实现) |
| 适用硬件 | NVIDIA SM90、SM100、SM103、SM120、SM121 |
FlashQLA 的核心能力
FlashQLA 只做一件事:把 GDN 的分块预填算得更快。它的三条优化都围绕同一个瓶颈——算子之间的搬运与空闲,而不是改数学。
按门控特性自动开并行
GDN 的门控带指数衰减特性,作者据此把序列切成卡内可并行的段,在张量并行、长序列与小头数场景下自动生效。好处是不需要人工调切分策略,可提高 GPU SM 利用率。 同属推理侧加速的站内项目 DSpark 走的是解码阶段的另一条路。
重写代数形式减少搬运
前向与反向的计算流做了代数层面的重排,减少 Tensor Core、CUDA Core 与 SFU 之间的往返。官方强调这一步不牺牲数值精度,但代数重排不等于与原始实现逐位完全一致,替换后仍应针对前向输出与反向梯度做数值比对。
融合 kernel 取代拆解实现
既没有把流程拆成一串独立 kernel,也没有硬融成单个巨 kernel,而是按序列并行与反向的需求做 Warp-Specialized 融合。这个折中点是它相对通用实现的主要差距来源。 若关注的是整条推理链路的调度而非单个算子,站内 DeepInfer 是另一个层面的参照。
跟着接口演进的版本节奏
从 v0.1.1 到 v0.1.3,项目逐步补齐反向卡内上下文并行、SM100 支持、SM120 前向、双层上下文并行与 SM120 反向,并引入 AutoCP v2 自动分区策略。对使用者来说,升级前先看目标 GPU 架构是否已在支持列表里。同属长文本加速方向的站内项目 RedKnot 可以做横向参照。
FlashQLA 与同类算子实现的对比
下表从形态、实现基础、加速幅度与接入方式等维度,把 FlashQLA 与它的参照实现放在一起对照。
| 对比维度 | FlashQLA | FLA(Triton 实现) | TileLang |
|---|---|---|---|
| 形态 | 线性注意力算子库 | 线性注意力参考实现 | kernel 编写语言与编译器 |
| 实现基础 | TileLang | Triton | TileLang 自身的编译与调度 |
| 加速幅度 | 官方报告前向约 2 至 3 倍、反向约 2 倍 | 作为比较基线 | 不直接提供加速比 |
| 适用硬件 | SM90、SM100、SM103、SM120、SM121 | 支持面更广 | 以编译目标为准 |
| 接入方式 | FLA 接口后端或框架内替换 | 作为库直接调用 | 作为底层被调用 |
| 开源协议 | MIT | 开源 | 开源 |
| 主要用途 | 预训练与端侧推理的 GDN 加速 | 通用线性注意力计算 | 编写自定义注意力 kernel |
- 表格内数据来源:FlashQLA 取仓库 README 的 News、安装要求与描述;FLA(Triton 实现)作为官方对比基线,倍数取 FlashQLA README 所列数值;TileLang 取项目官方说明;未公开的项不作推测。
- 产品对比简述:FlashQLA 在实现基础上选 TileLang 并给出明确加速幅度;FLA(Triton 实现)在接入方式上作为库直接调用、是通用参照;TileLang 在形态上是 kernel 编写语言与编译器,本身不提供加速比。三者作用层面不同,不可直接换算式比较。
如果关心的是推理链路上的整体加速而不是单个算子,站内的 DeepInfer 从推理框架的角度给了另一套做法。
FlashQLA 的应用场景与适用人群
主要面向使用 GDN 分块预填的模型训练与推理场景,且需按 GPU 架构编译 kernel:
- 长上下文预训练:分块预填的前向耗时占比高,融合后训练步时间下降。
- 端侧智能体推理:小头数与长序列并存,卡内并行能救回利用率。
- 算子基线对比:作为 Triton 实现之外的第二个参照,验证加速是否真实。
- 模型规模不是适配门槛:官方基准基于 Qwen3.5 与 Qwen3.6 系列的头配置,是否适用取决于模型结构与运行配置,而非参数量区间。
适用人群:适合在做线性注意力模型训练或推理优化的算法与工程团队,也适合需要给内部训练框架换算子的平台组;只调 API 做应用的开发者用不上这一层。同门模型侧的实例可对照站内 Qwen-Image-2.1。
FlashQLA 的使用方法
只有本机安装这一条路,从编译到替换再到验证,是一条连续流程。
- 在 仓库 按说明安装,确认目标 GPU 架构已在支持列表内。
- 跑一遍仓库内置的基准脚本,记录前向与反向耗时的基线。
- 换不同序列长度与头数各跑一轮,找出收益最明显的配置区间。
- 通过
flash-linear-attention的标准接口把 GDN 后端指向 FlashQLA,其余代码不动。 - 用同一批输入对比前后耗时,同时校验输出数值与原实现一致。
- 定位自有框架里 GDN 分块预填的实现位置,按仓库接口替换。
- 先在单卡小模型上完成一个训练步,确认梯度与损失曲线无异常。
- 再放大到多卡与长序列,观察通信开销是否抵消了算子层面的收益。
三点要留意:加速幅度是在 Hopper 与 Blackwell 架构上、相较 FLA Triton 实现测得,其他架构需自行验证;算子级加速不等于端到端加速,通信与数据加载可能吃掉收益;替换后务必做数值比对,避免精度问题被性能提升掩盖。
FlashQLA 的项目地址
- GitHub 仓库:https://github.com/QwenLM/FlashQLA
- 官方博客:https://qwen.ai/blog?id=flashqla
FlashQLA 的价格方案
软件本身采用 MIT 开源协议,可免费使用与商用;落地成本在编译、调优与算力上:要按目标 GPU 架构编译 kernel,还要在自家训练框架里改一处调用。
它省的是算力时间。前向 2 至 3 倍、反向 2 倍的加速,直接对应训练步时间的下降;换算成钱就是同样任务占用 GPU 小时数减少。具体能省多少取决于 GDN 在整体计算中的占比,占比低时收益有限。
评估时建议先算一笔账:GDN 算子在单步耗时中的占比,以及它实际能拿到的加速倍数,共同决定端到端收益。若算子占比 10%、加速 3 倍,按上限整体耗时约减少 6.67%;算子占比很低时,即使局部加速明显,对整体训练效率的改善也有限。同类轻量模型的推理成本口径可对照站内 Naive-N0.5-Flash。
FlashQLA 的常见问题
和 FlashAttention 是一回事吗
不是。FlashAttention 针对标准注意力的 IO 优化,FlashQLA 针对 GDN 这类线性注意力的分块预填,做的是门控驱动并行与算子融合,作用对象不同。
支持哪些 GPU
官方安装要求列出 NVIDIA SM90、SM100、SM103、SM120、SM121,并要求 CUDA 12.8 以上、PyTorch 2.8 以上。版本记录里陆续补上 SM100 与 SM120 的前向、反向支持;不在支持列表内的架构不要直接上生产。
会改变计算精度吗
官方表示代数重排与算子优化不会牺牲数值精度,但这不代表与原始实现逐位完全一致。替换后仍应针对前向输出、反向梯度及长序列场景做数值验证。
必须配合 FLA 用吗
不必须。v0.1.2 起可作为 flash-linear-attention 的后端即插即用;也可以在自己的框架里直接调用对应 kernel,只是接入工作量更大。
适合什么规模的模型
官方没有按参数量划分适配范围。FlashQLA 面向的是 GDN 分块预填算子,能否用取决于模型是否采用该结构与相应头配置;官方基准覆盖 Qwen3.5 与 Qwen3.6 系列的多种头配置,具体收益需自行实测。
相关文章

 浙公网安备33010202004812号