
Spark-ASR-2.0是一款由科大讯飞于2026年9月推出的语音识别大模型,主要用于中英文混合、方言与专业术语场景下的语音转文字,支持中英及202种方言免切换识别与文本流畅规范化输出,适用于语音输入、会议记录与智能终端等方向。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 语音识别(ASR)底座大模型 |
| 出品方 | 科大讯飞 |
| 发布时间 | 2026年9月23日 |
| 底座模型 | 星火语音基座 Spark-Audio-1.0-Preview |
| 技术架构 | 非自回归 + LLM 增强自回归协同 |
| 方言覆盖 | 中英及202种方言免切换 |
| 推理成本 | 较上代仅增加约10% |
| 落地形态 | 讯飞输入法、开放平台 API |
Spark-ASR-2.0 的核心能力
Spark-ASR-2.0 的定位是语音识别的底层底座能力,而不是单纯提升字准率的迭代版本。它沿用 Spark-ASR-1.0 的非自回归范式,同时引入 LLM 增强的自回归识别,在保证推理效率的前提下提升语言理解能力,把识别目标从「把声音转成字」推进到「输出可直接使用的文本」。对于需要把语音接入自有系统的团队,这类底座能力的功能边界与 AI 模型 的整体迭代节奏一致,属于基础设施层的更新。
中英文混合与方言免切换识别
在同一段话里中英文混说、专业名词夹杂口语的场景下,模型无需用户手动切换语种即可完成识别,支持中英及202种方言免切换输入。相较需要预先指定语言的识别方案,这一能力减少了移动端输入与口述记录时的操作步骤,对南方口音与方言口述的转写准确率提升更为直接。
复杂声学场景的高鲁棒性识别
针对高噪声、小音量、快语速以及儿童语音等长期困扰语音输入的场景,Spark-ASR-2.0 做了专项优化,官方称在复杂声学场景下的识别效果优于当前业界最优水平。这类场景对应的是地铁、车内、多人会议与户外等真实使用环境,也是语音输入法在移动端最容易失准的地方。
上下文与个性化热词识别
模型在识别过程中动态注入用户的历史识别内容、修改记录与自定义热词,结合上下句语境判断易混淆的同音词与相似名词。对于医学、化学、科技等术语密集的领域,以及包含大量人名、机构名的办公场景,这一层上下文消歧能明显降低后编辑成本。与之配套的是同属星火体系的 星火X2.5 大模型能力,可承接识别之后的语义处理环节。
文本流畅规范化输出
除识别本身,模型还会自动精简冗余表达、去除口头禅、补全标点,并规范数字、符号与单位写法,直接输出结构完整的正式文本。对会议记录、访谈整理与字幕生成等场景而言,这意味着转写结果从「半成品」变为「初稿」,可减少一轮人工整理。
多终端与生态衔接
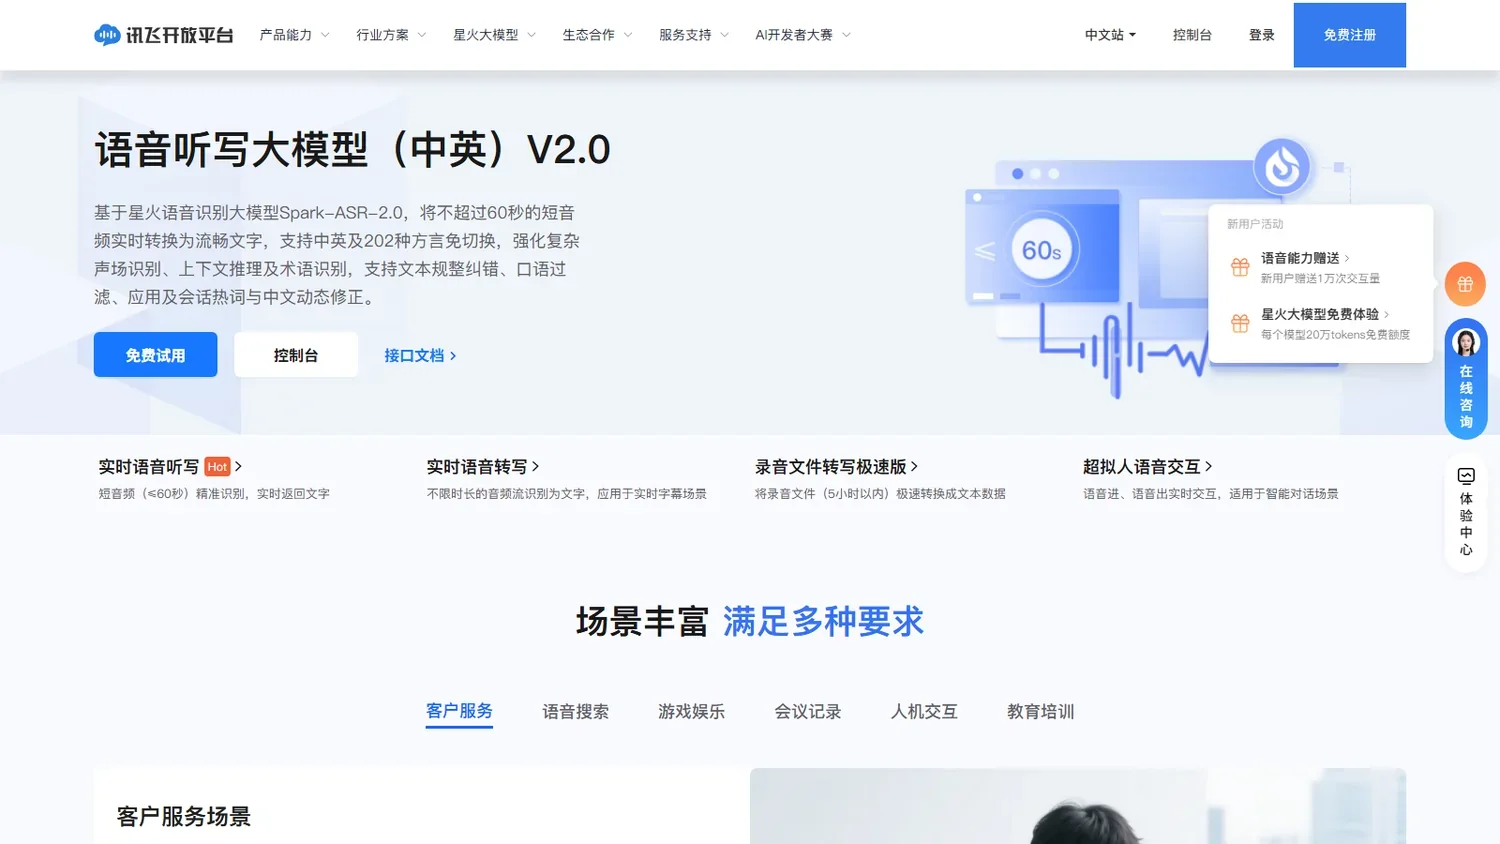
Spark-ASR-2.0 已在讯飞输入法上线,并通过讯飞开放平台提供 API 服务,后续将逐步落地讯飞 AI 眼镜、智能办公本与讯飞听见等终端产品。对终端厂商与软件开发者而言,这意味着同一套识别能力可以在移动端、硬件与云端服务之间复用,降低多端接入的适配成本。官方同时说明,该模型与语音基座 Spark-Audio-1.0-Preview 均基于全国产算力训练。
Spark-ASR-2.0 与同类语音识别模型的对比
下表从开发方、模型定位与关键能力维度,对比几款常见的语音识别方案。
| 对比维度 | Spark-ASR-2.0 | FunASR | OpenAI Whisper |
|---|---|---|---|
| 开发方 | 科大讯飞 | 阿里巴巴 | OpenAI |
| 模型定位 | 语音识别底座模型 | 开源语音识别工具包 | 通用多语言识别模型 |
| 开源情况 | 未开源,经开放平台调用 | 开源 | 开源 |
| 部署形态 | 云端 API + 终端集成 | 本地或私有化部署 | 本地部署 |
| 中英文混合 | 支持,无需切换语种 | 支持中文与英文识别 | 支持多语种识别 |
| 方言覆盖 | 中英及202种方言免切换 | 以中文普通话为主 | 以标准语种为主 |
| 文本规范化 | 自动去口头禅、补标点 | 输出原始转写文本 | 输出原始转写文本 |
| 语种范围 | 以中英文为主 | 以中文为主 | 覆盖多语种 |
上表 Spark-ASR-2.0 一列取自科大讯飞官方发布材料,FunASR 与 OpenAI Whisper 两列取自各自官方文档与开源仓库说明。三者的路线差异集中在交付形态:Spark-ASR-2.0 采用云端接口与终端集成,FunASR 与 Whisper 以开源权重为主、需要自行部署,选择哪一类取决于团队对数据本地化与运维成本的取舍。
如果需要先了解语音转写类工具在会议与协作场景中的成熟形态,可以参考 Otter.ai(面向会议记录的自动转写与摘要工具,与 Spark-ASR-2.0 同属语音转文字方向,差异在于 Otter.ai 提供的是成品应用而非底层模型)。

Spark-ASR-2.0 的应用场景与适用人群
作为语音识别底座能力,它的典型用途包括:
- 语音输入与移动办公:在讯飞输入法中长按说话即可调用,适合通勤、会议与户外等需要快速成文的场景。
- 会议记录与访谈整理:多人会议、访谈与录音素材可自动转写并规范化文本,减少人工整理时间。
- 专业领域口述:医学、化学、科技等术语密集的科室与研发岗位,可借助热词与上下文消歧提升准确率。
- 智能终端语音交互:面向 AI 眼镜、智能办公本、讯飞听见等终端产品,为设备提供实时识别能力。
适用人群:需要把语音转文字接入自有业务的产品与研发团队、重度使用语音输入的移动办公用户,以及医疗、法律、媒体等对术语准确率与文本规范度要求较高的从业者。
Spark-ASR-2.0 的使用方法
目前提供在线体验、输入法与 API 三种接入方式,可按需选择:
- 在线体验:打开科大讯飞 Spark-ASR-2.0 官方体验页,直接说话或上传音频即可查看识别结果。
- 使用输入法:安装最新版讯飞输入法,在输入界面点击麦克风图标,长按说话即可使用该模型识别。
- 准备接入:开发者登录讯飞开放平台,创建应用并获取
AppID与APIKey等鉴权信息。 - 调用接口:按接口文档传入音频流,即可在自有应用中集成识别能力。
接入前建议先明确音频格式与采样率要求,并用真实业务语料做一轮小样本验证,确认术语与专有名词的识别效果后再上量。
Spark-ASR-2.0 的价格与开源情况
Spark-ASR-2.0 通过讯飞开放平台按调用量计费,具体单价以官方开放平台的实时报价为准;官方开放平台页显示,新用户可获赠一定量级的免费服务量额度,个人用户安装最新版讯飞输入法即可免费使用其识别能力,官方体验页也提供在线免费试用。
Spark-ASR-2.0 目前为闭源模型,不提供权重下载,能力通过开放平台接口与讯飞自有终端产品交付。相比开源方案,它的优势在于免去部署与运维,代价是数据需要经过云端处理,对数据合规要求严格的团队应先在开放平台核对数据条款。
Spark-ASR-2.0 的常见问题
Spark-ASR-2.0 和 Spark-ASR-1.0 有什么区别?
两者同属科大讯飞的语音识别模型序列。2.0 基于星火语音基座 Spark-Audio-1.0-Preview 构建,在通用识别、复杂声学场景识别、上下文识别与文本流畅规范性四方面做了专项提升,官方称推理成本相较 1.0 仅增加约 10%。
普通用户在哪里可以用到 Spark-ASR-2.0?
可以安装最新版讯飞输入法,通过语音输入直接使用;也可以访问科大讯飞的在线体验页,说话或上传音频查看识别结果。
Spark-ASR-2.0 开源吗?
目前不开源、不提供权重下载,能力通过讯飞开放平台的 API 与讯飞自有终端产品交付,开发者可按调用量付费接入。
相关文章


 浙公网安备33010202004812号