

MOSS-Image 是模思智能(MOSI)与 OpenMOSS 团队于 2026 年 10 月开源的5B 参数文生图基础模型,主要解决版面可控的图像生成:用一段 JSON 描述每个元素的标注框与文字,模型照此把位置、层级与排版一并画出来。主干为 42 层扩散 Transformer,提示词最长约 4K token,适用于海报排版、信息图、界面稿与多语言文字场景。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 原生布局控制的文生图基础模型 |
| 开发团队 | 模思智能(MOSI)与 OpenMOSS |
| 发布时间 | 2026 年 10 月 16 日 |
| 开源协议 | Apache-2.0,权重与代码均可下载 |
| 模型规模 | 5B 扩散主干,42 层 |
| 文本编码器 | Qwen3.5-9B,训练中冻结 |
| 提示词长度 | 最长约 4K token |
| 布局输入 | JSON,含标注框与坐标格式 |
| 权重版本 | Base 与 SFT 两组 |
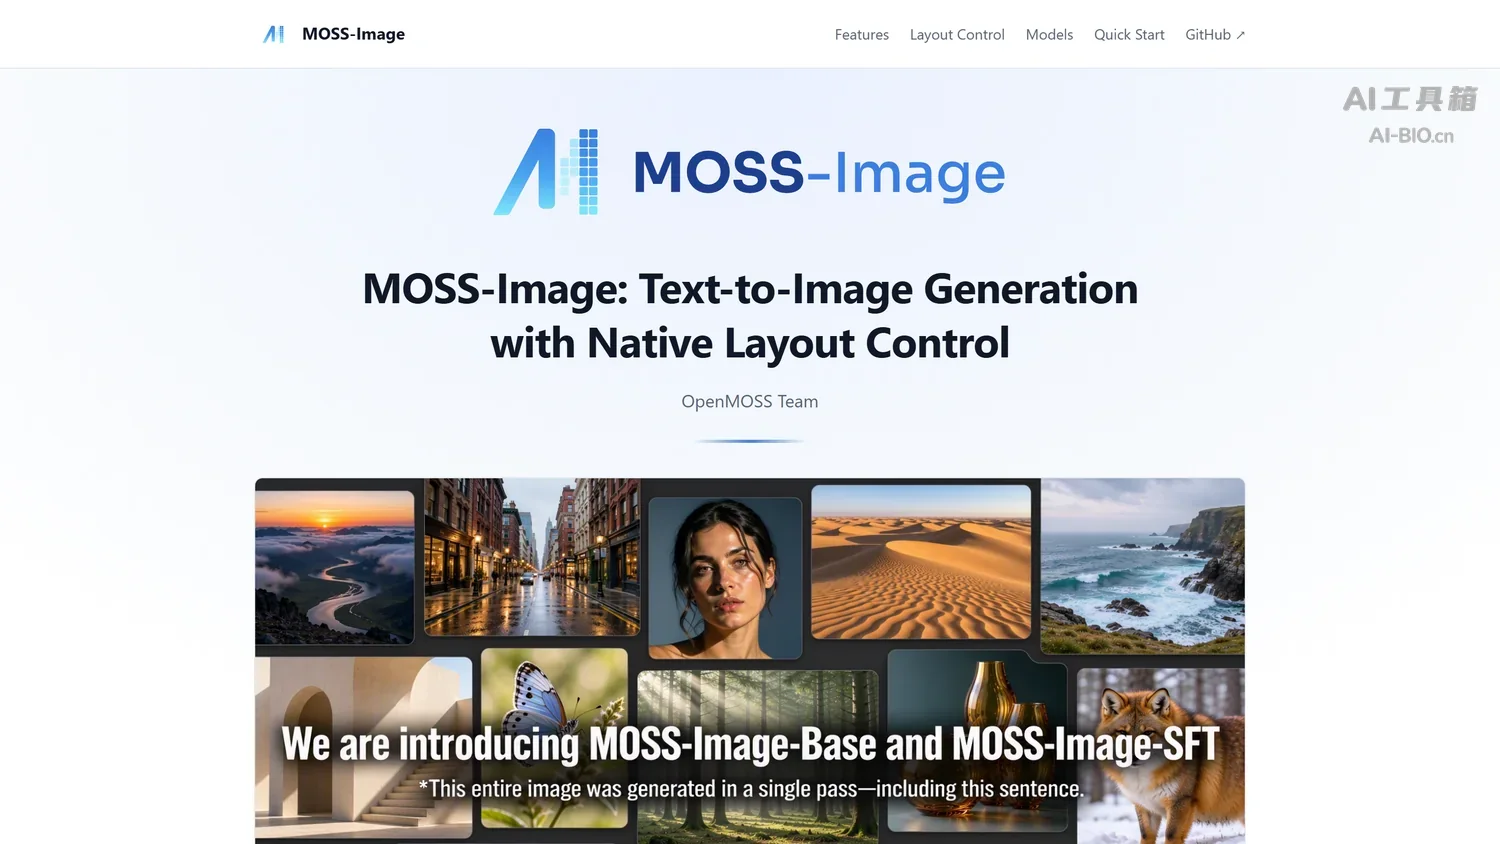
MOSS-Image 的核心能力
差异在一处:版面不是靠形容词猜,而是写在输入里。
用 JSON 描述版面,按标注框落位
布局输入分 summary 与 items 两段:前者交代画布与总述,后者逐个列元素,可给 label、caption、text 与 bbox,坐标空间由 bbox_coord_space 指定,默认 abs_centralized,框格式为 yxyx。把 JSON 粘进 Gradio 提示词框即可,画布尺寸须与生成尺寸一致。提示词上限约 4K token,整版排版也写得下。
在画面里写中英文文字
文字渲染覆盖标题、画面内短句与标注。官方示例用一句中文便签作提示词,生成的图里便签字句完整可读。技术报告为此构造中英双语、短中长三档评测集,长档中文正文实测落在 1,657 至 1,788 字,字形承接能力面向整段正文而非零散词条。它与 Ming-Image-0.1-Design 这类设计向开源模型走两条路:后者面向整版设计,MOSS-Image 把控制权交回布局 JSON。
Base 与 SFT 两组权重
Base 是基础文生图版本,SFT 在其之上用精编数据微调。官方对照示例里,SFT 的文字分组更清晰、白板版式更规整。两组权重各有 Hugging Face 与 ModelScope 两份分发,可分别部署与微调。
接入现有推理栈
除 diffusers 直接调用,ComfyUI 已原生支持,装上 Comfy-Org 格式权重后用内置加载器即可,无需插件;SGLang 与 vLLM-Omni 在发布当天同步支持。官方另附提示词增强脚本,把画面想法转成带整数中心坐标的布局 JSON。
MOSS-Image 与同类图像生成模型的对比
下表取自 MOSS-Image 技术报告的 7Bench 布局控制实验结果:同一批题集、同一套判定脚本,四列都参与该组评测。题集共 224 张图、576 个目标对象。
| 对比维度 | MOSS-Image | Ideogram 4.0 | Seedream 5.0 Pro | GPT Image 2 |
|---|---|---|---|---|
| mIoU ↑ | 0.6788 | 0.2433 | 0.1670 | 0.1431 |
| 检出后 mIoU ↑ | 0.8786 | 0.4449 | 0.3273 | 0.3042 |
| 检出对象数 | 445 | 315 | 294 | 271 |
| 检出率 ↑ | 0.7726 | 0.5469 | 0.5104 | 0.4705 |
| Layout AUC ↑ | 0.7031 | 0.2046 | 0.1794 | 0.1554 |
| IoU 0.9 严格阈值 ↑ | 0.4650 | 0.0015 | 0.0011 | 0.0000 |
上表数据取自技术报告的 7Bench 结果表。mIoU 差异最直接:MOSS-Image 为 0.6788,另外三款落在 0.14 至 0.24。检出率看是否把要求的对象都画出来,MOSS-Image 为 0.7726,Ideogram 4.0 为 0.5469,差距小于精度那一行。严格阈值差别最大:门槛抬到 0.9 后另外三款接近零,MOSS-Image 仍为 0.4650。实验由发布方执行,题集与脚本随报告公开。
「检出对象数」指 576 个目标里被检出的个数,与检出率同源;「检出后 mIoU」只统计被检出的对象,两处口径按报告原样引用。
MOSS-Image 的 VAE 直接取自 FLUX.2-klein-4B。若想看这条路线在消费级显卡上的落地形态,可参考 FLUX 3 Image Klein(Black Forest Labs 开源的图像生成与编辑模型,轻量版面向显存有限的本地环境)。
MOSS-Image 的应用场景与适用人群
版面与文字都能写进输入之后,用法偏向需要精确交付的场合:
- 海报与物料排版:标题、副标题、插画、落款的标注框先定好,再让模型按框出图,不必反复重抽。
- 信息图与知识卡片:多个文字块与图形块各占其位,读写顺序与层级在输入里就已确定。
- 多语言物料:同一版式换语种文本重新生成,中英两套共用一套坐标。
适用人群:适合需要精确控制版面、又不愿上闭源服务的品牌设计与前端团队,以及愿意为一版海报多花几轮调布局的设计岗位;只想一句话出图、不想碰 JSON 的人,用云端成品服务更省事。
MOSS-Image 的使用方法
官方给了三条路径:不装环境可在网页里试,本机部署走 Python 接口,已有 ComfyUI 工作流的可直接加载权重。
网页试用:不装环境,在浏览器里传提示词
- 打开 Hugging Face 上的演示空间(由 OpenMOSS 官方团队搭建),界面为 Gradio,模型选 Base。
- 提示词框里粘画面描述;做布局控制时把布局 JSON 一并粘进去,画布尺寸与生成尺寸保持一致。
- Advanced 里选显存模式:常驻 GPU 最快,组件模式按需搬,顺序卸载最省显存但更慢。
本机部署:用 Python 接口调用权重
- 克隆 MOSS-Image 官方仓库,建虚拟环境后执行
pip install -r requirements.txt。 - 载入权重:
DiffusionPipeline.from_pretrained("OpenMOSS-Team/MOSS-Image-Base", custom_pipeline="pipeline_moss_image", trust_remote_code=True),主干用bfloat16、VAE 用float32。 - 采样保留默认:
num_inference_steps=50、guidance_scale=3.0、uncond_skip_layers=[22];固定manual_seed便于版本间比对。
ComfyUI:把权重接进现有工作流
- 把 ComfyUI 更新到带 MOSS-Image 支持的分支或每夜版,装齐依赖。
- 下载
Comfy-Org/MOSS-Image格式权重放入模型目录,用内置加载器接入,采样走 Flow-matching。
显存不足时先切组件模式,再把分辨率降一档;批量出图固定随机种子,否则批次间差异难判断来自提示词还是随机性。要微调时,DiffSynth-Studio 与 KohakuMossTrainer 都支持全参与 LoRA,后者标注 6GB 显存可起步。
MOSS-Image 的项目地址
- 项目官网:https://openmoss.ai/MOSS-Image/
- GitHub 主仓库:https://github.com/OpenMOSS/MOSS-Image
- Hugging Face 权重库:https://huggingface.co/OpenMOSS-Team/MOSS-Image-Base
- 技术报告:https://arxiv.org/abs/2610.23374
MOSS-Image 的价格与开源情况
MOSS-Image 按 Apache-2.0 协议开源,代码与 Base、SFT 两组权重都可免费下载、自托管与商用,没有许可费用;官方在 Hugging Face 与 ModelScope 各提供一份分发。
真实成本落在算力上:主干 5B、文本编码器 9B,本地推理要按两组权重合计的体量预留显存档位,显存不足时用组件卸载换运行空间,代价是速度。只做适配训练时,社区工具标注 6GB 显存可起步。通过 MOSI API Platform 调用按该平台刊例计费。
MOSS-Image 的常见问题
普通显卡能运行 MOSS-Image 吗?
看显存。官方 Gradio 提供三档显存模式,最省的一档把组件按顺序在 CPU 与 GPU 间搬,代价是速度;只做 LoRA 微调时 6GB 可起步。
布局 JSON 必须自己写吗?
不必。官方附提示词增强脚本,把画面想法转成带整数中心坐标的 JSON;也可在 Gradio 里直接粘贴手写内容。
生成的图能局部修改吗?
改布局 JSON 更可控:调整元素的 caption 或 bbox 后重新生成,位置与内容按新输入重算。
相关文章

 浙公网安备33010202004812号