

SparkAudio 1.0 是一款由科大讯飞于 2026 年 10 月开幕的全球 1024 开发者节上发布的星火语音基座大模型,在语音识别、同传与语音交互之外,新增音频理解、情绪识别、实时说话人分离与环境声理解,适用于会议转写、多语言交互与音频内容分析。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 星火语音基座大模型(正式版) |
| 出品方 | 科大讯飞(iFlytek) |
| 发布时间 | 2026年10月22日(2026全球1024开发者节) |
| 基础能力 | 语音识别、同传、语音交互 |
| 新增能力 | 音频理解、情绪识别、实时说话人分离、环境声理解 |
| 关键提升 | 整体效果提升20%、响应时间降低15%、成本降低60% |
| 技术创新 | 半监督音频编码器、动态分段端到端建模、双范式协同解码 |
| 落地产品 | 讯飞办公本、讯飞输入法16.0、讯飞翻译机、讯飞听见 |
| 首发硬件 | 讯飞AI录音环(说话人实时识别准确率超96%) |
| 转写效率 | 2小时录音约2分钟完成转写 |
| 开源情况 | 截至发稿官方未开放权重下载 |
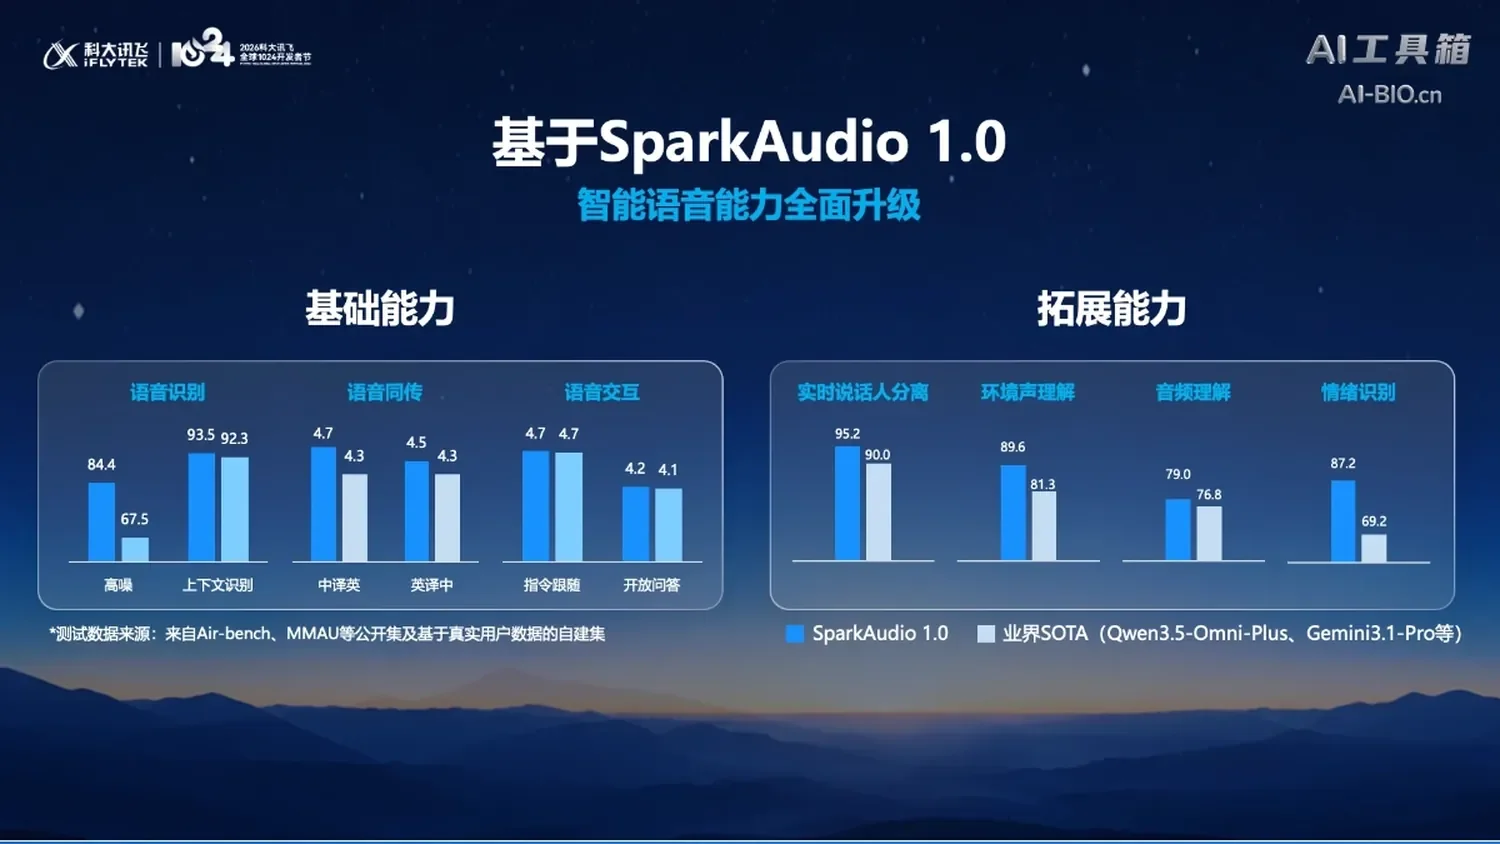
SparkAudio 1.0 的核心能力
从上表看,SparkAudio 1.0 的量化变化有三处:整体效果提升20%,响应时间降低15%,成本降低60%;支撑这三项指标的是半监督音频编码器、动态分段端到端建模与双范式协同解码三项技术创新。能力面也从「听清说了什么」扩展到「听懂发生了什么」。
语音识别与同传升级
作为语音基座的正式版,SparkAudio 1.0 全面提升语音识别、同传和交互能力:识别侧覆盖中英混说与多语种场景,同传侧面向跨语言沟通的实时性要求,交互侧对接讯飞输入法、翻译机等高频使用入口。升级不靠单点调参,官方口径将三项指标的效果归因于基座层面的技术重构,识别、同传与交互共享同一套音频理解底座,而非各自独立的流水线;该底座的识别侧衍生版本,可参考已收录的 Spark-ASR-2.0。
音频理解与声音事件分析
新增的音频理解能力让模型处理的是整段声音而不是逐句转写:发布现场的演示里,模型仅凭一段电影音频,就分析了人物对话、背景音乐和车辆等声音,并据此推断所在场景;对一段录音做主题与场景级标注、按声音事件定位片段,也都不再需要先转成文字再分析。
情绪识别与说话人分离
情绪识别与实时说话人分离面向多人交流场景:模型在转写内容之外,同时输出说话人角色与语气状态,为会议纪要、访谈整理与客服质检提供结构化中间层;环境声理解则把背景音纳入解析范围,使得户外、车载等噪声场景下的指令与内容区分成为可能。
三项技术创新
官方公布的创新集中在三处:半监督音频编码器负责在标注数据之外利用大规模无标注音频;动态分段端到端建模处理长音频的切分与衔接;双范式协同解码兼顾识别准确率与响应速度。三项技术叠加的量化结果为整体效果提升20%、响应时间降低15%、成本降低60%,成本项对要在端侧设备上常驻语音能力的厂商尤为关键。
全系上线与AI录音环
落地节奏上,SparkAudio 1.0 已在讯飞办公本、讯飞输入法16.0、讯飞翻译机、讯飞听见等产品全系上线,用户更新对应版本即可使用,没有单独的开关或安装步骤;同场首发的讯飞AI录音环是配套硬件,支持说话人实时识别,综合识别准确率超96%,2小时录音转写仅需2分钟,把基座能力做成了可随身携带的形态。
SparkAudio 1.0 与同类语音模型的对比
SparkAudio 1.0 的参照系是自家预览版与开源阵营的通用音频模型。三者路线不同,可直接对照的能力面如下:
| 对比维度 | SparkAudio 1.0 | Spark-Audio-1.0-Preview | FireRedAudio |
|---|---|---|---|
| 型号定位 | 星火语音基座(正式版) | 全国产语音基座大模型(预览版) | 通用音频语言模型 |
| 出品方 | 科大讯飞(iFlytek) | 科大讯飞(iFlytek) | 小红书 FireRed 团队 |
| 发布时间 | 2026年10月22日 | 2026年9月16日 | 2026年8月21日 |
| 能力范围 | 识别、同传、交互+音频理解、情绪识别、说话人分离 | 语音语义、情绪与场景直接理解 | ASR、音频问答、长音频理解、语音克隆、语音编辑 |
| 关键成绩 | 效果+20%、响应-15%、成本-60% | Fleurs 中文测试集 SOTA | MMAU 三项 82.0/80.9/83.3 第一 |
| 开源情况 | 截至发稿未开放权重 | 暂未开源 | Apache-2.0 已开源 |
| 交付方式 | 讯飞办公本、输入法16.0、翻译机、听见全系上线 | 官方体验中心试用;底座用于 Spark-ASR-2.0 | GitHub 与 Hugging Face 开放下载 |
三家的取舍集中在三处:开源情况上,FireRedAudio 以 Apache-2.0 开放权重,讯飞两代均未开放;能力范围上,SparkAudio 1.0 在识别与同传之外并入音频理解与说话人分离;交付方式上,讯飞走产品内集成、开箱即用,FireRedAudio 面向自行部署与二次开发。
语音底座的前一代预览版已在站内收录:Spark-Audio-1.0-Preview 采用 0.65B 音频编码器加 30B-A3B MoE 架构,支持 99 种语言与 202 种方言,并在 Fleurs 中文测试集取得 SOTA,可作为理解 1.0 正式版能力边界的参照,其站内页面见下方卡片。
SparkAudio 1.0 的应用场景与适用人群
围绕「听清」到「听懂」的能力扩展,SparkAudio 1.0 的常见场景包括:
- 会议与访谈转写:录音环或讯飞听见承担多人对话的转写与说话人区分,2小时录音约2分钟出稿。
- 跨语言沟通:同传能力经讯飞翻译机与输入法落地,覆盖中英混说与多语种实时翻译。
- 音频内容分析:对播客、访谈、现场录音做场景推断、情绪标注与声音事件定位。
- 端侧产品集成:办公本与输入法把语音能力常驻本地,减少云端调用带来的延迟与成本。
适用人群:讯飞办公本、输入法与翻译机的既有用户,需要会议纪要与访谈整理的团队,做多语言内容或音频后期处理的创作者;希望自行部署和微调语音模型的开发者可参考 FireRedAudio 等开源方案,再对照本模型的量化指标做选型。
SparkAudio 1.0 的使用方法
SparkAudio 1.0 未单独开放权重或独立 API 页,能力经讯飞系产品与硬件落地,按载体分两条路径:
讯飞系产品路径
- 确认载体:本次更新覆盖四款官方载体——讯飞办公本、讯飞输入法16.0、讯飞翻译机与讯飞听见。
- 更新版本:将产品升级至已集成 SparkAudio 1.0 的版本,升级入口见各产品内提示。
- 直接使用:在语音输入、转写或翻译功能中调用,能力随产品启用,无单独开关。
讯飞AI录音环路径
- 连接设备:佩戴或配对讯飞AI录音环,确认与配套应用完成连接。
- 实时识别:录音过程中模型实时完成说话人识别,综合识别准确率超96%。
- 生成转写:录音结束后在配套应用生成转写文本,2小时录音约2分钟完成。
两条路径共用同一语音基座;开发者如需把语音能力接入自有系统,可在讯飞开放平台的语音服务页面查看在售接口与文档。
SparkAudio 1.0 的项目地址
- 官方发布文章(微信公众号):https://mp.weixin.qq.com/s/Wk1Rbuxn7SiINrzuXaUfZg
- 讯飞开放平台:https://www.xfyun.cn/
- 讯飞星火官网:https://xinghuo.xfyun.cn/
SparkAudio 1.0 的价格与开源情况
官方发布信息未包含 SparkAudio 1.0 的独立定价;模型能力随讯飞办公本、讯飞输入法16.0、讯飞翻译机、讯飞听见等既有产品提供,费用按各产品自身的方案执行,本页不作推测。
首发的讯飞AI录音环为独立硬件,售价与上市节奏以官方渠道为准;开发者侧如需接口级能力,可在讯飞开放平台的语音服务页面核对计费方式后再接入。
SparkAudio 1.0 的常见问题
SparkAudio 1.0 开源了吗?
截至发稿未开放权重下载;上一代预览版同样未开源,官方以产品内集成方式提供能力,开放计划以官方公告为准。
SparkAudio 1.0 和 Spark-Audio-1.0-Preview 是什么关系?
Preview 是 2026 年 9 月发布的预览版,主打直接语音理解与 99 种语言覆盖;1.0 正式版在识别、同传与交互之外新增音频理解、情绪识别与说话人分离,效果提升20%、响应降低15%、成本降低60%。
普通用户怎么用上 SparkAudio 1.0?
无需单独安装:讯飞办公本、讯飞输入法16.0、讯飞翻译机、讯飞听见更新后内置该模型;需要独立硬件时可选择讯飞AI录音环。
相关文章

 浙公网安备33010202004812号