
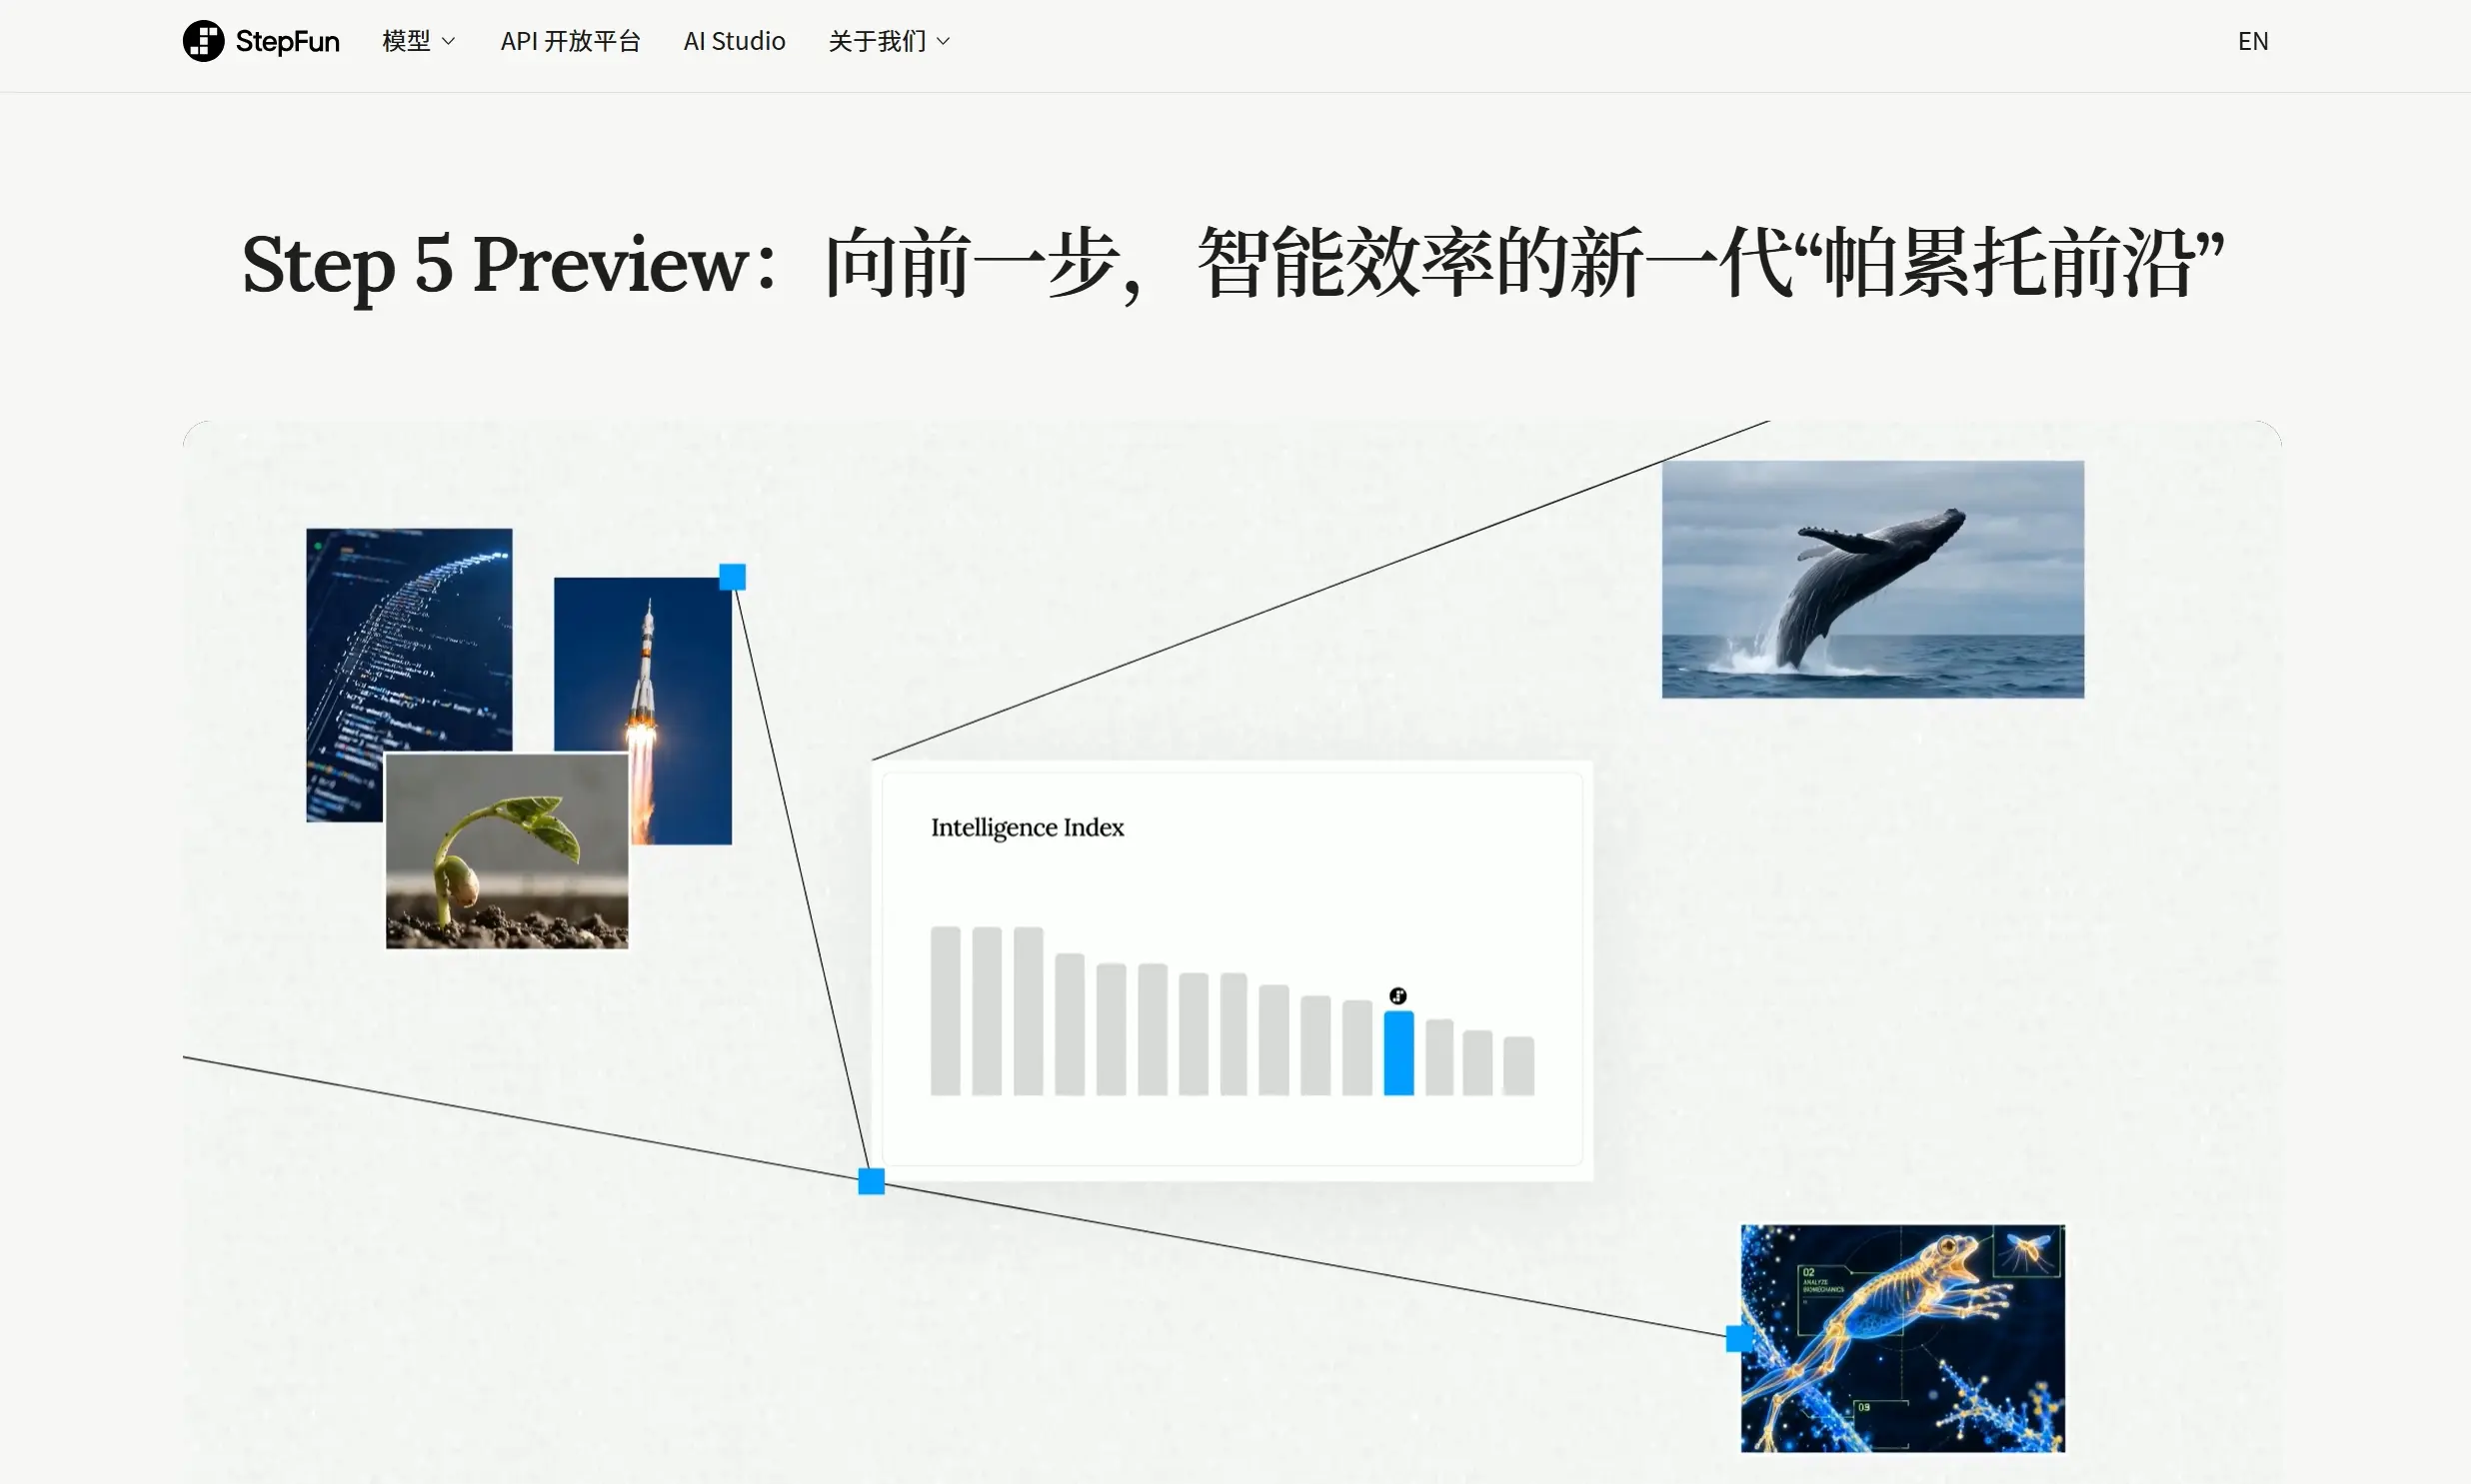
Step 5 Preview是一款由阶跃星辰(StepFun)于2026年9月推出的旗舰基座模型,主要面向需要长任务链持续执行的 Agentic 任务,采用稀疏 MoE 架构(总参 600B/激活 27B),支持 100 万 Token 上下文与原生文本、视觉输入,适用于 AI 编程、专业知识工作与金融研究等场景。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 面向 Agentic 任务的旗舰基座模型 |
| 出品方 | 阶跃星辰(StepFun) |
| 发布时间 | 2026年9月20日 |
| 模型架构 | 稀疏 MoE(600B 总参/27B 激活) |
| 上下文窗口 | 100 万 Token |
| 输入模态 | 原生文本与视觉输入 |
| 智能指数 | 44 分(Artificial Analysis) |
| 单任务成本 | Claude Opus 5 的 1/8 |
| 编程评测 | 覆盖 553 个代码仓库、9 类任务、33 种语言 |
| 开源计划 | 2026年10月15日释放完整权重 |
| 接入方式 | 阶跃开放平台 API 与 Studio 在线体验 |
Step 5 Preview 的核心能力
这一代的着力点不是把单项能力推到最高,而是在能力、成本与效率之间把边界再往外推一档。这类取舍也是 大语言模型 从回答走向执行后,选型标准变化的直接反映。
稀疏 MoE 架构与 100 万 Token 上下文
模型采用稀疏 MoE 架构,总参数 600B、激活参数 27B,推理时只为激活部分付出算力。配合 100 万 Token 的上下文窗口,长任务链里的历史记录可以完整保留,多轮工具调用时不必反复裁剪上下文,也能持续追踪此前的执行结果与运行反馈。
长周期任务的自主迭代能力
官方用两个可量化实验验证持续执行:一是在单张 NVIDIA H100 上给它 24 小时,从零优化一个头维度 512 的 MLA 内核,它在约 22 小时把峰值性能做到 508 TFLOPS;遇到让吞吐下降的候选方案会主动放弃,退回此前最优版本继续。二是给它 24 小时通过自动化后训练提升 Qwen3-30B-A3B 在 AIME24 上的表现,准确率由 53.3% 提升至 60%,消耗的标注 token 比对照方案更少。
AI 编程与软件工程的任务覆盖
面向编程场景,官方构建了 StepCodeBench,覆盖 553 个独立代码仓库、9 类任务、20 个应用领域与 33 种编程语言,考察的是整体任务成功率与跨场景稳定性,而非单题通过率。官方展示的任务里,模型自主阅读开发文档后把一块 ESP32-S3 开发板改成支持蓝牙按键与语音输入的键盘,过程中访问串口、调用摄像头、模拟鼠标操作,并按真实设备返回的报错持续修改调试。
金融研究场景的三类评测
金融被作为重点验证场景,围绕公司研究构建了三项内部评测:信息检索与验证、企业估值建模、完整深度研究流程;外部还使用 FrontierFinance,以 220 道专家设计的问题与 11,543 项评估标准覆盖六类投资应用场景。四项评测中模型均取得较强结果,侧重的是数据口径不一致时借助工具完成严谨分析的能力。
前端设计与 3D 创意内容生成
除代码外,模型可完成网页界面与数据可视化,也能调用 Blender 创建并反复调整 3D 资产,再把资产接入 Three.js 的交互式 Web 应用与游戏。官方示例还从一本 1922 年的铁路旅行指南中提取信息,构建行程查询与路线回放功能。
Step 5 Preview 与同类基础模型的对比
基座模型的取舍集中在能力、成本与效率三点。以下对比数值与口径均取自阶跃星辰官方发布材料,逐格列出。
| 对比维度 | Step 5 Preview | Claude Opus 5 |
|---|---|---|
| 研发方 | 阶跃星辰(StepFun) | Anthropic |
| 模型架构 | 稀疏 MoE(总参 600B/激活 27B) | 未在对比项内 |
| 智能指数 | 智力指数 44 分(开源前三) | 未在对比项内 |
| 单任务成本 | 基准成本 | Step 5 Preview 的 8 倍 |
| 上下文窗口 | 100 万 Token | 200K Token |
| 输入模态 | 原生文本+视觉 | 文本+视觉 |
| GPU 内核优化 | 508 TFLOPS | 493 TFLOPS |
| AIME24 后训练 | 53.3% → 60% | 53.3% → 60% |
| 开源情况 | 2026年10月15日释放完整权重 | 闭源,仅 API 提供 |
九项放在一起看,差别不在单点峰值,而在同一成本下的可用性:单任务成本只有 Claude Opus 5 的 1/8,100 万 Token 的上下文窗口是 200K 的五倍。两项长周期实验更能说明问题——24 小时自主优化 MLA 内核做到 508 TFLOPS,超过 493 TFLOPS;自动化后训练把 Qwen3-30B-A3B 在 AIME24 上从 53.3% 提到 60%,与对照方案持平但消耗的标注 token 更少。表中「未在对比项内」指该模型未参与官方该项对比,未作推测填充。
如果想对照另一条开放权重路线,可参考 Kimi K3(月之暗面推出的旗舰大模型,采用 2.8 万亿参数 MoE 架构,同样支持 100 万 Token 上下文与原生视觉理解)。两者的差别在重心:它更偏通用知识与深度研究,本代把重点放在长周期 Agent 任务的持续执行上。
Step 5 Preview 的应用场景与适用人群
模型的强项在多轮、长时段、需要自己判断下一步做什么的任务,纯问答反而不是它的主场:
- AI 编程与软件开发:覆盖 Bug 修复、功能开发、代码重构与环境配置,支持 33 种编程语言,可作为团队日常主力编码模型。
- 长周期科研与工程优化:适合放进 24 小时级别的自主迭代任务,例如内核性能调优与自动化后训练数据流程。
- 金融分析与投资研究:覆盖金融信息检索验证、企业估值建模与深度研究报告撰写,服务投研与金融专业人士。
适用人群:需要把模型接入长任务链的工程与产品团队;做技术选型、要看真实任务链成本与成功率的算法负责人;以及金融投研、硬件研发等需要模型自主跑完多步流程的专业用户。
Step 5 Preview 的使用方法
模型提供在线体验与 API 两条路径,权重在 10 月 15 日之后才开放下载:
- 读官方材料:从 Step 5 Preview 官方发布页 查看完整评测口径与示例任务,确认长周期任务的样本设计。
- 在线体验:在 Studio 平台(studio.stepfun.com)选定 Step 5 Preview,先用一个多步任务观察任务规划与工具调用的稳定性。
- 接入接口:中国大陆节点走 platform.stepfun.com,国际节点走 platform.stepfun.ai,创建 API Key 后按兼容格式发起调用。
- 适配长任务:把中间结果与运行反馈写回上下文,按任务阶段分段清理历史,避免 100 万 Token 窗口被无谓记录占满。
Step 5 Preview 的价格与开源情况
Step 5 Preview 全量开放后通过阶跃开放平台按量计费,官方未给出统一价目表,成本口径来自官方材料给出的相对值:完成同一任务的开销约为 Claude Opus 5 的 1/8。对长周期 Agent 任务而言这个差距会被多轮工具调用放大——单步价格接近时,轮次越多总账差距越大,建议用真实任务链跑通后再比较成本。
权重层面,Step 5 Preview 按开源模型交付,完整权重定于 2026 年 10 月 15 日释放,在此之前只提供 API 与在线体验。这条路径延续了阶跃从 Step 3.5 Flash、Step 3.7 Flash 以来的效率取向:先用 API 验证任务效果,权重开放后再决定是否自建推理集群。
Step 5 Preview 的常见问题
Step 5 Preview 的参数规模是多少?
采用稀疏 MoE 架构,总参数 600B、激活参数 27B,推理时只计算激活部分,以较低的推理成本支撑旗舰级能力。
Step 5 Preview 什么时候开源?
完整权重定于 2026 年 10 月 15 日释放。在此之前可通过阶跃开放平台 API 与 Studio 在线体验使用,需要本地部署的团队可先用 API 完成选型验证。
Step 5 Preview 的上下文窗口有多大?
支持 100 万 Token 上下文,并原生支持文本与视觉输入,适合长任务链中持续保留历史记录与运行反馈。
Step 5 Preview 与 Claude Opus 5 相比如何?
Artificial Analysis 智能指数 44 分、位居全球开源模型前三,单任务成本约为 Claude Opus 5 的 1/8,上下文窗口是对方的五倍。长周期实验里,H100 上优化 MLA 内核达 508 TFLOPS,高于对方的 493 TFLOPS;自动化后训练把 Qwen3-30B-A3B 在 AIME24 上从 53.3% 提到 60%,与对方持平但标注 token 消耗更少。
相关文章

 浙公网安备33010202004812号