
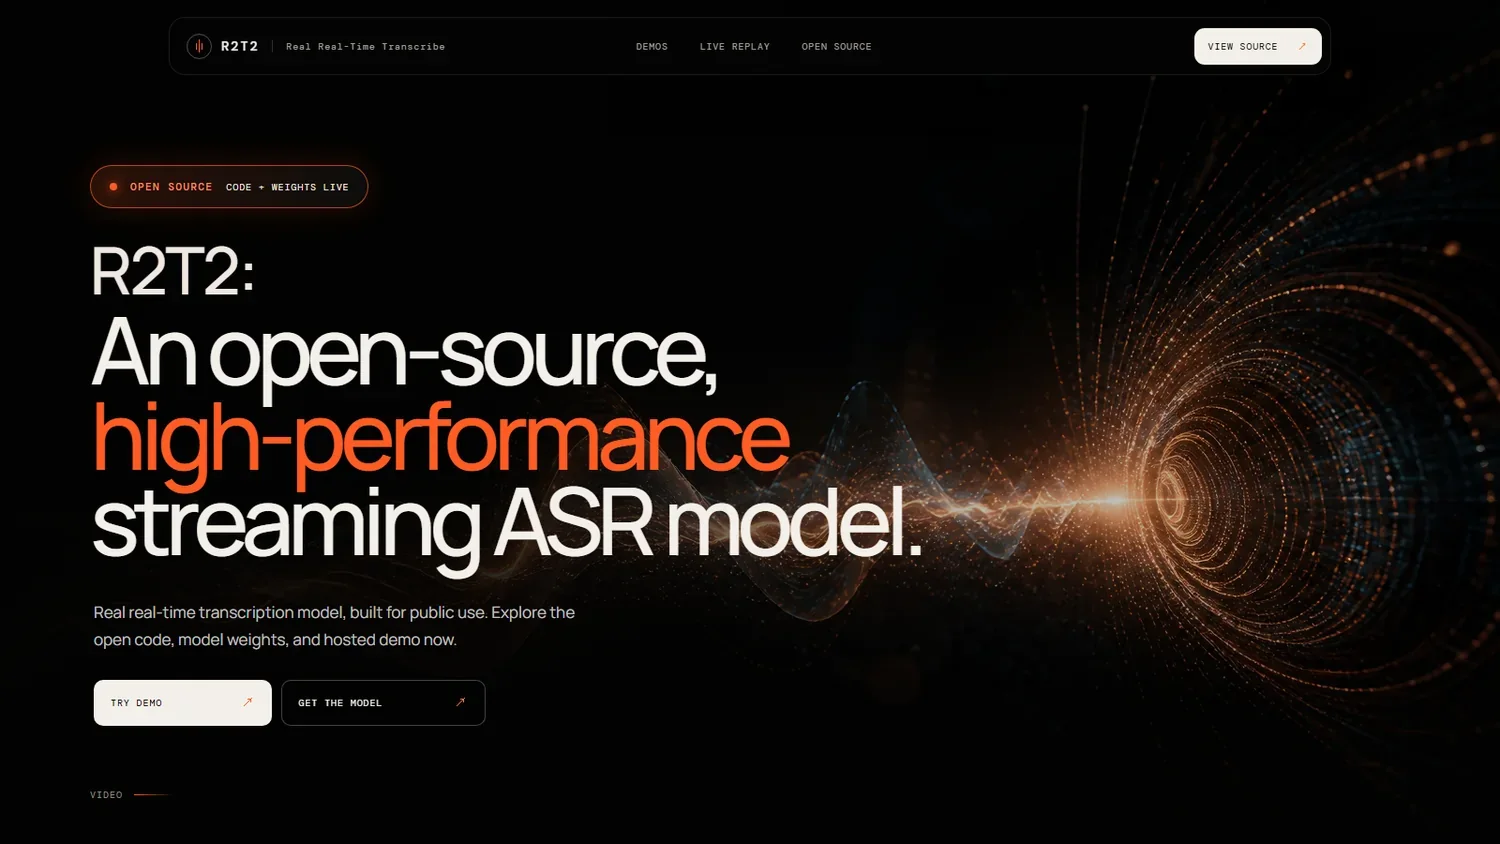
R2T2是一款由网易有道于2026年9月开源的低延迟真流式语音识别模型,全称 Real Real-Time Transcription,主要用于边说边出字的实时转写,支持 80ms 至 2s 可调分块与热词上下文,适用于实时字幕、语音 Agent 与同传前端等方向。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 真流式语音识别模型 |
| 出品方 | 网易有道 |
| 发布时间 | 2026年9月21日开源 |
| 模型底座 | 基于 Qwen3-ASR 构建 |
| 解码机制 | append-only 前缀提交 |
| 延迟范围 | 官方口径约 200–600ms |
| 分块粒度 | 80ms–2s 可调 |
| 部署后端 | vLLM、Transformers 等 |
| 开源许可 | 代码 Apache-2.0 |
R2T2 的核心能力
在实时语音场景中,识别结果是否稳定,直接决定后续动作会不会被打断。以语音 Agent 为例,文本一旦上屏就可能触发执行,若已输出内容被后续音频回改,动作会随之反复,因此「已提交文本不再回改」比单纯的准确率更关键。要理解这条链路,可以先了解 AI 智能体 的执行方式。
真流式与 append-only 机制
R2T2 按 80ms 至 2s 的可调分块持续接收音频、持续输出文字,不等整段语音结束。它采用 append-only 的提交方式,模型先判断当前前缀是否足够稳定,稳定即提交为不可修改文本,不稳定则继续缓存上下文,因此已上屏的句子不会被后续音频翻盘。
延迟与精度可调
官方口径给出的平均延迟约为 200 至 600ms,具体取决于分块大小与尾部回退窗口的设置。小块切分响应更快但容错更低,大块切分更稳但等待更久,用户可按场景在更快与更稳之间切换,一套模型同时兼顾流式与离线两类任务。
热词与上下文先验
支持通过提示词、领域词与专有名词预先约束识别结果,提高人名、产品名与行业术语的命中率。对财务、医疗、法务等术语密集的转写场景,这一层先验可以明显减少同音误写。
多后端与流式服务
官方提供 vLLM、Transformers 与 llama.cpp 等多套推理后端,并附带可启动的 WebSocket 服务,客户端以 16kHz 单声道音频推送即可获得增量文本。这种交付形式便于接入已有的字幕、坐席辅助或语音交互系统。
多语言覆盖
在中文与英文上做了重点优化,同时保留法、德、意、日、韩、俄、西、阿等语种的跨语言识别能力,多语种混说场景下不需要切换模型。
R2T2 与同类语音识别方案的对比
下表从交付形态、解码机制与部署方式等维度,对比两款常被放在一起评估的语音识别方案。
| 对比维度 | R2T2 | GPT-Realtime-Whisper | FunASR |
|---|---|---|---|
| 产品定位 | 可私有化部署的流式识别模型 | 托管式流式转写接口 | 开源语音识别工具链 |
| 交付形态 | 代码与权重公开,自行部署 | 云端接口调用,不提供权重 | 代码与模型公开,自行部署 |
| 解码机制 | append-only,已提交文本不回改 | 边说边出字,以低延迟输出为主 | 流式与非流式两套推理路径 |
| 延迟口径 | 官方口径平均约 200–600ms | 第三方实测首包中位数约 556ms | 随部署环境与模型档位变化 |
| 输出稳定性 | 已上屏文本固定,避免字幕回跳 | 以流式增量输出为主 | 流式结果后续可能被修正 |
| 开源与许可 | 代码 Apache-2.0,权重另有协议 | 闭源接口,仅可调整会话参数 | 开源项目,可自建与二次训练 |
| 部署方式 | vLLM、Transformers、llama.cpp | 通过接口接入,无需自建算力 | 本地或服务端自建 |
| 语言覆盖 | 中英优化,兼容多语种 | 以接口支持的语种为准 | 以中文为主,另有多语种模型 |
上表 R2T2 一列取自网易有道官方模型说明与项目仓库,GPT-Realtime-Whisper 一列取自其官方接口文档及第三方实测口径,FunASR 一列取自其官方项目说明;其中延迟一行的测量口径并不完全一致,仅作量级参考。三者的差异集中在交付形态:需要把音频留在自有环境、或要把识别结果嵌入自有系统时,可自行部署的权重方案可控点更多;只追求快速接入时,托管接口的工程成本更低。
如果关心实时语音链路的另一端,可以参考 Gemini 3.8 Live(谷歌推出的实时语音对话模型,以语音为直接输入输出,与 R2T2 这类把语音转成稳定文本的识别模型处在同一条实时语音链路上)。
R2T2 的应用场景与适用人群
真流式识别与不可撤回的输出,适合对实时性与稳定性同时有要求的场景,常见用途包括:
- 实时会议字幕:边发言边输出定稿字幕,减少字幕反复修正带来的阅读干扰。
- 语音 Agent 指令入口:在口令类交互中输出不可撤回的指令文本,降低误触发造成的动作反复。
- 呼叫中心实时辅助:把转写结果实时推送给坐席,并结合热词提升专有名词与业务术语的命中率。
- 课堂与无障碍听写:为听障用户或速记场景提供稳定的逐字流,减少事后修订成本。
适用人群:需要搭建实时字幕、语音 Agent、坐席辅助或同传前端的开发团队,以及希望在本地或内网完成识别链路、对音频外发有约束的企业。由于权重需要自行托管,采用前应评估推理算力与运维投入。
R2T2 的使用方法
R2T2 以代码仓库形式发布,从获取代码到启动流式服务可按以下步骤操作:
- 获取代码:访问 R2T2 项目官网 找到入口,仓库路径为
netease-youdao/Confucius4-R2T2。 - 准备环境:用 Conda 或 uv 创建 Python 3.12 环境,执行
pip install -e .安装依赖。 - 下载权重:按所选后端从 Hugging Face 或 ModelScope 拉取
Confucius4-R2T2或Confucius4-R2T2-GGUF。 - 运行示例:执行
./run_example.sh并指定--infer_mode stream_vllm与--chunk_size_ms 160验证流式输出。 - 写入调用代码:加载
R2T2ASRModel.LLM后调用init_streaming_state(),按 16kHz 分块循环调用streaming_transcribe(),结束时调用finish_streaming_transcribe()。 - 启动实时服务:执行
./run_start_server.sh start,通过--port 8272指定监听端口并按需指定 GPU。 - 对接客户端:向
ws://localhost:8272/asr_stream_api_v1推送 16kHz 单声道 PCM 音频,结束时发送结束标记。
建议先用短音频验证流式输出的稳定性,再按业务调整分块粒度、热词表与回退窗口;进入生产环境后应同时观察首包延迟与显存占用。
R2T2 的价格与开源情况
R2T2 以开源方式发布,代码采用 Apache-2.0 协议,模型权重另有许可条款,不按调用量计费,成本主要来自自行部署所需的推理算力;对已有 GPU 资源的团队,边际成本基本只有电费与运维。
权重可自行托管意味着音频不必离开自有环境,适合有数据合规要求的企业;商用范围与再分发条件以官方仓库中的协议文件为准,二次开发前建议先核对条款。
R2T2 的常见问题
R2T2 与常规流式识别有什么不同?
常规流式识别会在后续音频到达后修正此前输出的文字,R2T2 采用 append-only 机制,已提交文本不再回改,更适合字幕与语音 Agent 这类对输出稳定性敏感的场景。
R2T2 支持哪些语言?
官方说明以中文与英文为优化重点,同时保留法、德、意、日、韩、俄、西、阿等语种的跨语言识别能力。
R2T2 可以商用吗?
代码采用 Apache-2.0 协议,模型权重另有许可条款,商用范围与再分发条件以官方仓库中的协议文件为准。
相关文章

 浙公网安备33010202004812号