
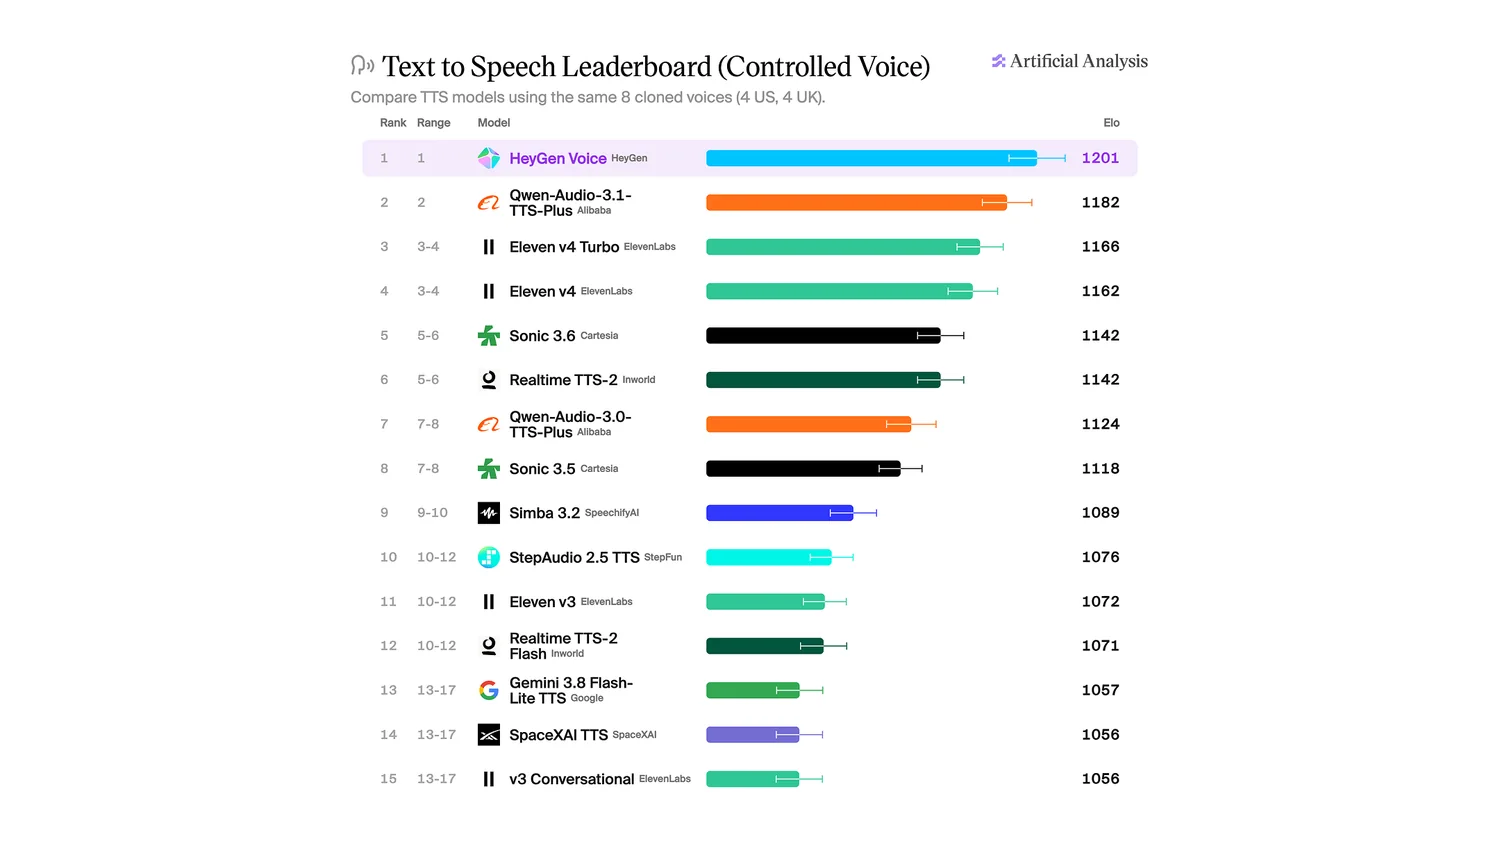
HeyGen Voice是一款由HeyGen于 2026 年 10 月推出的自研语音合成模型,官方称其上线时即在 Artificial Analysis 的 Controlled Voice 语音榜排名第一。该模型支持文本转语音与声音克隆两类能力,在保留说话人语气、情感与节奏的前提下生成音频,并在 HeyGen 平台与官方接口内开放使用,适用于数字人配音、口播视频与多语言本地化等场景。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 自研语音合成模型 |
| 出品方 | HeyGen |
| 发布时间 | 2026年10月9日 |
| 核心能力 | 文本转语音、声音克隆 |
| 榜单成绩 | Artificial Analysis 语音榜第一 |
| 语言覆盖 | 多语种,含中文 |
| 接入方式 | HeyGen 平台与官方 API |
| 开放情况 | 未提供模型权重下载 |
HeyGen Voice 的核心能力
HeyGen Voice 是 HeyGen 自研的语音生成模型,与平台此前的语音方案相比,它把优化重心放在「像本人」这件事上:合成的音频保留说话人原有的语气、情感起伏与停顿节奏。对 AIGC 内容生产而言,这意味着配音环节可以不另请配音员就得到接近本人音色的成品,数字人视频的画面与声音也能在同一套素材里保持一致。
在第三方语音榜上排名第一
模型发布时,Artificial Analysis 的 Controlled Voice 榜单把 HeyGen Voice 列为第 1 名,Elo 评分 1201,参与对照的样本数为 1531 次,95% 置信区间为正负 16。该榜的口径是让不同模型朗读同一组克隆音色与文本,再由盲测投票得出排序,衡量的是语音自然度与说话人相似度。
语气、情感与节奏的还原
官方把这项能力描述为「真实表达」:模型会跟随文本内容调整语调与情绪,在陈述、提问与感叹之间保持自然的起伏,长句与短句的停顿按语义切分。对于需要连续口播的内容,跨句、跨段落的声音一致性比单个句子的音质更关键,这一版把优化重点放在该处。
与 Avatar V 属于同一条技术栈
HeyGen 官方说明,Avatar V 是平台的核心模型,HeyGen Voice 则是同一套端到端技术栈里新增的音频格式。这意味着数字人视频中的画面与声音来自同一体系,人物形象与音色可以在同一次生成里对齐,省去把视频与音频分开制作再拼接的环节。
文本转语音与声音克隆两类能力
模型提供两条使用路径。文本转语音直接接收文本并输出音频;声音克隆则先用说话人本人的录音建立专属音色,再用该音色朗读新文本。官方为克隆设定了授权要求,需要本人明确同意后才能用于语音合成。两类能力通过同一套官方接口调用,非流式接口返回音频文件,流式接口以事件流逐段返回。
HeyGen Voice 与同类语音合成模型的对比
| 对比维度 | HeyGen Voice | Qwen-Audio-3.1-TTS-Plus | Eleven v4 Turbo | MAI-Voice-2 |
|---|---|---|---|---|
| 出品方 | HeyGen | 阿里巴巴(阿里通义) | ElevenLabs | 微软(Microsoft AI) |
| 产品定位 | 数字人平台的自研语音合成模型 | 语音大模型系列中的语音合成成员 | 商业语音合成与语音克隆模型 | 多语言文本转语音与语音克隆模型 |
| 发布时间 | 2026 年 10 月 9 日 | 2026 年 9 月 24 日 | 2026 年 9 月 28 日 | 2026 年 6 月 |
| 语言覆盖 | 多语种,官方基础语言列表含中文 | 系列覆盖 30 种语言与 16 种中文方言 | 多语种 | 多语言 |
| 声音克隆 | 支持即时克隆与专属音色克隆 | 未公开 | 支持 | 支持零样本语音克隆 |
| 开放权重 | 否 | 否 | 否 | 否 |
| 每百万字符价格 | 30 美元 | 19.31 美元 | 40 美元 | 未公开 |
上表 HeyGen Voice 一列取自 HeyGen 官方发布材料与官方接口文档,Qwen-Audio-3.1-TTS-Plus 一列取自阿里通义官方说明与公开榜单标注,Eleven v4 Turbo 一列取自 ElevenLabs 官方产品信息与公开榜单标注,MAI-Voice-2 一列取自微软官方说明。四款模型的差异集中在三处:声音克隆上,HeyGen Voice 与 MAI-Voice-2 都把专属音色作为主线能力;语言覆盖上,Qwen-Audio-3.1-TTS-Plus 在中文与方言上给出了更细的清单;接入方式上,四款都只提供云端接口,权重均未开放,本地部署需要另找开源方案。
如果更看重开箱即用,而不打算自行接入接口,也可以直接使用 HeyGen 平台本身:它提供数字人视频与语音生成的一体化服务。

HeyGen Voice 的应用场景与适用人群
该模型面向需要自然人声的视频与音频任务,常见场景包括:
- 数字人视频配音:与 Avatar V 驱动的画面对应,人物形象与音色来自同一套素材,适合批量生产口播与讲解视频。
- 多语言本地化:同一段脚本可以按目标语言重新生成音频,用于把国内内容推向海外市场。
- 有声内容制作:课程、播客与有声读物的初稿先用模型合成,再按听感决定是否重录。
- 企业培训与内部播报:以固定音色统一讲解内容的听感,减少多人录制的协调成本。
- 产品演示与广告口播:用较低成本试听多版文案的语气与节奏,再确定最终脚本。
适用人群:以数字人视频为主要载体的内容团队、需要多语言配音的出海业务方,以及希望用统一音色批量生产音频的企业内容部门。只做单次文本朗读的用户,平台内的基础语音功能已经够用。
HeyGen Voice 的使用方法
该模型在 HeyGen 平台与官方接口中提供,按以下顺序接入:
- 确认能力范围:在 HeyGen 官方语音合成接口文档 查看支持的参数与输出格式。
- 准备音色:直接使用平台内置音色,或先用本人的录音建立克隆音色;即时克隆取一段录音的前 3 分钟,数秒即可完成建立。
- 发起文本转语音请求:调用
POST /v3/models/audio/tts直接返回一段 44.1 千赫兹的 WAV 音频,或调用POST /v3/models/audio/tts/stream以事件流逐段接收;模型标识固定填写heygen-voice-1,单次文本长度在 1 到 5000 字符之间。 - 调整表达参数:用
expressiveness_boost控制表现力强度,专属音色还可以额外设定speed、pitch_shift与pitch_variance。 - 按上限排队批量任务:每个工作区成员每分钟最多 30 次请求,批量生成需要按该上限安排节奏。
接入初期建议先用一小段文本验证音色与停顿是否符合预期,再扩展到完整脚本。即时克隆的录音只需 3 分钟即可建立,但建立之后不能再重训,需要调整时只能重新建立;专属音色克隆则需要本人 1 至 10 段、合计不少于 20 分钟的录音,之后可以反复重训。
HeyGen Voice 的价格与开源情况
HeyGen 官方说明,HeyGen Voice 在平台与官方接口内免费开放,文本转语音与即时声音克隆都不额外计费。需要更稳定的专属音色时,可以在平台内开通专属音色克隆,官方为其单独定价,训练素材要求为本人 1 至 10 段、合计不少于 20 分钟的录音。语音接口按字符计费,公开榜单标注的每百万字符价格为 30 美元。完整的套餐与额度以 HeyGen 官方公布为准。
HeyGen Voice 未提供模型权重下载,也不支持本地部署,只能通过 HeyGen 平台与官方接口调用。需要私有化部署或二次训练的团队,需要另寻开源方案。
HeyGen Voice 的常见问题
HeyGen Voice 是什么?
HeyGen Voice 是数字人视频平台 HeyGen 于 2026 年 10 月推出的自研语音合成模型,支持文本转语音与声音克隆,发布时在 Artificial Analysis 的 Controlled Voice 语音榜排名第一,并在 HeyGen 平台与官方接口内免费开放。
HeyGen Voice 支持哪些语言,怎么接入?
官方给出多语种的基础语言列表,其中包含中文。接入方式为官方语音接口,提供非流式与流式两条路径:非流式直接返回一段 44.1 千赫兹的 WAV 音频,流式以事件流逐段返回。单次文本长度在 1 到 5000 字符之间,每个工作区成员每分钟最多 30 次请求。
HeyGen Voice 是免费的吗?
官方说明该模型在 HeyGen 平台与官方接口内免费开放,文本转语音与即时声音克隆都不额外计费。需要专属音色时可以开通专属音色克隆,该服务按官方定价单独计费。
相关文章


 浙公网安备33010202004812号