

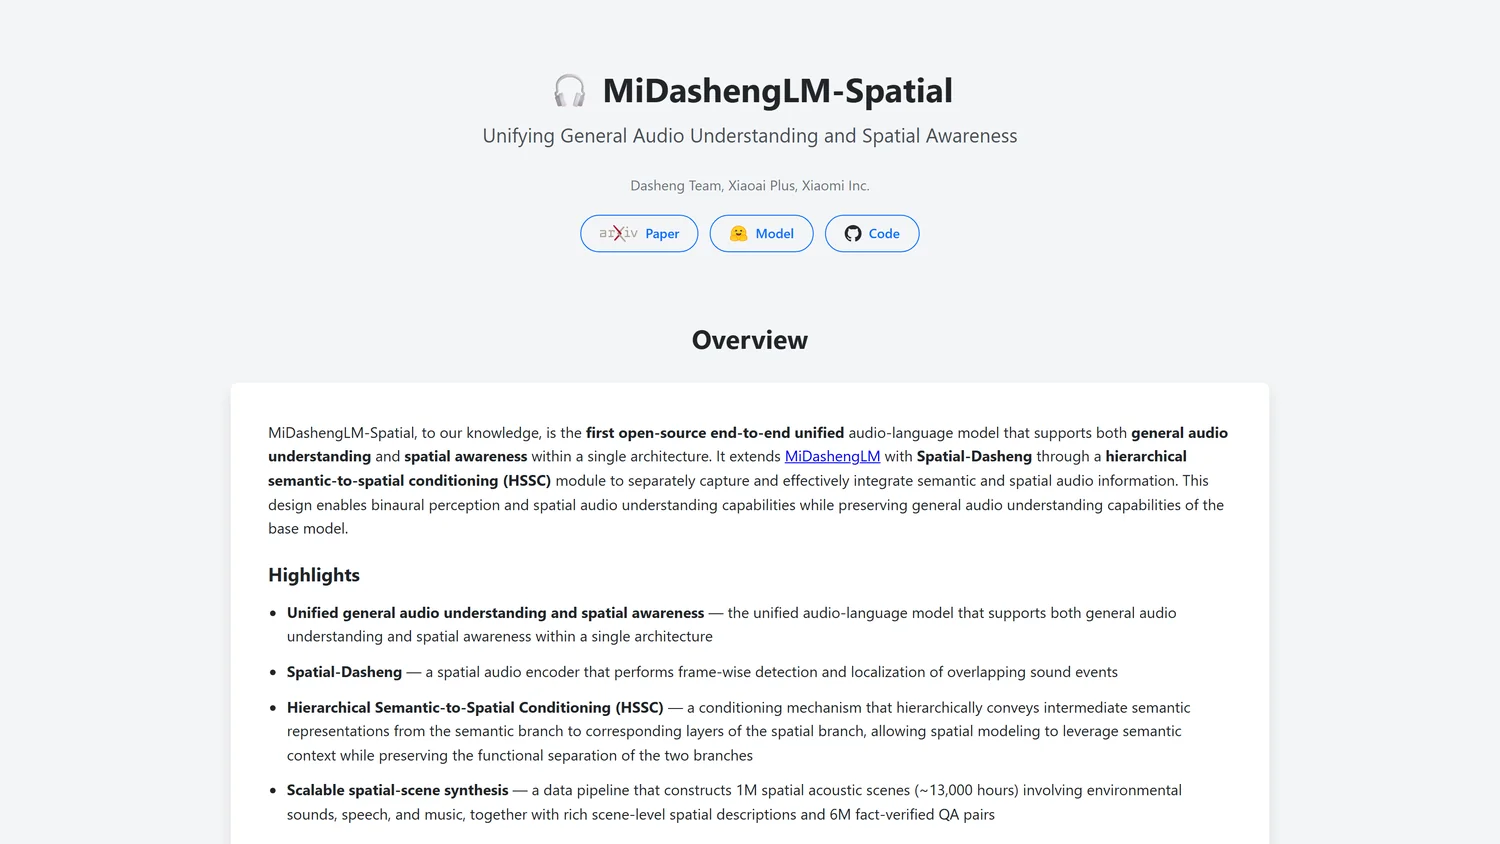
MiDashengLM-Spatial 是一款由小米 Dasheng 团队于 2026 年 10 月推出的开源端到端空间音频理解大模型,用于在识别声音内容的同时判断声源方位与空间分布,支持双耳音频输入与逐帧重叠声源定位,适用于智能家居声源识别、车内语音交互与环境音频内容结构化等场景。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 开源双耳空间音频理解模型 |
| 出品方 | 小米 Dasheng 团队 |
| 发布时间 | 2026 年 10 月 15 日 |
| 参数规模 | 约 8B(官方评测表标注) |
| 音频输入 | 双耳 (2, T),单声道可运行 |
| 核心架构 | Spatial-Dasheng + HSSC |
| 训练数据 | 100 万场景,约 1.3 万小时 |
| 开源许可 | Apache 2.0,可商用 |
| 计费方式 | 开源免费,自行部署 |
MiDashengLM-Spatial 的核心能力
MiDashengLM-Spatial 的改动集中在音频编码阶段:原有语义编码之外并行接入一条空间编码分支,再用分层条件机制把两侧表征对齐,两支共享同一语言侧解码器。官方定位为首个在单一架构内同时覆盖通用音频理解与空间感知的开源端到端音频语言模型。加入空间能力后,通用项未见明显回落。
Spatial-Dasheng 编码器逐帧定位重叠声源
该编码器按帧输出声源位置,而非为整段音频给出平均方位。STAR-Bench 空间推理子集上,官方准确率 70.3,同表单声道模型 24.2 至 47.0(最高为 Gemini-3.6-Flash),人工基线 73.7。声源移动或多路声音同时出现时,逐帧粒度决定能否分辨时序与左右。
HSSC 把语义中间层注入空间分支
HSSC 即分层语义到空间条件(hierarchical semantic-to-spatial conditioning),把语义分支的中间层表征传递到空间分支的对应层,让空间建模在保留功能边界的前提下利用语义上下文。两条分支保持功能分离,并非直接拼接两路特征。
空间场景合成数据管线
训练侧由数据管线生成 100 万个空间声学场景,累计约 13000 小时,覆盖环境声、语音与音乐,配套场景级空间描述与 600 万条经事实校验的问答对。双耳带标注数据稀缺是主要瓶颈:真实录音难以逐帧标出方位,合成提供了可扩展路径。音频长时记忆评测可参考 VoxMem。
通用音频能力未被空间任务挤出
单声道通用任务上,官方数据为 LibriSpeech test-clean 词错率 1.8、AudioCaps 62.8、MusicCaps 60.0,较前代多数持平或小幅提升。中文识别若需现成工具链,可对照 FunASR(阿里达摩院的中文语音识别工具),两者定位不同:前者面向双耳空间理解,后者面向中文转写。
MiDashengLM-Spatial 与同类音频语言模型的对比
下表取小米官方评测表中的三个对照对象,参数、音频格式与分数分别取自 STAR-Bench 空间推理子集与 MMAU-Pro 两张官方表,未作推算。
| 对比维度 | MiDashengLM-Spatial-7B | MOSS-Audio-8B-Instruct | Audio-Flamingo-Next-Instruct | BAT-7B |
|---|---|---|---|---|
| 参数规模 | 8B | 8B | 8B | 7B |
| 音频通道形式 | 双耳 | 单声道 | 单声道 | 双耳 |
| STAR-Bench 空间推理 | 70.3 | 41.7 | 24.2 | 0.0 |
| MMAU-Pro 全量得分 | 56.4 | 57.5 | 56.9 | 24.8 |
| MMAU-Pro 空间子集 | 55.4 | 26.8 | 37.2 | 23.7 |
| 声道互换双正确率(Channel-Swap ACR) | 72.6 | 0.0 | 0.0 | 0.0 |
Spatial 的 70.3 与表中单声道对照的 24.2 至 41.7 分处不同区间,官方完整表内单声道最高 47.0。该基准测试中其准确率明显更高,双耳输入与独立空间编码是主要技术差异之一,训练数据、架构与评测适配也会影响结果。MMAU-Pro 全量 56.4,接近 57.5、56.9,BAT-7B 为 24.8;空间子集 23.7 至 55.4。声道互换双正确率仅统计答案取决于左右方位的题项,要求原始与互换均答对。
同一路线下站内已收录 FireRedAudio,其定位偏纯内容侧,不含方位输出。
MiDashengLM-Spatial 的应用场景与适用人群
双耳输入的增量信息集中在方位与空间分布,适用面落在判断声源方向的环节。
- 智能家居声源识别:对门铃、玻璃破碎、水流等事件判断声源方位,可作为摄像头转向、多房间音频路由的技术基础。
- 车内与可穿戴设备交互:双麦克风阵列下可作为区分主副驾指令、降低跨座位误唤醒的技术基础,实际效果需结合设备验证。
- 空间音频内容标注:为双耳录音与空间音频素材生成带方位描述的文本,可用于素材检索与无障碍字幕探索。
适用人群:面向故障诊断与声学事件检测的算法团队、做端侧语音交互的产品团队,以及需要为音频素材生成结构化标注的内容团队。硬件侧需双通道采集,单通道设备无法获得方位输出。
MiDashengLM-Spatial 的使用方法
官方提供网页演示与本地部署两条路径:前者试听双耳样例,后者接入自有音频。权重合计约 33.5GB,配置标注 float32;实际内存与显存需求取决于权重精度、设备映射及推理配置,部署前应确认可用硬件资源。
普通用户入口
- 在线演示:在 MiDashengLM-Spatial 项目主页 的 Binaural Audio Demonstrations 区域切换样例,试听不同方位下的输出差异。
- 样例对照:演示页按 Best exp 等类别列出对照项,可观察同一场景不同问法的回答差异。
开发者接入
- 获取权重:从 Hugging Face 或 ModelScope 下载
mispeech/midashenglm-spatial,按用途选择。 - 安装依赖:
pip install torch torchaudio "transformers==4.57.6" einops,评测依赖另建环境。 - 加载模型:用
AutoModelForCausalLM.from_pretrained与AutoProcessor加载,并开启trust_remote_code。 - 准备音频:输入真实双耳
(2, T)音频,单声道虽可运行但不含方向信息。 - 组织输入:音频置于文本之前(训练时的顺序),参照
example/inference.py生成方位描述文本。
MiDashengLM-Spatial 的项目地址
- 项目主页:https://jinbo-hu.github.io/midashenglm-spatial-demo/
- GitHub 仓库:https://github.com/xiaomi-research/midashenglm-spatial
- Hugging Face 模型库:https://huggingface.co/mispeech/midashenglm-spatial
- ModelScope 模型库:https://modelscope.cn/models/midasheng/midashenglm-spatial
- 论文:https://arxiv.org/abs/2610.11156
MiDashengLM-Spatial 的价格与开源情况
MiDashengLM-Spatial 的权重与推理代码按 Apache 2.0 许可证发布,不设订阅费或按调用计费。成本集中在自建推理算力,官方未给出最低硬件配置数值。
开源平台覆盖 Hugging Face、ModelScope 与 GitHub,三处提供同一份权重与示例;仓库含 eval/ 目录的评测脚本,可复现上述两项结果。
MiDashengLM-Spatial 的常见问题
MiDashengLM-Spatial 与 MiDashengLM 有什么区别?
前者在 MiDashengLM 的语义编码之外增加 Spatial-Dasheng 空间编码分支,通过 HSSC 传递中间语义表征,因此可处理双耳输入并输出方位信息;通用音频理解保持前代水平,MMAU-Pro 全量分为 56.4。
输入单声道音频会怎样?
官方说明单声道音频仍可运行,可完成内容识别与音频描述,但缺少左右声道差异,无法给出可靠方位判断。
可以商用吗?
可以。仓库 LICENSE 与模型卡均标注 Apache 2.0,官方注明研究与商业用途均可。
MiDashengLM-Spatial-7B 的参数量是 7B 还是 8B?
官方模型名沿用 MiDashengLM-7B 的命名,评测表与模型卡的 Size 列均标注 8B,权重合计约 33.5GB。名称属命名惯例,参数量以官方标注为准。
相关文章

 浙公网安备33010202004812号